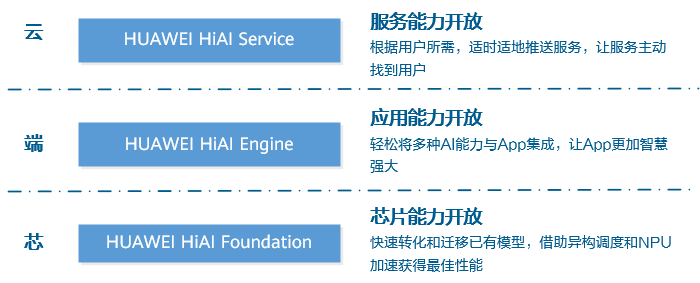
HUAWEI HiAI是面向移动终端的AI计算平台,构建“服务能力开放”、“应用能力开放”和“芯片能力开放”的三层AI生态。通过云端芯结合的三层开放平台为用户和开发者带来更好的移动体验。
其中HMS Toolkit可以快速实现用户已有AI模型转换和迁移,将模型移植到HUAWEI HiAI平台,以便更好的运行在华为海思芯片上,获得更好的性能。详细的HUAWEI HiAI Foundation的功能介绍可参见HUAWEI HiAI Foundation业务介绍。
HUAWEI HiAI Foundation提供的Model Creator功能,为您提供图像分类、文本分类、表格分类、物体检测等迁移学习能力,通过深度的机器学习和模型训练,可以很好的帮助用户对图片、文本等进行精确的识别。当前支持图像分类、文本分类和物体检测的能力,表格分类的能力即将上线,敬请期待。
Model Creator训练框架采用TensorFlow,推理框架采用HUAWEI HiAI DDK(NPU机型)、TensorFlow Lite(CPU机型)。

Model Creator不支持macOS M系列处理器(包括M1、M2、M3)。
图像分类
图像分类是利用迁移学习算法在具有良好泛化能力的基座分类模型的基础上,针对特定领域(如汽车、动物等)百张级数据进行分钟级的学习训练,自动生成图像分类识别的新模型,该生成的新模型可以自动识别图像所属的类别。HMS Toolkit还提供一键生成模型调用的API文件和模型调用Demo示例工程的功能,方便您在应用程序中快速验证和调用图像分类AI模型。
[h2]资源准备
使用图像分类迁移学习能力前,您需要按照要求准备用于训练的图像资源。
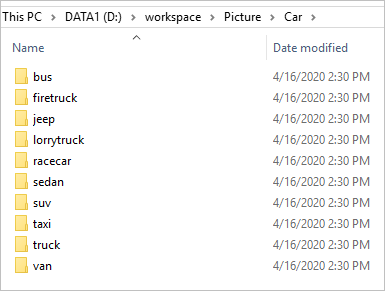
- 训练图像需要按照图像进行分类,在每个分类的目录下,放入合适的清晰图像。

图像存储路径和分类名称只能包含:字母、数字、下划线和中文,不能包括空格、特殊字符等符号。
- 图像分类数量约束:至少需要有2个以上的图像类别,上限为1000类。
- 每一类图像要求,训练数据:图像下限为10张。
- 图像格式只能是:bmp、jpg、jpeg、png和gif。
[h2]模型训练
- 在Coding Assistant中,选择。
- 迁移学习的能力,选择“Image”。
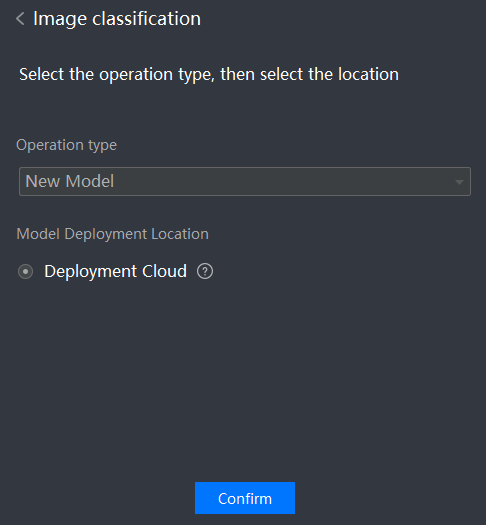
- 设置图像训练模型的操作类型和模型部署位置,然后点击“Confirm”。

点击“Confirm”后,HMS Toolkit会检测训练环境是否已准备完毕,如果环境未就绪,工具会自动进行下载和配置,请耐心等待。
- Operation type:操作类型,固定选择“New Model”。
- Model Deployment Location:模型部署位置,固定选择“Deployment Cloud”。使用要求:支持所有Android 4.1及以上的手机,内置NPU的华为手机可以利用硬件进行推理加速。
- 将分类好的图像文件夹拖入或添加到“Please select train image folder”,并设置生成的模型的存储路径(Output model file path)和训练参数(Train parameter)。训练参数保持默认值即可,如果您具有丰富的深度学习开发经验,您也可以适当调整训练参数来提升图像识别模型的精确度。
- Iteration count:迭代次数,默认值为100。
- Learning rate:学习速率,默认值为0.01。
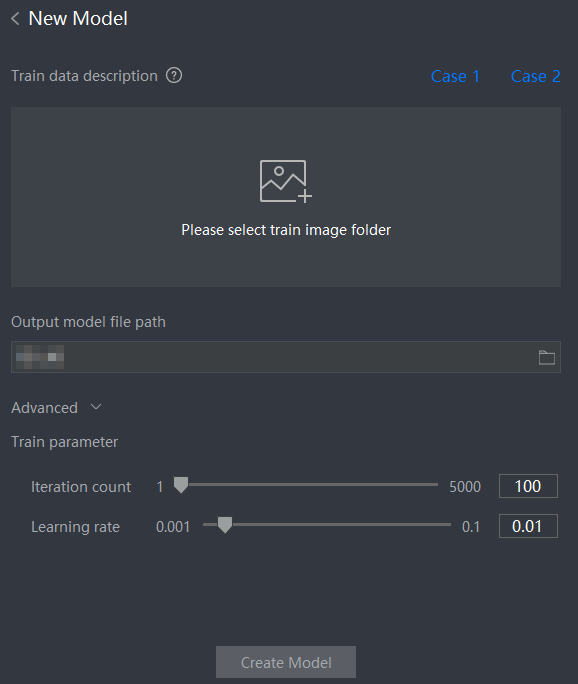
- 点击“Create Model”开始进行训练,生成图像分类识别模型。
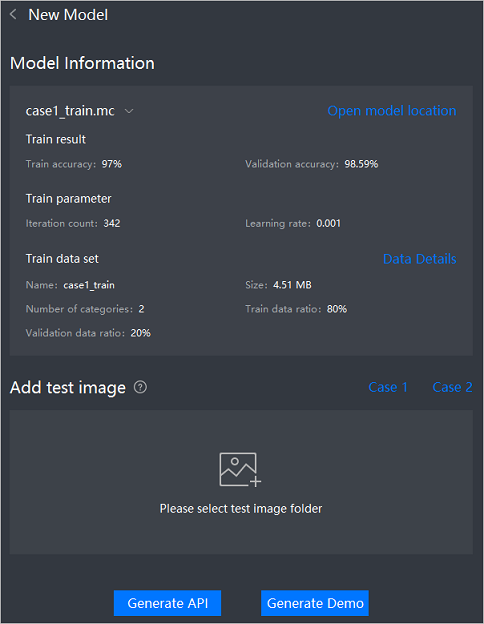
- 等待模型生成后,可以查看模型学习的结果(训练精度和验证精度)、对应的学习参数和训练数据等信息。
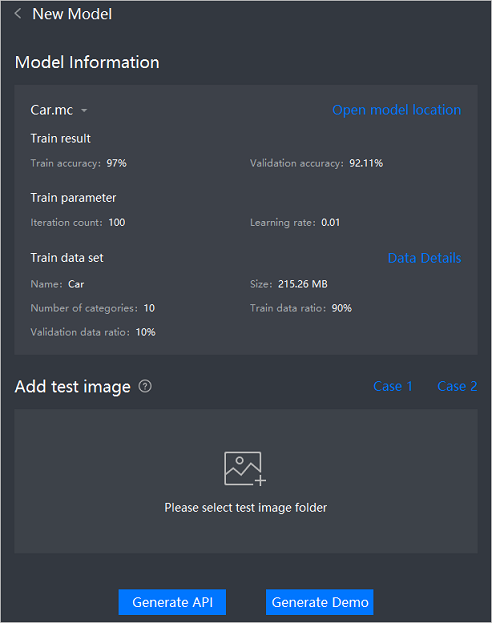
- 模型训练完成后,您还可以对模型进行验证,您只需要在“Add test image”的“Please select test image folder”加入需要测试的图像文件夹即可。工具会自动利用训练好的模型进行测试,并显示测试结果。
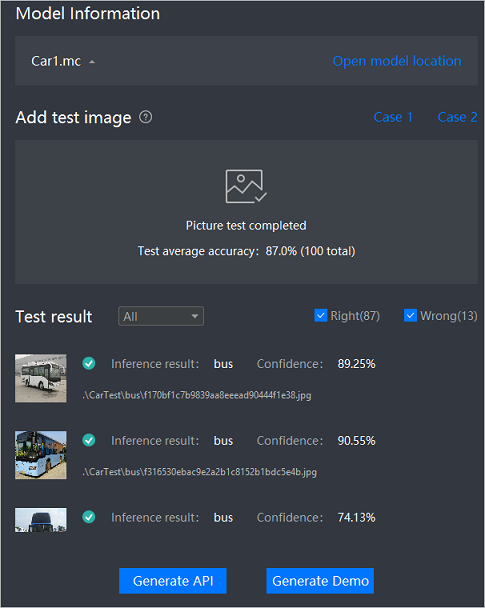
- 训练模型结果确认可用后,您可以选择生成API(Generate API)和生成Demo工程(Generate Demo),下面将对这二者进行简要说明。
- Generate API:在模型训练结果中点击“Generate API”,HMS Toolkit可以将训练模型的依赖包、模型文件、API接口示例源文件自动添加到工程的相应目录中,并自动在模块的“build.gradle”文件中增加依赖信息。接下来您可以在应用程序中通过调用图像分类识别模型对应的API接口,即可集成图像分类识别的能力。
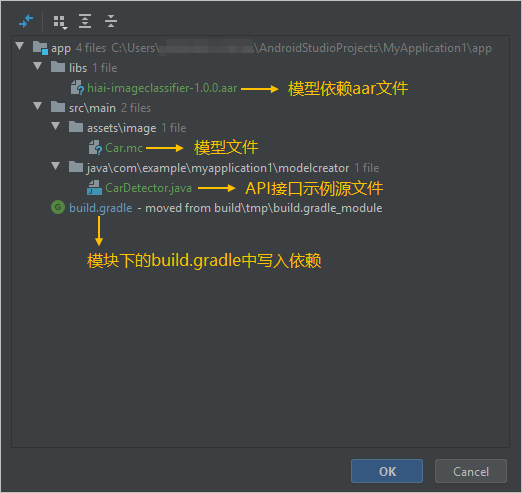
- Generate Demo:在模型训练结果中点击“Generate Demo”,HMS Toolkit会自动生成Demo工程,该工程自动集成了该训练后的图像分类识别模型,您可以直接运行和编译该Demo工程,生成APK文件在模拟器或者真实设备上运行,查看图像分类识别的应用效果。
- Generate API:在模型训练结果中点击“Generate API”,HMS Toolkit可以将训练模型的依赖包、模型文件、API接口示例源文件自动添加到工程的相应目录中,并自动在模块的“build.gradle”文件中增加依赖信息。接下来您可以在应用程序中通过调用图像分类识别模型对应的API接口,即可集成图像分类识别的能力。
文本分类
文本分类是利用迁移学习算法在具有良好泛化能力的基座分类模型的基础上,针对特定领域(如体育、娱乐、教育等)的文本数据进行分钟级的学习训练,自动生成文本分类识别的新模型。该生成的新模型可以自动识别文字所属的类别。HMS Toolkit还提供一键生成模型调用的API文件和模型调用的Demo示例工程的功能,方便您在应用程序中快速验证和调用文本分类新模型。
[h2]资源准备
- JSON格式训练文本:JSON文本格式为[{"label": " ", "text": " "},{"label": " ", "text": " "}]。
- txt格式训练文本:按照文档的类别进行分类,每一类使用txt文档存放文本内容。
- 文本存储路径和分类名称只能包含:字母、数字、下划线和中文,不能包括空格、特殊字符等符号。
- 文本类别数量约束:至少需要有2个以上的文本类别。
- 文本数量的约束:每一类别的文本数量至少20条,数量越多新模型的精度越高。
- 文本大小的约束:文本资源不能超过10 MB。
- 文本的编码格式:只能为UTF-8(支持unicode和GBK格式编码转换)。
[h2]模型训练
- 在Coding Assistant中,选择。
- 迁移学习的能力,选择“Text”。
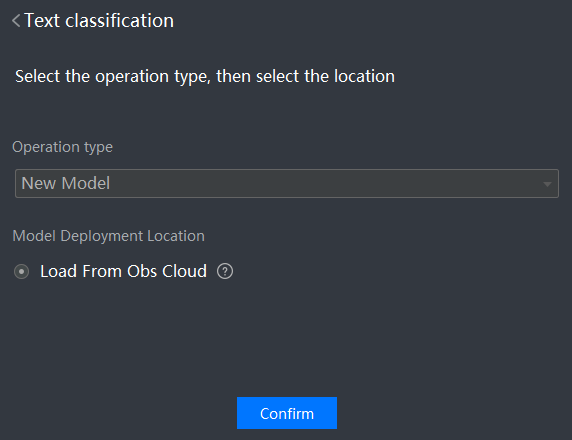
- 设置文本训练模型的操作类型(固定选择“New Model”)和模型部署位置(固定选择“Load From Obs Cloud”),然后点击“Confirm”。

点击“Confirm”后,HMS Toolkit会检测训练环境是否已准备完毕,如果环境未就绪,工具会自动进行下载和配置,请耐心等待。
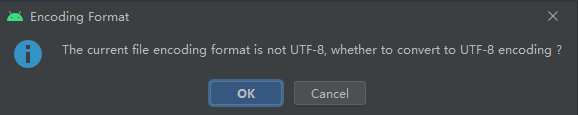
- 将分类好的文本资源(JSON文本或文本文件夹)拖入或添加到“Please select train text dataset”,如果您的文本资源编码格式不是UTF-8,则会有以下弹窗,点击“OK”进行格式编码转换(目前仅支持unicode和GBK格式编码转换)。转换完成后,请选择“文件夹名”和“文件类型”,点击“Confirm”。
 然后设置文本资源的语言类型(Language type)、生成的模型的存储路径(Output model file path)和训练参数(Train parameter)。训练参数保持默认值即可,如果您具有丰富的深度学习开发经验,您也可以适当调整训练参数来提升文本识别模型的精确度。
- High precision mode:勾选后生成高精度的训练模型。
- Iteration count:迭代次数,默认值为1000。
- Learning rate:学习速率,默认值为0.01。
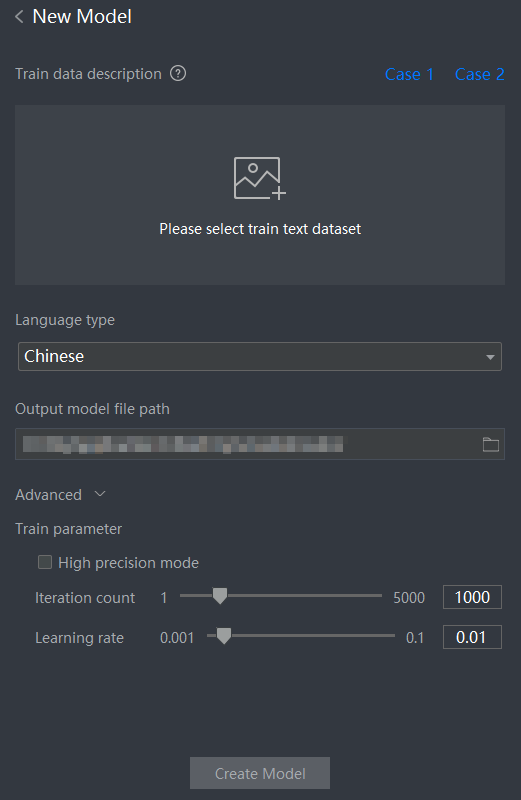
- 点击“Create Model”开始进行训练,生成模型。
- 等待模型生成后,可以查看模型学习的结果(训练精度和验证精度)、对应的学习参数和训练数据等信息。
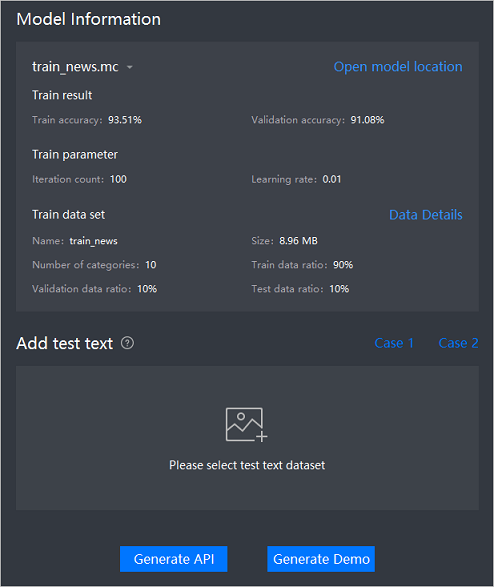
- 模型训练完成后,您还可以对模型进行验证,您只需要在“Add test text”的“Please select test text dateset”加入需要测试的文本资源(JSON文本或文本文件夹)即可。工具会自动利用训练好的模型进行测试,并显示测试结果。
- 训练模型结果确认可用后,您可以选择生成API(Generate API)和生成Demo工程(Generate Demo),下面将对这二者进行简要说明。
- Generate API:在模型训练结果中点击“Generate API”,HMS Toolkit可以将训练模型的依赖包、模型文件、API接口自动添加到工程的相应目录中,并自动在模块的“build.gradle”文件中增加依赖信息。接下来您可以在应用程序中通过调用文本识别模型对应的API接口示例源文件,即可集成文本分类识别能力。
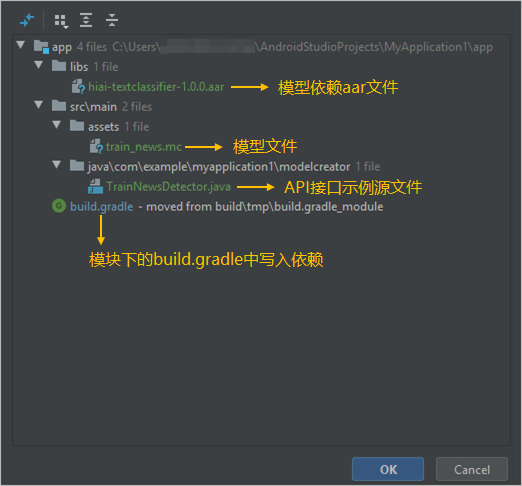
- Generate Demo:在模型训练结果中点击“Generate Demo”,HMS Toolkit会自动生成Demo工程,该工程自动集成了该训练后的文本分类识别模型,您可以直接运行和编译该Demo工程,生成APK文件在模拟器或者真实设备上运行,查看文本分类识别的应用效果。
- Generate API:在模型训练结果中点击“Generate API”,HMS Toolkit可以将训练模型的依赖包、模型文件、API接口自动添加到工程的相应目录中,并自动在模块的“build.gradle”文件中增加依赖信息。接下来您可以在应用程序中通过调用文本识别模型对应的API接口示例源文件,即可集成文本分类识别能力。
弱监督目标检测
弱监督目标检测是利用迁移学习算法在具有良好泛化能力的基座分类模型的基础上,针对易于识别的特定分类的图片进行分钟级的学习训练,自动分析图片的特征,从而自动从识别模型中提取出图片中的目标物体,并在图片中标识出来。HMS Toolkit还提供一键生成模型调用的API文件和模型调用Demo示例工程的功能,方便您在应用程序中快速验证和调用图像分类AI模型。
[h2]资源准备
- 训练图像需要按照图像进行分类,在每个分类的目录下,放入合适的清晰图像。

图像存储路径和分类名称只能包含:字母、数字、下划线和中文,不能包括空格、特殊字符等符号。
- 训练数据集中,不同类别下的样本数据,建议图片的背景风格保持一致。
- 图像分类数量约束:至少需要有2个以上的图像类别。
- 每一类图像至少需要20张,多于200张训练效果更佳。
- 图像格式只能是bmp、jpg、jpeg、png和gif。
[h2]模型训练
- 在Coding Assistant中,选择。
- 迁移学习的能力,选择“Object”。
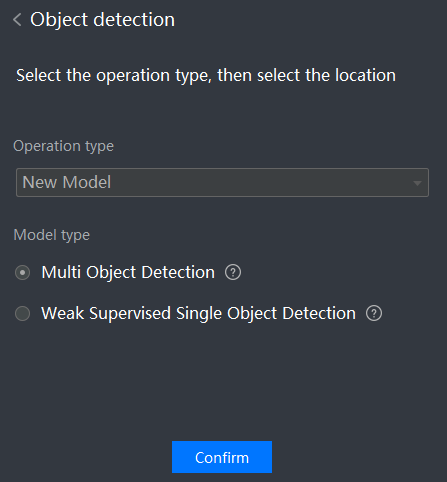
- 设置图像训练模型的操作类型和模型类型,然后点击“Confirm”。

点击“Confirm”后,HMS Toolkit会检测训练环境是否已准备完毕,如果环境未就绪,工具会自动进行下载和配置,请耐心等待。
- Operation type:操作类型,固定选择“New Model”。
- Model type:模型类型,请根据实际场景进行选择。
- Multi Object Detection:弱监督多目标检测。
- Weak Supervised Single Object Detection:弱监督单目标检测。
- 将分类好的图像文件夹拖入或添加到“Please select train image folder”。
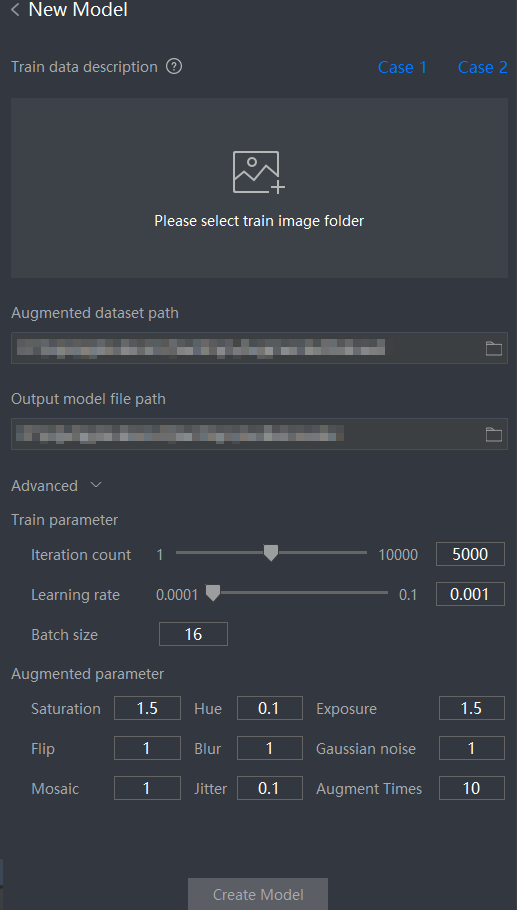
- 当“Model type”选择“Multi Object Detection”时,需要设置经过增强处理后的数据集路径(Augmented dataset path)、生成模型的存储路径(Output model file path)、训练参数(Train parameter)和增强处理数据集参数(Augmented parameter)。训练参数和增强处理数据集参数保持默认值即可,如果您具有丰富的深度学习开发经验,您也可以做适当调整来提升图像识别模型的精确度。
- Iteration count:迭代次数,默认值为5000。
- Learning rate:学习速率,默认值为0.001。
- Batch size:批次大小,默认值为16。
- Saturation:图像饱和度,支持整数和小数(最多两位小数),默认值为1.5。
- Hue:图像色调,支持整数和小数(最多两位小数),默认值为0.1。
- Exposure:图像曝光量,支持整数和小数(最多两位小数),默认值为1.5。
- Flip:图像翻转,取值只能为0或1,默认值为1。
- Blur:图像模糊,只支持整数,默认值为1。
- Gaussian noise:图像高斯噪声,只支持整数,默认值为1。
- Mosaic:图像马赛克,只支持整数,默认值为1。
- Jitter:随机调整宽高比的范围,支持0到1之间的整数或小数(最多两位小数),默认值为0.1。
- Augment Times:数据增强次数,每增强一次,数据集增加一倍,只支持整数,默认值为10。
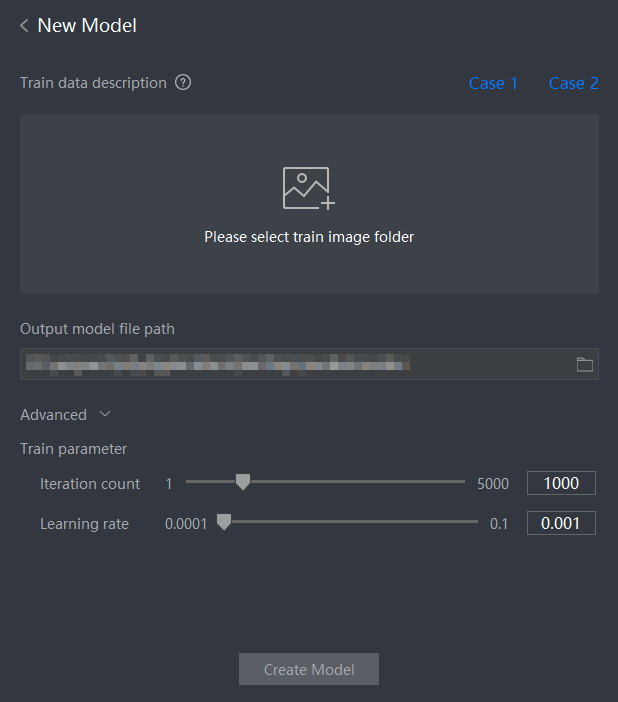
- 当“Model type”选择“Weak Supervised Single Object Detection”时,需要设置生成模型的存储路径(Output model file path)和训练参数(Train parameter)。训练参数保持默认值即可,如果您具有丰富的深度学习开发经验,您也可以适当调整训练参数来提升图像识别模型的精确度。
- Iteration count:迭代次数,默认值为1000。
- Learning rate:学习速率,默认值为0.001。
- 当“Model type”选择“Multi Object Detection”时,需要设置经过增强处理后的数据集路径(Augmented dataset path)、生成模型的存储路径(Output model file path)、训练参数(Train parameter)和增强处理数据集参数(Augmented parameter)。训练参数和增强处理数据集参数保持默认值即可,如果您具有丰富的深度学习开发经验,您也可以做适当调整来提升图像识别模型的精确度。
- 点击“Create Model”开始进行训练,生成图像分类识别模型。
- 等待模型生成后,可以查看模型学习的结果(训练精度和验证精度)、对应的学习参数和训练数据等信息。
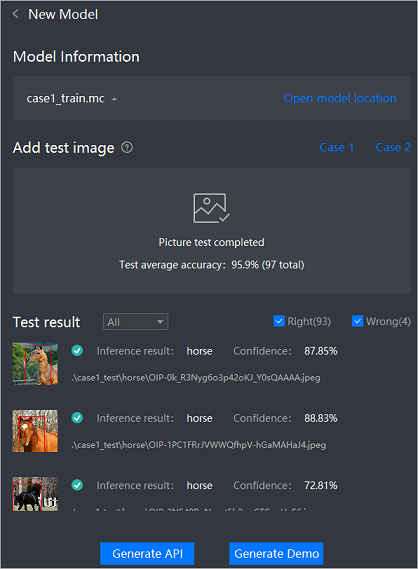
- 模型训练完成后,您还可以对模型进行验证,您只需要在“Add test image”的“Please select test image folder”加入需要测试的图像文件夹(弱监督单目标检测)或单个图片(弱监督多目标检测)即可。工具会自动利用训练好的模型进行测试,并显示测试结果。
- 训练模型结果确认可用后,您可以选择生成API(Generate API)和生成Demo工程(Generate Demo),下面将对这二者进行简要说明。
- Generate API:在模型训练结果中点击“Generate API”,HMS Toolkit可以将训练模型的依赖包、模型文件、API接口示例源文件自动添加到工程的相应目录中,并自动在模块的“build.gradle”文件中增加依赖信息。接下来您可以在应用程序中通过调用弱监督目标检测模型对应的API接口,即可集成弱监督目标检测的能力。
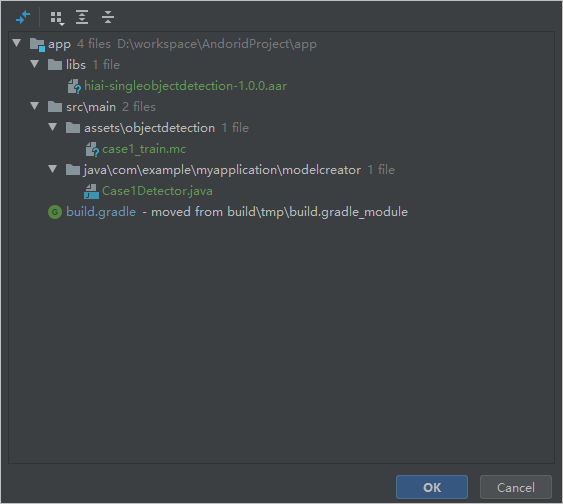
- Generate Demo:在模型训练结果中点击“Generate Demo”,HMS Toolkit会自动生成Demo工程,该工程自动集成了该训练后的弱监督目标检测模型,您可以直接运行和编译该Demo工程,生成APK文件在模拟器或者真实设备上运行,查看弱监督目标检测的应用效果。
- Generate API:在模型训练结果中点击“Generate API”,HMS Toolkit可以将训练模型的依赖包、模型文件、API接口示例源文件自动添加到工程的相应目录中,并自动在模块的“build.gradle”文件中增加依赖信息。接下来您可以在应用程序中通过调用弱监督目标检测模型对应的API接口,即可集成弱监督目标检测的能力。
声音分类
声音分类是利用迁移学习算法在具有良好泛化能力的基座分类模型的基础上,针对特定领域的声音数据进行分钟级的学习训练,自动生成声音分类识别的新模型。该生成的新模型可以自动识别声音所属的类别。HMS Toolkit还提供一键生成模型调用的Demo示例工程的功能,方便你在应用程序中快速验证和调用声音分类新模型。

Sound Classification仅支持Windows系统。
[h2]资源准备
- 声音训练资源存储路径和分类名称只能包含:字母、数字、下划线和中文,不能包括空格、特殊字符等符号。
- 类别数量约束:至少需要有2个以上的声音类别。
- 单类数量的约束:每一类别的声音文件数量至少10条,数量越多新模型的精度越高。
- 存储大小的约束:声音资源不能超过20 MB。声音的编码格式:只能为 WAV 格式文件。
[h2]模型训练
- 在Coding Assistant中,选择“AI > Model Creator”。
- 迁移学习的能力,选择“Sound”。
- 设置文本训练模型的操作类型(固定选择“New Model”)和模型部署位置(固定选择“DeploymentApp”),然后点击“Confirm”。

点击“Confirm”后,HMS Toolkit会检测训练环境是否已准备完毕,如果环境未就绪,工具会自动进行下载和配置,请耐心等待。
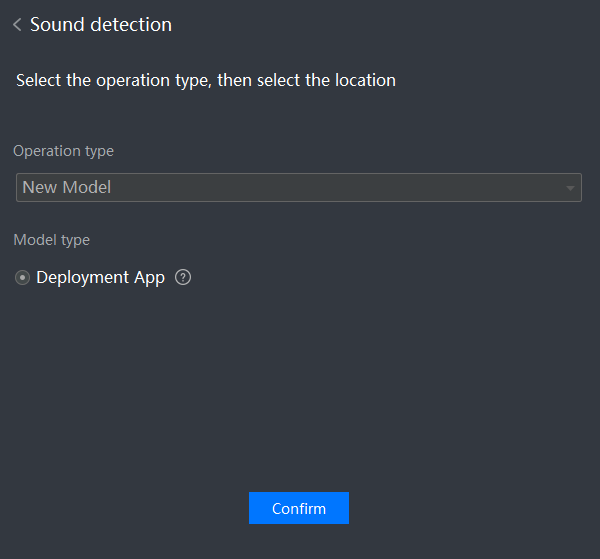
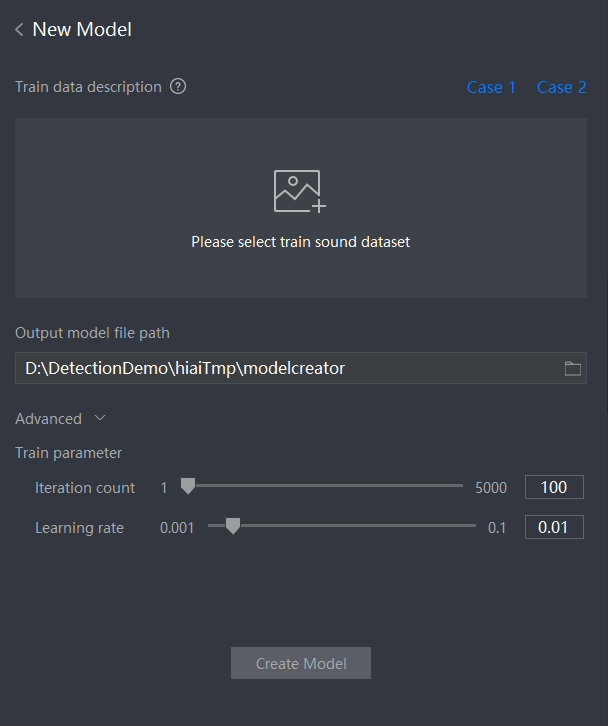
- 将分类好的声音资源(声音文件夹)拖入或添加到 “Please select train sound dataset“,然后设置训练参数:
- 点击 ”Create Model“ 开始训练,生成模型。
- 等待模型生成后,可以查看模型学习的结果(训练精度和验证精度),对应的学习参数和训练数据等信息。
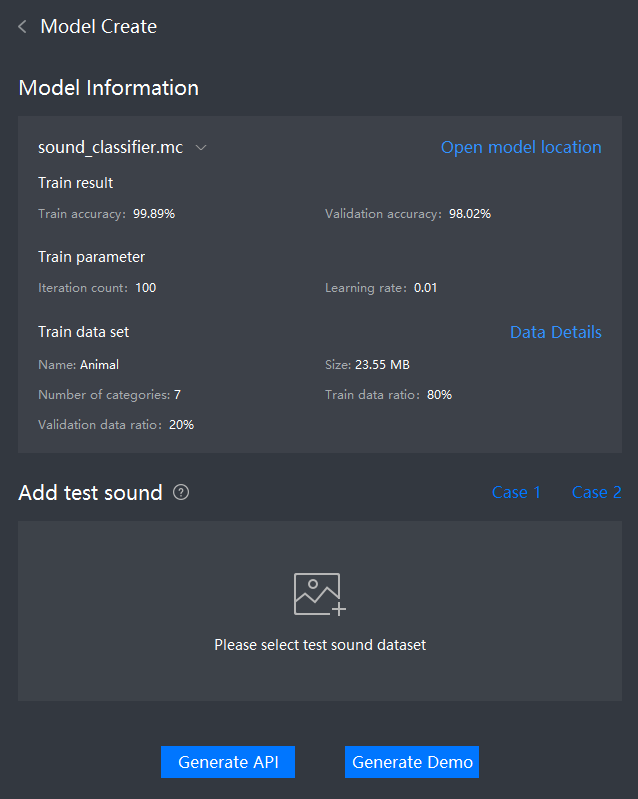
- 模型训练完成后,你还可以对模型进行验证,你只需要在 ”Add test sound" 的 “Please select testsound dataset” 加入需要测试的声音资源即可。工具会利用训练好的模型进行测试,并展示测试结果。
- 训练模型结果确认可用后,你可以选择生成 API (Generate Api) 和生成Demo工程(GenerateDemo), 下面将进行简要的说明。
- Generate API: 在模型训练结果页中点击 “Generate API”, HMS Toolkit可以将训练模型的依赖包,模型文件,API接口自动添加到工程的相应目录中,并自动在模块的“build.gradle"文件中增加依赖信息。接下来你可以在应用程序中通过调用声音识别模型对应的API接口示例源文件,即可集成声音分类识别能力。
- Generate Demo: 在模型训练结果页中点击 “Generate Demo”, HMS Toolkit会自动生成Demo工程,该工程自动集成了训练后的声音分类模型,你可以直接编译和运行该 Demo 工程,生成APK文件在模拟器或者真实设备上运行,查看识别效果。