本文native内存指的主要是代码中通过malloc、new、realloc、calloc函数申请的堆内存和通过mmap映射内存地址空间,native内存是进程内存中占比较高,也是容易出泄漏问题的一种内存。分析native内存分布与占用问题需要借助工具,以及一些测试,分析技巧。DevEco Studio Profiler插件的Allocation模板,通过对基础库的malloc,free等函数进行插桩记录,可以抓取native内存分配释放记录,包括大小和堆栈等数据,用以分析native内存的占用问题。
DevEco堆内存分配/释放抓栈说明
DevEco Studio Profiler插件的Allocation模板可以帮助用户分析堆内存分配、释放的信息,memory mapping信息,调用栈信息。这些信息中包括已释放内存和未释放内存。具体使用步骤如下:
- 打开IDE后,选择Profiler;
- 点击Allocation选项;
- 点击Create Session创建录制频道;
- 配置过滤选项, 选择Native Allocation;
- 配置抓栈属性;
- 点击录制按钮,开启调优。
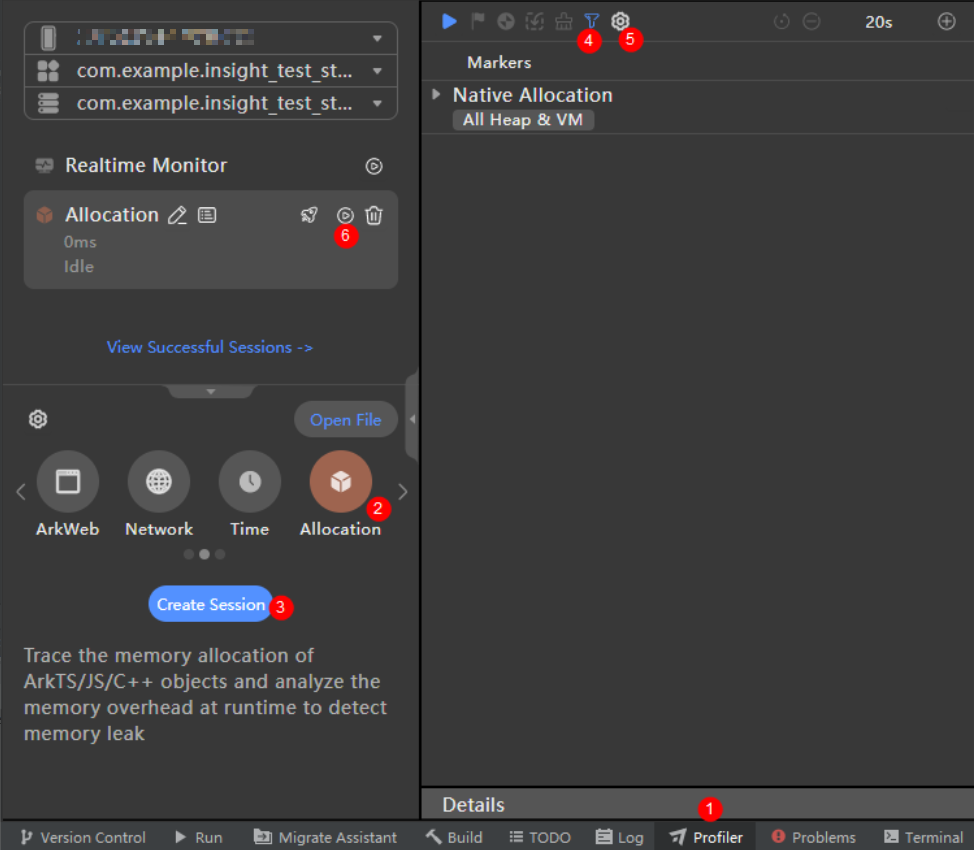

- 谨慎同时录制ArkTS Allocation:由于Native Allocation和ArkTS Allocation同时录制会出现性能问题,建议在录制Native Allocation之前在第四步过滤选项中设置过滤ArkTS Allocation。
- 无法录制非debug版本应用:当前规格仅支持抓取debug版本应用的native栈。如果抓取非debug版本应用,则获取不到栈信息。
- 留意录制按钮旁边的小火箭:选中后,调优时进程会重启。如果需要录制进程从启动开始分配native内存情况,可以在点击录制按钮前选中小火箭。
DevEco Studio Profiler插件Allocation模板抓栈功能配置属性说明
针对上节操作中第五步配置属性,对各属性进行介绍
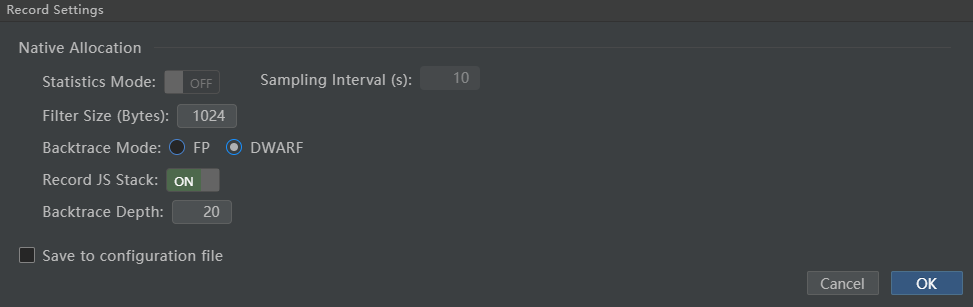
- Statistics Mode:开启统计模式,此处表示10秒之内相同的调用栈会被累计在一起,在IDE上只显示一个栈,及出现次数,还有该栈总共未释放的内存。不会记录单次调用栈。关闭统计模式时,会详细记录每次内存分配栈出现的时间。对性能要求比较高的场景,可以选择开启统计模式。
- Sampling Intervals:开启统计模式按钮才使用的参数,表示统计模式的统计间隔。
- Filter Size:此处表示小于1024byte的分配内存操作会被过滤,不被记录。
- Backtrace Mode:表示回栈方式。开启FP回栈时,回栈效率高,性能较好。开启DWARF回栈时,在寄存器复用及编译优化等场景无法使用fp回栈时能够精确入栈、出栈。
- Record JS Stack:开启JS回栈。可以抓到从JS层走到Native层分配堆内存的调用链。
- Backtrace Depth:回栈深度,DWARF回栈时表示栈的总大小,FP回栈时表示native栈大小。
在分析DevEco Studio Profiler插件的Allocation分析模板的数据时,通常框选All Heap一栏来分析堆内存数据。All Anonymous VM一栏展示的是匿名内存分配,通常是mmap、munmap函数申请和释放的内存,这些大都是进程自动进行的,开发人员难以控制。
内存分配统计信息
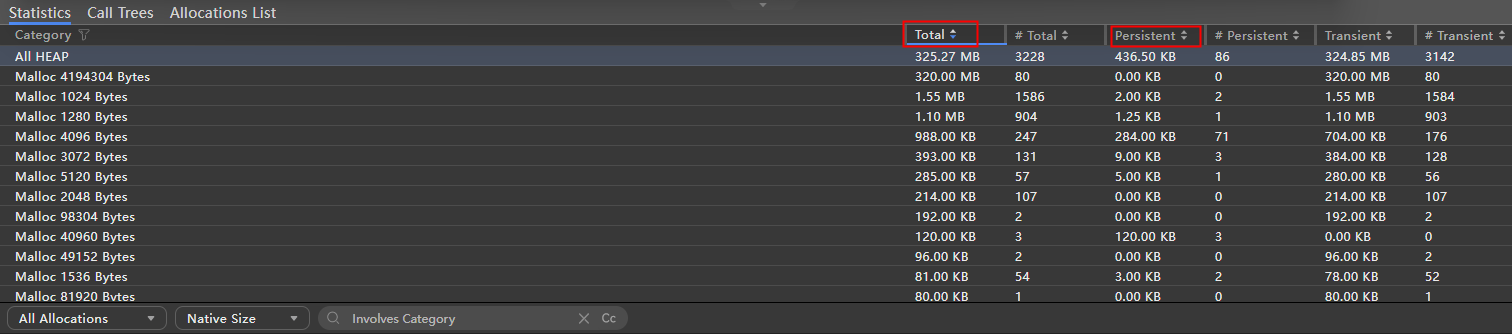
选中Statistics这一栏后,可以看到抓栈期间进程分配Native内存的大小。可以在Total一栏中看到进程分配的总内存。
在Persistent一栏看到进程分配但未释放的总内存。除此之外,还可以看到内存分配size聚类的信息,并根据需要进行排序查看。
调用栈信息
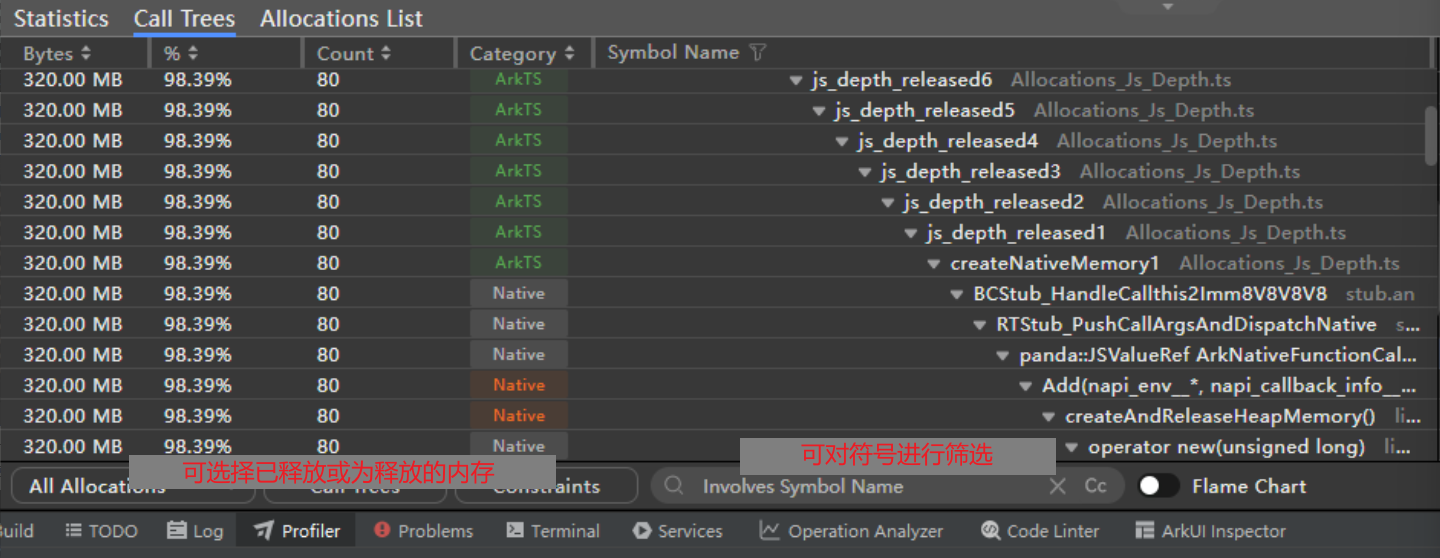
选中Call Trees这一栏后,可以展开需要分析的栈,栈从上到下即调用链的顺序,栈底一般是operator new函数。下图中绿色部分为ArkTS栈,在开启Record JS Stack开关后可以抓到。可以根据需要选择展示已释放或者未释放部分的内存,并可以搜索需要过滤的符号。
统计模式信息
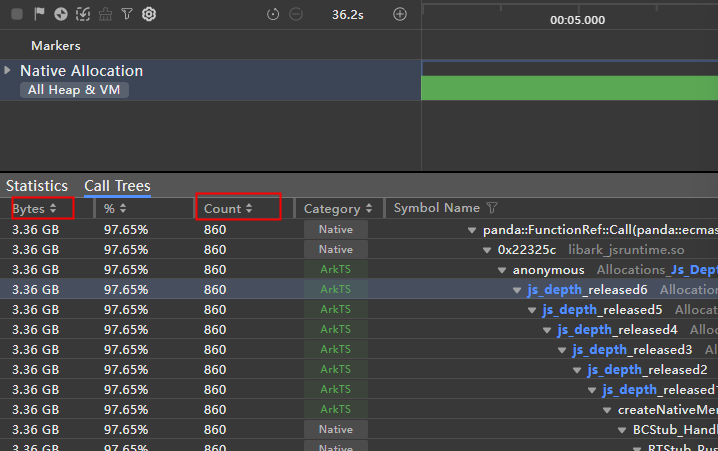
在使用统计模式时,抓取的信息进行了精简化,不会展示每次调用栈具体时间,而是周期性聚类展示。所以会展示周期内Native内存分配变化情况。可以通过下图Count看到栈出现的总次数和总大小。
使用Allocation模板抓到trace之后,可以参考以下分析方式。
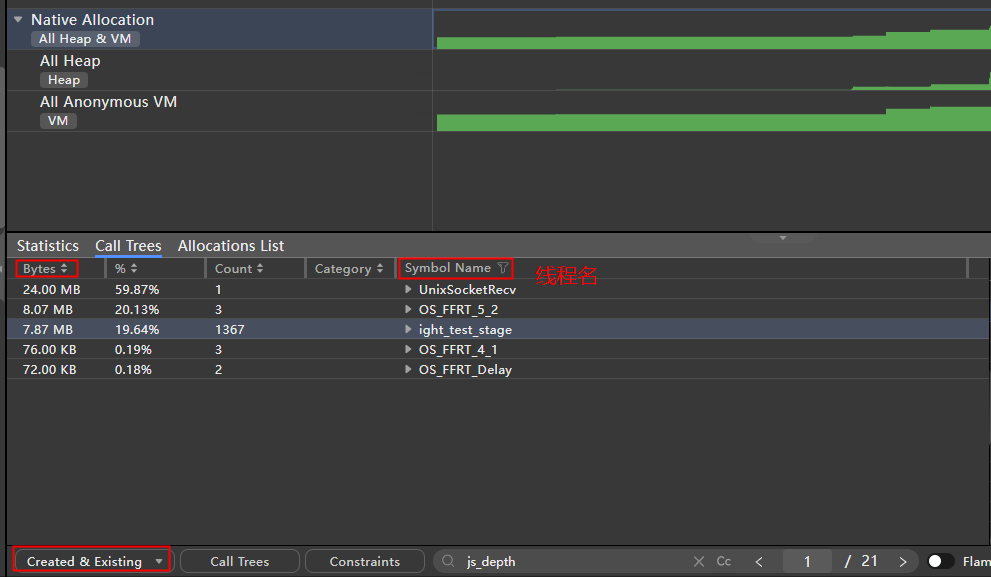
- 内存分配Top线程分析:选择Created & Existing后,在Call Trees一栏可以看到不同线程未释放内存的情况,可以从内存泄漏较多的线程入手进行分析。在Allocation List中可以搜索线程名来进一步分析调用栈。
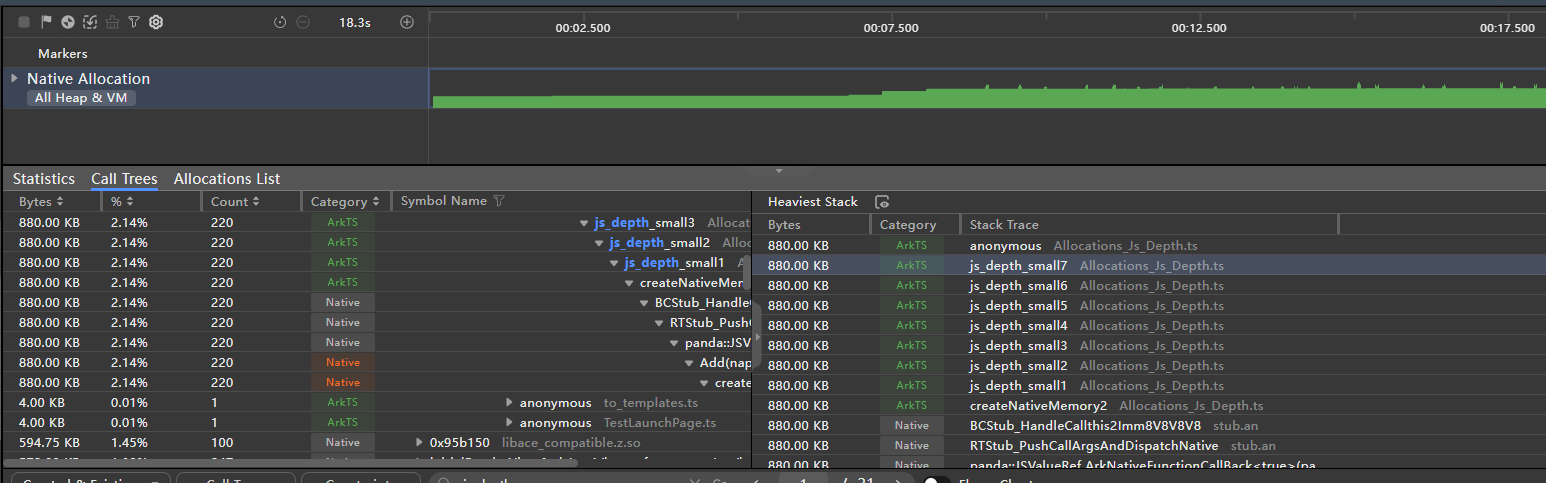
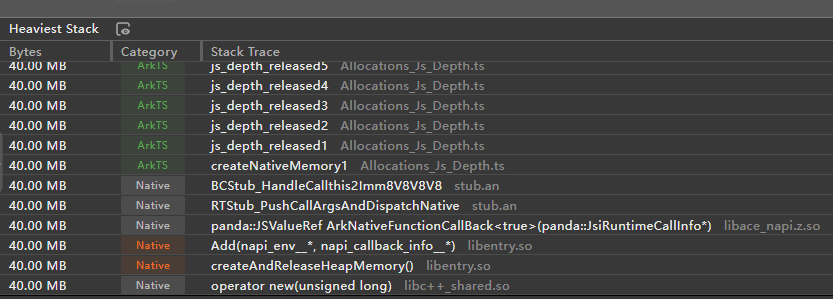
当应用侧ArkTS/JS的代码逻辑触发napi调用然后在native层有内存分配的情况下,ArkTS/JS栈会传递到profiler侧和native栈进行缝合,展示出一套完整的调用链。所以profiler不仅可以用来分析内存泄漏问题,还可以用来分析业务逻辑和调用关系。
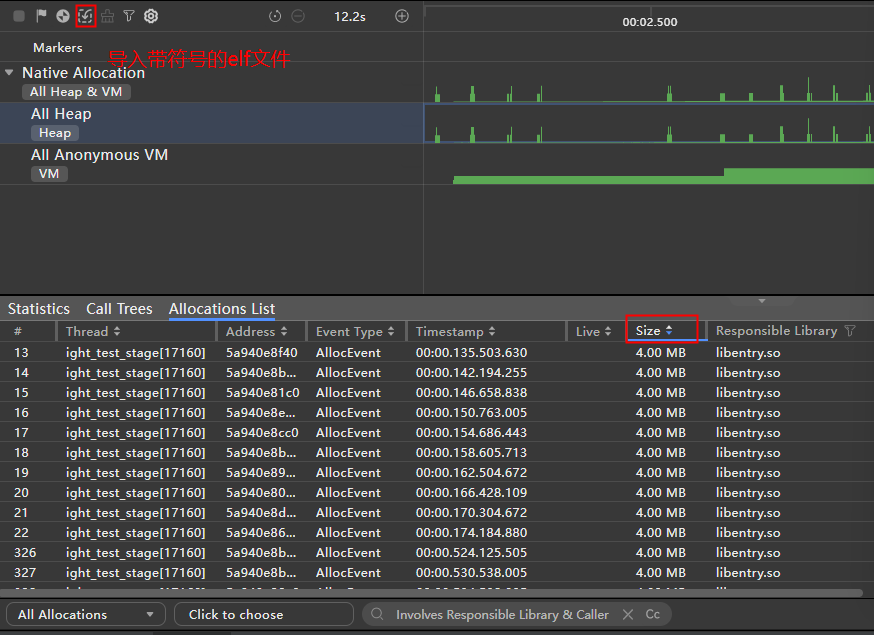
- 内存分配Top调用栈分析:在使用非统计模式抓栈时,在Allocations List一栏可以对所有调用栈分配内存的大小进行排序,着重分析分配内存较多的栈。如果调用栈中某些帧只有地址,没有符号,则需要导入带符号的elf文件,然后重新解析。导入的按钮在过滤选项旁边。
- 分析具体调用链:在Call Trees树状图中或者Allocations List中,找到需要分析的调用栈后,可以在右侧Heaviest Stack中清晰看到具体的调用链,调用链从上到下展示了调用逻辑。
问题:为什么抓取非debug版本应用时获取不到数据?
解答: 由于安全限制,profiler不支持抓非debug版本应用。
问题:为什么Allocation分析模板抓到的堆内存大小比hidumper看到的native heap数值要小?
解答:Allocation分析模板采集到的是目标进程用户态通过malloc、mmap等堆内存分配函数分配内存的栈。这些内存延迟释放,线程缓存等场景下的内存分配不被统计,但仍包含在smaps的native heap中。
问题:为什么非aarch64架构设备使用Allocation分析模板的fp回栈方式抓取的数据有异常?
解答:Allocation分析模板的fp回栈暂不支持调优非aarch64架构的设备。