文档开发者中心
我的
HarmonyOS SDK

HarmonyOS SDK开发官方交流专区。这里有涵盖应用框架、应用服务、系统、媒体、图形、AI六大领域所有开放能力特性的一指禅、产品专家1to1在线交流,帮助您解决鸿蒙原生应用开发中遇到的常见问题,高效打造出色的鸿蒙原生应用与元服务。

关注
订阅
推荐
最热
最新
其他
已解决
未解决
在开发中同时使用Scroll和List时,滚动事件经常互相干扰,导致滑动不流畅或误触。请问有哪些方法可以合理配置手势优先级,避免冲突?

评论3

浏览 18

发布于1小时前
在使用ArkUI开发时,List组件在数据量较大或列表项内容复杂时出现滚动卡顿现象,想请教大家通常如何定位性能瓶颈?是否有常用的性能分析工具或优化手段可以分享?

评论4

浏览 16

发布于2小时前
在 ArkUI 中封装了自定义弹窗组件,从详情页返回上一页后,弹窗内部的状态(如输入内容、选中项)没有自动重置,导致再次打开时仍保留旧数据。请问除了手动在 aboutToDisappear 里逐项清理外,有没有更规范的做法来管理组件级状态和生命周期?想请教大家通常是怎么处理这类场景的。

评论7

浏览 46

发布于昨天01:28
在鸿蒙应用中使用 List 承载复杂列表项时,快速滑动过程中偶现子控件的点击事件没有响应,点击后没有进入预期页面。想请教大家这种情况通常和列表复用、事件冒泡、子控件手势冲突有关吗?有哪些排查方向可以避免误触或漏触?

评论9

浏览 51

发布于昨天01:27
我在做一个信息流页面,里面嵌套了多层自定义组件,有一堆 @Monitor 和 @Watch 在监听状态变化做局部刷新。为了优化性能,给一些非激活页面的子组件加了 freezeWhenInactive: true,想让它们在后台不响应状态更新、减少无谓的 UI 刷新。结果加了之后出现两个很尴尬的现象:现象一:@Monitor 彻底不执行了。 组件明明已经回到激活状态,状态变量也确实变了,但 @Monitor 就是不回调,关联的节点也不刷新。一开始以为是 @Monitor 写错了,去掉 freezeWhenInactive 就恢复正常,所以问题锁定在冻结上。现象二:嵌套组件的解冻行为对不上。 我在父组件上开了冻结,子组件也跟着不刷新;但有时候又反过来,父组件明明已经激活了,嵌套在里面的某个子组件状态还是“冻着”的,数据停在旧值。后来查了一下 ArkUI 的 Changelog,才发现从某个版本开始,组件冻结的行为变严格了:在“支持冻结的组件嵌套使用的解冻场景”“V2 自定义组件的解冻场景”“Repeat VirtualScroll 的复用场景”下,以前冻结可能“实际未生效”,所以状态变量还能刷新、@Watch/@Monitor 还能执行;变更之后,这些场景下冻结真正生效了,状态变量不再刷新,@Watch/@Monitor 也不会执行。官方给的适配建议也很直接:如果确实需要刷新缓存中的数据,就把 freezeWhenInactive 关掉。我现在卡在几个地方:“非激活状态”的边界到底怎么判断? 是页面不可见就算非激活,还是组件被其他组件完全遮挡才算?如果我的页面在 Tabs 里被切走、但组件树还活着,这时候开了冻结,回到激活状态后 @Monitor 会不会有“漏掉”的变化需要手动补一次?嵌套组件里,冻结属性是继承的还是各自独立的? 父组件开了 freezeWhenInactive,子组件默认会跟着冻结吗?如果子组件想单独保持活跃、不被父组件的冻结影响,应该怎么配?反过来,父组件没开冻结,子组件单独开了,解冻时会不会因为父组件还在刷新而产生时序问题?Repeat + virtualScroll 复用场景下,冻结和 @Reusable 会不会互相打架? 我理解冻结是“不响应状态更新”,复用是“拿旧组件实例重新挂数据”,如果冻结期间组件被复用池回收,aboutToReuse 里的数据刷新会不会被冻结一并挡住,导致复用出来的组件显示的是冻结前的旧内容?如果我只是想优化性能、并不想牺牲数据正确性,有没有比 freezeWhenInactive 更温和的手段?比如只冻结 UI 节点的刷新、但保留 @Monitor 执行用于写缓存或打日志?还是说冻结的本质就是一刀切,要性能就得接受这部分逻辑不跑?

评论4

浏览 49

发布于前天06:04
我在做一个出行工具类应用,想把“查找路线”和“扫一扫”两个高频功能注册进意图框架,让用户对小艺说一句“帮我打开 XX 的查找路线”就能直接落到功能页,省掉打开 App 再点好几层的功夫。按文档把 insight_intent.json 放进了 src/main/resources/base/profile/,照着示例写了 InsightIntentExecutor,编译、签名、上架都过了。结果真机一验证,三台设备三种死法:一台小艺直接回“暂不支持这个功能”;一台调用起来了但返回 code 非 0,页面卡在空白;还有一台日志里报 getSid failed,意图服务异常。文档来回翻了几遍,每一步都像照做了,行为就是不对。后来看了一些社区反馈,才意识到问题可能不止一层:insight_intent.json 的路径:社区里提到,文件必须只在 entry 模块的 src/main/resources/base/profile/ 下,工程里只能存在一个。如果放在 products/phone/... 这种非 entry 路径,系统可能解析不到,报 -304 intent invalid。intentName 的命名:文档要求大驼峰,不能带下划线,而且必须和小艺开放平台端插件里的工具名称完全一致。我有点不确定自己平台侧的命名和配置文件里的是不是真的一字不差。onExecuteInUIAbilityForegroundMode 的返回值:社区提到必须显式 return {code: 0},如果隐式返回 undefined 或非 0,小艺会判定意图执行失败,表现就是页面空白。getSid failed:有说法是和设备未登录华为账号或会话过期有关,需要确认设备上华为账号的登录状态。白名单:我印象里看到过 shareIntent 报 1000101101,原因是应用未在 InsightIntent 框架中完成订阅注册,调试模式也无法绕过白名单。但我现在调的不是 shareIntent,不确定普通意图是不是也有同样的注册要求。开发者类型:还看到有人说 Intents Kit 的完整接入能力暂不对个人开发者开放,需要企业开发者账号才能申请。如果这条是真的,那我个人账号现在能调到什么程度、卡在哪一步,就完全不清楚了。我现在最困惑的是:这三台设备的报错到底是同一个根因的不同表现,还是三个独立的坑?如果根因不止一个,应该按什么顺序排查,才能避免改完一个另一个又冒出来?另外,如果白名单和个人开发者限制确实存在,有没有什么办法在本地先把代码链路跑通、等账号升级后再补申请,而不是完全卡住?

评论4

浏览 51

发布于前天06:04
我们 App 是多个 UIAbility 的架构,首页、设置页、消息页各一个 Ability,通过 AppStorageV2.connect 共享同一个 userConfig 对象,同步主题、语言、未读数这些字段。第一个问题:高频操作时字段互相覆盖。 用户在设置页连续切主题和语言,消息 Ability 同时在更新未读数,结果最后 theme 莫名其妙回到了 light,unreadCount 主 Ability 也读不到最新值。我后来才搞明白,AppStorageV2 虽然支持同一主线程内多个 UIAbility 共享,但它定位是 UI 状态管理中心,connect 返回的是共享对象的引用,没有内建的锁机制或事务原子性保证,多个 Ability 各自拿旧快照改字段再写回,后写覆盖先写是预期内的行为。第二个问题:重启后配置全丢了。 AppStorageV2 本身不负责落盘,数据只在内存里,应用结束就没了。我试过换成 PersistenceV2,但 PersistenceV2.connect() 的返回类型本来就是 T | undefined,磁盘上不存在对应数据时必然返回 undefined,老用户第一次打开或者从旧版本升级上来的时候直接拿到了 undefined,页面一访问就崩。我现在卡在几个具体的地方:写操作到底该怎么收敛? 是让所有 Ability 都调用同一个 Manager 的 updateTheme()、updateUnread() 这种字段级方法,还是传一个 patch 对象进去合并?如果把未读数和用户配置拆成不同的 key,那主题和未读数在 UI 上需要联动展示时,怎么保证两个 key 的更新是同一帧生效的?PersistenceV2.connect() 拿到 undefined 的时候,defaultCreator 应该怎么配才保险? 我看到资料说冷启动时要提供默认值构造器,先建立实例再读,但具体是写成 () => new UserConfig() 就行,还是需要在拿到实例之后再做一次版本检测和字段补全?如果用户是从旧版本升级上来的,PersistenceV2 反序列化旧数据时不会走构造函数,类里写的字段默认值不生效,新增字段会是 undefined。 这个迁移应该在 connect 之后立刻做,还是放到页面的 aboutToAppear 里?如果迁移过程中写入失败,怎么保证不把用户的旧数据弄丢?

评论8

浏览 124

发布于3天前
我的 App 冷启动一直有点慢,经常白屏两三秒首页才出来,中低端机上偶尔还会触发启动超时提示。我大概知道问题出在哪——UIAbility.onCreate 里同步初始化了推送 SDK、统计 SDK、数据库打开、配置文件读取、网络层构建,全是阻塞调用;首屏页面的 aboutToAppear 里又叠了同步网络请求,第一帧迟迟出不来。我也知道应该把任务拆分、该延后的延后、该并行的并行,但真动手的时候就不知道从哪开始拆。比如崩溃上报、日志 SDK 这种是不是必须最早初始化?网络库和数据库建表能不能挪到首帧渲染之后再做?AppStartup 启动框架和直接在 onCreate 里写代码到底有什么区别,是不是把任务改成 AppStartup 的启动任务冷启动时间就能降下来?首屏 aboutToAppear 里的同步网络请求我也拿不准。如果首屏数据必须在页面显示之前拿到,那这个请求是不是必然阻塞首帧?有没有办法先显示骨架屏或者读本地缓存,让首帧先出来,网络数据回来后再刷新?另外我看到 TTID 的参考值是 680ms,TTFD 参考线是 1100ms,我这个动不动就两三秒明显超了,在 DevEco Studio 里用 Launch Profiler 排查的话,重点应该看哪几个阶段的耗时?

评论6

浏览 131

发布于3天前
AI助手
|
推荐答复
AI 生成内容,仅供参考
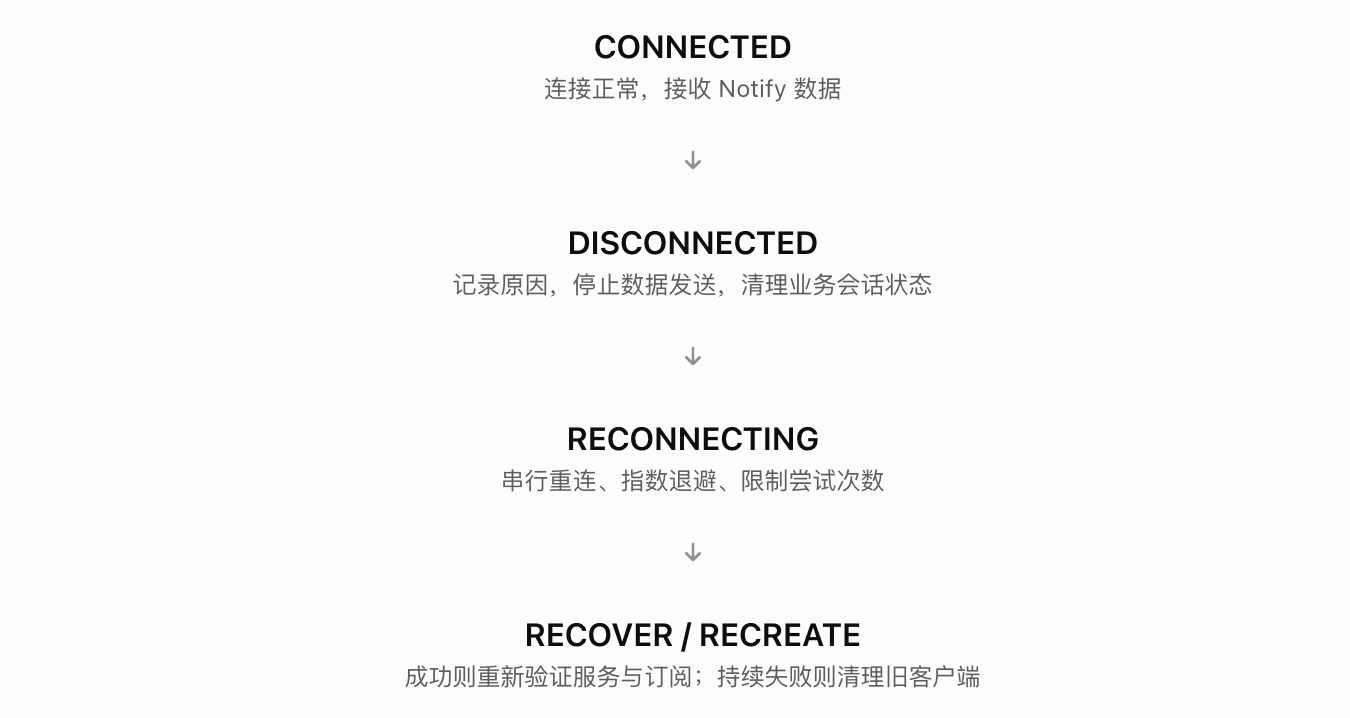
冷启动白屏两三秒的根因很明确:主线程在首帧渲染前串行执行了太多非 UI 的阻塞调用,把 onCreate → onWindowStageCreate → loadContent → 首帧上屏这条链路堵死了。拆分的核心不是"把代码换个地方写",而是先给每个初始化项做一次三问分类:首帧是否依赖它、它是不是 IO 重活、它是否必须在启动期完成。下面按你的几个具体疑问逐个展开。一、初始化项怎么分类按"三问法"可以把你的初始化项分成三类:必须同步完成:窗口配置、路由决策、基础日志。这类是首屏显示的硬前提,留在 onCreate 里,但要控制在几十毫秒内。首帧依赖但可并行/异步:配置文件读取(如果首屏要读全局开关)、网络层构建(首屏要发请求)。这类不能删,但要挪出主线程或异步化。非首帧依赖:推送 SDK、统计 SDK、数据库建表、崩溃上报的完整初始化。这类延后到首帧渲染之后再做,用户无感知。具体到你列的几项:崩溃上报和日志 SDK 不必"最早",但要"尽早"——崩溃上报的意义在于捕获启动早期崩溃,所以它的轻量核心(注册异常监听)建议保留在启动链路里,但它的重活(读取历史崩溃文件、上报通道建立)可以延后;日志 SDK 本身很轻,可以保留。推送和统计是典型的可延后项,官方最佳实践的实测数据里,"延迟加载非核心 SDK"这一项能减少 100-200ms。数据库建表和网络层构建完全可以挪到首帧之后,或者放到子线程并行执行。二、AppStartup 和直接写在 onCreate 里的区别AppStartup 启动框架的本质价值是三件事:把串行变成有依赖图的并行、把任务挪出主线程、把"是否阻塞首页加载"变成显式配置。它和 onCreate 里手写代码的关键差异在于:onCreate 里的代码天然串行、天然在主线程、天然阻塞后续生命周期;AppStartup 里每个任务声明 dependencies 形成依赖图,无依赖的任务自动并行;声明 runOnThread: "taskPool" 后任务在任务池线程执行;声明 waitOnMainThread: false 后首页加载不等它完成。要注意一个关键坑:waitOnMainThread 缺省值是 true。如果你只是把任务改成 StartupTask 但不显式写 false,主线程依然会等任务做完才加载首页,等于白改。另外 StartupTask 子类必须加 @Sendable 注解,漏了任务不会生效且报错不指向注解本身。还有一点:AppStartup 治理的是初始化的组织方式,它不能替代"网络请求提前发起、缓存优先展示"这些数据层手段,两者要配合做。下面是完整示例。第一步,编写启动任务类:// ets/startup/InitDatabaseTask.ets // 数据库初始化:IO 重活,放任务池,不阻塞首页 import { StartupTask, common } from '@kit.AbilityKit'; import { hilog } from '@kit.PerformanceAnalysisKit'; @Sendable export default class InitDatabaseTask extends StartupTask { constructor() { super(); } async init(context: common.AbilityStageContext): Promise<string> { hilog.info(0x0000, 'StartupTag', 'InitDatabaseTask begin'); // TODO: 在此执行建表、打开数据库等耗时操作 return 'InitDatabaseTask'; } onDependencyCompleted(dependency: string, result: Object): void { // 依赖任务完成时的回调,可在此获取依赖结果 } }// ets/startup/InitAnalyticsTask.ets // 统计 SDK:非首帧依赖,标记为手动模式,首帧后再拉起 import { StartupTask, common } from '@kit.AbilityKit'; import { hilog } from '@kit.PerformanceAnalysisKit'; @Sendable export default class InitAnalyticsTask extends StartupTask { constructor() { super(); } async init(context: common.AbilityStageContext): Promise<string> { hilog.info(0x0000, 'StartupTag', 'InitAnalyticsTask begin'); // TODO: 在此初始化统计 SDK return 'InitAnalyticsTask'; } onDependencyCompleted(dependency: string, result: Object): void { } }// ets/startup/StartupConfig.ets // 启动框架全局配置 import { StartupConfig, StartupConfigEntry, StartupListener } from '@kit.AbilityKit'; import { BusinessError } from '@kit.BasicServicesKit'; import { hilog } from '@kit.PerformanceAnalysisKit'; const onCompletedCallback = (error: BusinessError<void>): void => { if (error) { hilog.error(0x0000, 'StartupTag', 'onCompleted: %{public}d, %{public}s', error.code, error.message); } else { hilog.info(0x0000, 'StartupTag', 'all startup tasks completed'); } }; export default class MyStartupConfigEntry extends StartupConfigEntry { onConfig(): StartupConfig { const startupListener: StartupListener = { 'onCompleted': onCompletedCallback }; const config: StartupConfig = { 'timeoutMs': 10000, 'startupListener': startupListener }; return config; } }第二步,编写配置文件 resources/base/profile/startup_tasks.json:{ "startupTasks": [ { "name": "InitCrashTask", "srcEntry": "./ets/startup/InitCrashTask.ets", "runOnThread": "mainThread", "waitOnMainThread": true }, { "name": "InitNetworkTask", "srcEntry": "./ets/startup/InitNetworkTask.ets", "runOnThread": "taskPool", "waitOnMainThread": true }, { "name": "InitDatabaseTask", "srcEntry": "./ets/startup/InitDatabaseTask.ets", "runOnThread": "taskPool", "waitOnMainThread": false }, { "name": "InitAnalyticsTask", "srcEntry": "./ets/startup/InitAnalyticsTask.ets", "runOnThread": "taskPool", "waitOnMainThread": false, "excludeFromAutoStart": true } ], "configEntry": "./ets/startup/StartupConfig.ets" }这份配置体现了拆分思路:崩溃上报核心保留主线程同步(首帧前必须有异常捕获能力);网络层首屏要用但放任务池构建,主线程只等它(通常很快);数据库建表放任务池且 waitOnMainThread 为 false,首页加载完全不等它;统计 SDK 用 excludeFromAutoStart 转为手动模式。第三步,在 module.json5 中开启启动框架:{ "module": { "appStartup": { "profile": "startup_tasks" } } }第四步,首帧渲染完成后拉起手动模式任务:// ets/pages/Index.ets 首页中 import { startupManager, common } from '@kit.AbilityKit'; // 在首页 onAppear(组件已挂载、首帧已渲染)后触发 .onAppear(() => { const context = this.getUIContext().getHostContext() as common.UIAbilityContext; startupManager.run(['InitAnalyticsTask', 'InitPushTask'], context) .then((): void => { console.info('delayed startup tasks done'); }); })改造完成后,UIAbility.onCreate 里基本只剩路由参数解析和窗口相关配置,onWindowStageCreate 里直接 loadContent,不要在 loadContent 的回调里等待任何全局初始化完成再加载——那是另一个典型的白屏放大器。三、首屏同步网络请求:不必然阻塞首帧首屏数据"必须在页面显示之前拿到"这个前提本身通常不成立。正确的模式是缓存优先 + 骨架屏占位:首帧用本地缓存或骨架屏立即渲染,网络请求异步发出,数据回来后通过状态变量触发刷新。这样 TTID(首帧)由渲染决定,TTFD(内容完整)由网络决定,两者解耦。官方最佳实践里"优化网络请求时机"一项的实测对比是 1700ms 降到 885ms。// ets/pages/Index.ets // 首页:骨架屏 + 缓存优先 + 网络刷新 import { http } from '@kit.NetworkKit'; interface HomeFeedItem { id: string title: string } interface HomeFeedResp { items: HomeFeedItem[] } @Entry @Component struct Index { @State feedItems: HomeFeedItem[] = [] @State isLoading: boolean = true aboutToAppear(): void { // 1. 先读本地缓存(异步),有数据立即上屏 this.loadFromCache(); // 2. 再发网络请求,回来后覆盖刷新 this.requestFeed(); } loadFromCache(): void { // TODO: 替换为实际的 preferences / 数据库缓存读取 // 异步读取,不阻塞 build(),读到后赋值触发刷新 } requestFeed(): void { const httpRequest = http.createHttp(); httpRequest.request('https://example.com/api/feed', { method: http.RequestMethod.GET, expectDataType: http.HttpDataType.OBJECT }).then((resp: http.HttpResponse) => { if (resp.responseCode === 200 && resp.result !== undefined) { const raw = resp.result as HomeFeedResp; this.feedItems = raw.items; } this.isLoading = false; }).catch((): void => { this.isLoading = false; }).finally((): void => { httpRequest.destroy(); }); } build() { Column() { if (this.feedItems.length > 0) { ForEach(this.feedItems, (item: HomeFeedItem) => { Text(item.title) .fontSize(16) .padding(12) }, (item: HomeFeedItem) => item.id) } else if (this.isLoading) { // 骨架屏占位,首帧立即可见 Column() { ForEach([1, 2, 3], (i: number) => { Column() .width('90%') .height(64) .borderRadius(8) .backgroundColor('#F1F1F1') .margin({ top: 12 }) }, (i: number) => i.toString()) } .width('100%') } else { Text('加载失败,请重试') .fontSize(14) } } .width('100%') .height('100%') } }这个模式的关键点:aboutToAppear 里只发起异步操作,绝不做同步等待;缓存命中时用户几乎看不到骨架屏,缓存未命中时骨架屏替代白屏,体感差异巨大。四、Launch Profiler 排查重点在 DevEco Studio 的 Profiler 中选择 Launch 模板录制冷启动(录制前用 aa force-stop 杀掉进程保证是冷启动,建议勾选 Hitrace 的 multimodalinput 以采集离手信号作为起点),时间线上重点看这几个阶段的耗时:进程创建阶段:AppSpawn fork 进程及初始化,这部分是系统开销,应用侧能做的是控制包体(开启混淆、图片转 WebP、移除无用资源),另外启动页图标建议不超过 256×256 分辨率以减少解码时延;AbilityStage 生命周期段:对应 AbilityStage.onCreate,你改造后这一段应该明显缩短,自动启动任务从这里挪走大半;UIAbility 生命周期段:onCreate 到 onWindowStageCreate 中 loadContent 完成,你的 SDK 初始化阻塞就堆在这里;首帧渲染阶段:loadContent 到 Render Service 首帧上屏,覆盖组件树构建、布局和渲染提交;首页加载阶段:aboutToAppear 的同步网络请求会体现在这里,对应 TTFD。定位具体代码时,切换到 Callstack 泳道查看主线程(线程号与进程号一致)的子泳道,在 Heaviest Stack 区域按权重找到占比最大的调用栈,双击栈帧可直接跳到源码对应行——官方案例里就是通过这种方式定位到 onCreate 中的耗时操作的。此外 Launch 泳道的 Running CPU Cores 子泳道可以看关键线程跑在哪个核心上,判断是否存在 CPU 调度问题。最后补充两点:一是 TTID 参考值 680ms、TTFD 参考线 1100ms 的场景下,你目前两三秒的水平已明显超标,改造后建议用 Launch 模板前后各录一次对比,数字说话;二是如果改造后冷启动仍高于 1.6s 且资源加载、模块加载占比超过 25%,可以考虑接入系统级的应用快启能力,通过复用启动初始化结果进一步提速,但这属于锦上添花,先把启动路径上的同步阻塞清干净才是根本。
点赞1
回复于3天前
在鸿蒙开发中,遇到多设备(手机、平板、折叠屏、车机)场景下,Column、Row、Grid等布局控件如何结合断点、权重和自适应规则,避免控件被拉伸变形或留白过多?有没有推荐的布局组合策略和排查思路?

评论21

浏览 195

发布于5天前
想买一个华为电脑,然后跑这个程序创造软件我现在这个电脑太老了

评论11

浏览 108

发布于4天前
我在做一个穿戴设备配套的模块,一边要维持 BLE 连接收数据,一边要在本地处理设备传过来的图片做预览和压缩。结果两边都在“资源管理”上翻了车。先交代 BLE 这边。 用的是 @kit.ConnectivityKit 的 BLE 能力,设备搜到了、连上了,但过一会儿就断,有时候几十秒,有时候几分钟。断开之后我在 BLEConnectionStateChange 回调里直接调 connect() 重连,结果有时候能连上,有时候一直连不上,必须把应用杀掉重开才行。后来查了资料,断连的核心原因集中在几个地方:连接间隔(Connection Interval)设置不当,设备进入休眠后链路就没了;应用切后台后 GATT 连接被系统终止;以及重连时反复新建 gattClient 却没有 close 旧实例,资源泄漏导致后续连接状态异常。官方示例的思路是重用现有的 gattClient 对象,断连时用同一个对象发起重连;如果确实需要重新创建,必须先把旧对象 close 掉。我现在卡在几个具体问题上:连接间隔到底设多少比较稳? 我看到有示例给的是 connIntervalMin: 10、connIntervalMax: 20、supervisionTimeout: 3000(单位 1.25ms,对应 12.5ms 到 25ms 的间隔)。但手环、传感器这类低功耗设备,间隔设得太短功耗会上去,设得太长又容易断。这个值应该怎么根据设备类型和业务频率来权衡,而不是直接抄示例?重连时“重用 gattClient”和“先 close 再新建”的边界到底在哪里? 官方说优先重用,但什么情况下必须重建?如果断连是因为底层蓝牙栈重启或者设备 MAC 轮转,重用的 gattClient 还能正常工作吗?我看到自动重连方案里提到“旧 GattClient 清理 + 断连三级分类”,这个分类具体应该按什么维度来分,是看断开原因、看设备是否在广播,还是看上层业务是否主动断开?后台保活到底需不需要申请长时任务? 有资料说应用后台时 GATT 连接会被系统终止,需要申请 KEEP_BACKGROUND_RUNNING 并启动后台任务。但长时任务的类型选哪个?bluetoothInteraction 是唯一合适的选择吗,还是说短时间的后台传输有其他更轻量的保活方式?再说图片处理这边。 设备传过来的图片要在本地解码、缩放、再编码成缩略图。图片稍微多几张,内存峰值就飙得很高,低端机偶尔直接闪退。查了 Image Kit 的资料才意识到,PixelMap 的像素数据存在 Native 层,ArkTS 侧只持有 JS 包装对象。Native 内存释放只有两条路:主动调 release(),或者等 GC 回收 JS 对象时顺带释放。GC 是按阈值触发的,不是对象一变垃圾就立刻回收,所以多张大图同时驻留时,峰值很容易冲上去。官方在高像素图片处理指南里也强调,编辑、压缩、加水印这类链路要尽量串行处理并复用中间结果,避免同时持有多份大图数据。我想请教的是:批量处理多张图时,ImageSource、PixelMap、ImagePacker 的释放顺序和时机到底怎么安排最稳? 是每张图处理完立刻 release 三个对象再处理下一张,还是可以攒一批 PixelMap 最后统一释放?如果某一步异步操作还没完成就调了 release,会直接报错还是静默出问题?如果业务上确实需要同时持有几张图的 PixelMap 做对比或拼接,有没有办法降低峰值,而不是只能靠“串行处理”?比如用 sourceSize 限制解码分辨率、或者用 YUV 像素格式来减少单张图的内存占用?这些手段在 ArkTS 侧和 C API 侧的支持程度一样吗?BLE 接收和图片处理都在同一个页面里跑,蓝牙回调、图片解码、UI 刷新互相抢占主线程,这种场景下是不是应该把图片处理整体挪到 TaskPool 里,只把最终的缩略图 PixelMap 或文件路径回传主线程?但 PixelMap 跨线程传递本身有没有什么限制,会不会出现“传过去之后原对象不能再用”的情况?这两个问题表面上一个是蓝牙一个是图片,但底层都是“资源创建了,但没有在正确的时机释放或复用”。想请教一下有经验的大佬,这两块的资源管理有没有什么共通的收口原则,比如“谁创建谁释放”“异步操作完成后才释放”“跨线程传递后所有权转移”之类的,可以先照着把最明显的泄漏点堵上。

评论8

浏览 152

发布于4天前
飞b6
|
推荐答复
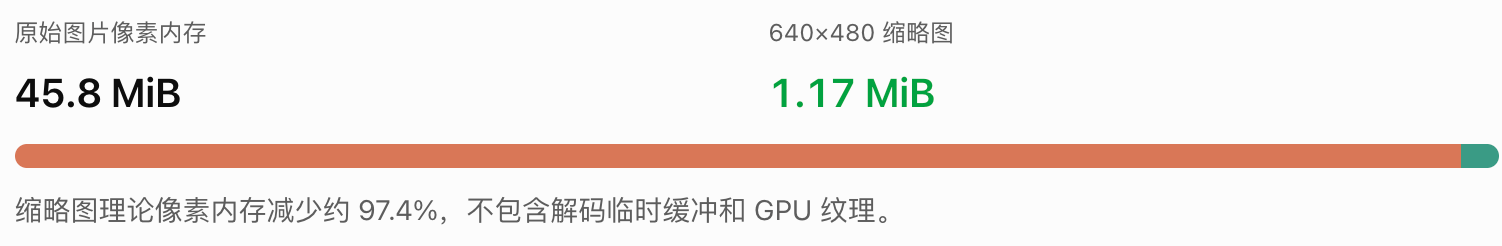
一、先明确:这不是单纯的资源泄漏问题BLE 断连和 PixelMap 内存暴涨,虽然都涉及资源管理,但根因不完全相同。现象更值得优先排查的原因BLE 连接几十秒或几分钟后断开信号质量、连接参数、外设休眠、后台调度BLE 重连失败,重启 App 后恢复连接状态竞争、旧 GattClient 未清理、蓝牙栈异常图片处理时内存突然升高全尺寸解码、同时持有多个 PixelMap图片处理结束后内存持续增长资源未释放、异步任务或 UI 仍持有引用所以,建议先建立两套独立的资源管理器:BleConnectionManager 和 ImageTaskManager,不要让页面直接负责 GATT 实例与图像资源的创建、释放。二、BLE 连接间隔和重连策略1. 连接间隔如何设置?连接间隔不是越短越稳定,应根据业务的数据吞吐量和功耗要求调整。业务类型参考连接间隔实时运动数据15~30ms手环心率、状态通知30~100ms低频环境传感器100~500ms图片分片传输15~50ms,传输后再调整这些属于工程调优参考值,不代表设备最终协商的连接参数。另外,你提供的参数有一个容易误解的地方:BLE 标准连接间隔单位为 1.25ms,10~20 对应 12.5~25ms。BLE 标准的连接监督超时单位为 10ms。如果鸿蒙具体接口将 supervisionTimeout 定义为毫秒,那么 3000 就表示 3 秒,而不是 3000 个 BLE 标准单位。还要考虑外设的 slave latency(从设备延迟)。标准 BLE 连接参数需要满足监督超时与连接间隔、从设备延迟之间的约束,不能只调整连接间隔。2. GattClient 什么时候复用、什么时候重建?建议分三级处理:断连级别典型原因处理方式一级:临时断连信号弱、偶发超时等待断开完成后尝试复用客户端二级:设备不可达设备休眠、距离过远、广播不可见暂停高频重连,重新扫描确认三级:连接对象失效蓝牙服务重启、旧客户端持续报错、设备标识变化清理旧客户端,重新发现并创建不要单靠是否扫描到广播来判断是否能够连接。有些外设在特定工作模式下并不持续广播。官方 BLE 排查文档也说明,设备随机地址可能发生变化,连接成功后应根据连接状态进行服务发现和特征值操作。推荐把重连控制从回调中独立出来:enum BleState { IDLE, CONNECTING, CONNECTED, DISCONNECTED, RECONNECTING, CLOSING } class BleConnectionManager { private state: BleState = BleState.IDLE; private retryCount: number = 0; private sessionVersion: number = 0; onDisconnected(): void { if (this.state === BleState.CLOSING || this.state === BleState.IDLE) { return; } this.state = BleState.DISCONNECTED; this.sessionVersion++; this.scheduleReconnect(); } private scheduleReconnect(): void { if (this.state !== BleState.DISCONNECTED) { return; } this.state = BleState.RECONNECTING; // 由统一调度器安排重连,禁止回调中并发 connect() // 连续失败后重新评估设备发现和 GattClient 状态 } }这只是状态管理骨架。实际还需要保存单个 GattClient、注销监听、取消重试任务,并把连接操作串行化。关键:close() 应视为当前客户端资源生命周期结束。 调用后不要继续使用原对象;需要重新建立连接时创建新实例。3. 后台是否需要长时任务?如果需要持续后台接收穿戴设备数据,可以评估:backgroundTaskManager.BackgroundMode.BLUETOOTH_INTERACTION它是官方定义的蓝牙相关长时任务类型。DATA_TRANSFER 和 MULTI_DEVICE_CONNECTION 也存在,但不能因为都涉及通信就随意互换,应根据具体业务和系统支持范围选择。如果只是一次短时间图片传输,可以评估短时任务;如果用户明确开启持续设备交互,则更适合合规的蓝牙长时任务。长时任务不能保证 BLE 永不断连,更不能替代 GATT 重连机制。三、PixelMap 如何避免 OOM?1. 资源释放的正确原则推荐每张图片使用独立的资源作用域:接收完整图片文件 ↓ 创建 ImageSource ↓ 按目标显示尺寸解码 PixelMap ↓ 创建 ImagePacker ↓ await 编码完成 ↓ 释放 ImagePacker / PixelMap / ImageSource ↓ 处理下一张释放顺序的核心不是谁先释放,而是必须确保资源已经没有使用者。例如,ImagePacker 还在编码时就释放 PixelMap,可能不只是抛异常。华为 2026 年 9 月的 Image Kit 问题文档明确记录了编码过程中提前释放或修改 PixelMap 导致 Native 崩溃的情况。推荐采用如下资源管理结构:import { image } from '@kit.ImageKit'; async function processImage( inputPath: string, outputFd: number ): Promise<void> { let source: image.ImageSource | undefined; let pixelMap: image.PixelMap | undefined; let packer: image.ImagePacker | undefined; try { source = image.createImageSource(inputPath); const info = await source.getImageInfo(); const width = info.size.width; const height = info.size.height; // 限制最长边为640,保持原始宽高比 const ratio = Math.min(1, 640 / Math.max(width, height)); pixelMap = await source.createPixelMap({ desiredSize: { width: Math.max(1, Math.round(width * ratio)), height: Math.max(1, Math.round(height * ratio)) } }); packer = image.createImagePacker(); await packer.packToFile(pixelMap, outputFd, { format: 'image/jpeg', quality: 80 }); } finally { // 先结束消费者,再释放其依赖资源 if (packer) { await packer.release(); } if (pixelMap) { await pixelMap.release(); } if (source) { await source.release(); } } }这是正常处理路径的示例,实际工程还应隔离每个资源释放时的异常,避免某一个 release() 失败后阻止其他资源清理,并由调用方关闭输出 FD。2. sourceSize 和 desiredSize 不要混淆sourceSize:用于描述输入图片源的尺寸信息,不应当作通用的缩略图解码参数。desiredSize:指定期望解码输出的尺寸,更适合缩略图生成。desiredPixelFormat:请求输出像素格式,但需要满足解码器支持条件。建议先通过 getImageInfo() 读取原始分辨率,再使用 desiredSize 限制解码输出尺寸。华为官方图像处理实践也采用这种方式。3. 同时持有多张 PixelMap 怎么优化?以一张 4000×3000 的 RGBA_8888 图片为例:缩略图理论像素内存减少约 97.4%,不包含解码临时缓冲和 GPU 纹理。推荐同时采用三项措施:解码时降采样、限制并发任务数量、只缓存可见区域所需的 PixelMap。对于 YUV,理论上 YUV420 的像素存储量小于 RGBA_8888,但不能假定 ArkTS 和 Native C API 对所有 YUV 格式具有相同支持能力。格式转换也可能引入额外缓冲,实际峰值不一定更低。四、BLE 和图片处理如何进行线程隔离?建议将 BLE 连接管理和图片处理分为两条流水线。我的建议是:TaskPool 只传入图片文件路径、尺寸和任务 ID,最终返回缩略图文件路径。这样比直接跨线程传递大 PixelMap 更容易管理所有权。PixelMap 是否能直接通过 TaskPool 传递、底层是否复制或共享,需要结合目标 SDK 的序列化与并发支持确认。不能简单套用 ArrayBuffer 的转移语义,也不能假设传输后原对象必然失效。同时不要在 BLE Notify 回调中执行图片解码,也不要每收到一个 BLE 分片就更新一次 UI。五、最值得先修改的五个地方建议按以下顺序收口:BLE 连接实例统一管理:同一设备同时只允许一个 GattClient 和一个重连流程。重连改为状态机调度:普通断连先尝试复用;蓝牙栈异常或连续失败后清理重建。图片解码直接降采样:使用 desiredSize,避免全图解码后再缩放。图片资源按任务释放:await 所有依赖操作完成后,通过 finally 清理。增加有界队列和背压:图片处理速度赶不上 BLE 接收速度时,要暂停业务层继续发送、减小发送窗口或采用磁盘缓冲,而不是无限积累内存。最后通过 HiLog 和 Profiler 同时记录 BLE 连接次数、活跃 GattClient 数量、断连原因、图片任务数量、Native Heap 峰值,以及任务结束后的内存回落情况。最终判断:这两个问题最可靠的共通原则是“谁拥有资源,谁负责结束其生命周期;谁正在使用资源,资源就不能提前释放;所有异步任务必须有明确的终止和清理路径”。官方参考:BLE 连接状态和异常排查、Image Kit 常见资源生命周期问题、后台长时任务 API。
点赞
回复于4天前
我在做一个后台数据处理的模块,主线程负责 UI 和系统能力采集,Worker 线程跑轨迹计算和文件落库。结果两条路都走得很不顺。先说 Worker 这条线。 我把一部分计算逻辑抽成了独立的 ArkTS 模块,在 Worker 里用 napi_load_module 动态加载。但这个模块内部 import 了 @kit.LocationKit,加载进来一调用就报 binding = undefined。同一个模块放主线程里完全正常,LocationKit 接口都能调,一到 Worker 就废了。后来才搞明白,Worker 线程的 JS 引擎是隔离环境,不会自动注入系统 Kit 的 native binding。napi_load_module 只负责在当前 Runtime 里加载模块,不会给 Worker 补齐 UIAbilityContext 或某个 Kit 所需的运行环境。官方答复里甚至给了个大致边界:util、crypto、纯 ArkTS 模块、不依赖系统能力的自研 NAPI 扩展可以在 Worker 用;而 UI、AbilityContext、Location、Media、Camera 这些依赖主线程环境的 Kit 基本不行。我现在的困惑是:这个边界应该怎么系统性地判断,而不是靠零散清单? 官方说“以具体 API 文档的线程约束为准”,那我在设计阶段逐个翻 API 文档的“线程模型”说明,是唯一可靠的办法吗?有没有办法提前知道某个 Kit 的某个接口到底能不能在 Worker 里跑,而不是写完 NAPI 封装才发现调不通?napi_load_module_with_info 在 Worker 里加载模块时,会不会尝试补齐一些运行环境? 还是说它只是把模块文件读进来,binding 缺失的问题依然存在?如果我在 Worker 里必须加载一个依赖系统 Kit 的模块,除了“主线程采集、postMessage 丢纯数据”之外,还有没有别的架构空间?如果计算过程中 Worker 需要频繁回调主线程获取系统状态,这种来回通信的开销会不会把 Worker 的并行收益吃掉?官方建议的“主线程采集 → Worker 计算 → 结果回传”模式,在需要高频状态查询的场景下还成立吗?再说 IPC 这条线。 我需要把一批带缩略图的记录从 A 进程传到 B 进程,单次数据量超过了 200KB 的上限,直接报 1003702002 IPC data is oversized。IPC Kit 的文档写得很明确:单设备跨进程通信最大 200KB,超过必须用匿名共享内存(Ashmem)。我现在的困惑是:Ashmem 在 ArkTS 侧的完整链路到底怎么串? 创建共享内存、写入数据、通过 MessageSequence 传递句柄、对端映射读取、最后释放,这一整套在 ArkTS 层有可用的封装吗,还是必须下沉到 C API?共享内存的生命周期谁负责释放,会不会出现“传过去了但对端还没读完就被回收”的时序问题?如果暂时不走 Ashmem,分片传输的原子性怎么保证? 拆成多个 200KB 以内的消息依次发,中间某一片失败或者超时,对端怎么知道这批分片不完整、需要丢弃重传?有没有比较成熟的“批次 ID + 序号 + 总片数”协议可以参考,还是说应该让每条分片自带完整性校验?批量场景下偶发卡死,是不是同步 IPC 调用的阻塞问题? 我看到资料里提到同步 SendRequest 会在业务线程上阻塞等待 reply,没有超时机制,必须投递到独立线程并用 wait_for 设超时兜底。在 ArkTS 侧有没有办法避免主线程被同步 IPC 挂住,是应该改用异步接口,还是在业务层加一层超时封装?这两条线放在一起看,我总觉得“什么该留在主线程、什么能下沉到 Worker、大数据走哪条通道” 这三个决策是互相牵扯的:如果把 Kit 调用全压回主线程,主线程又可能被 IPC 同步调用堵住;如果把大数据全走 Ashmem,又得额外管理生命周期和分片协议。想请教一下有经验的大佬,这种场景下架构拆分的优先级应该怎么排,有没有一个可以先跑起来的“最小可靠骨架”。

评论3

浏览 179

发布于4天前
大雷神
|
推荐答复
结论先说:拆分方向没错,但 1 楼给的 Ashmem 示例代码里,writeAshmem(data, size, 0) 和 mapReadFromAshmem(size, 0) 不是当前 @ohos.rpc 的 Ashmem 接口——按这份示例写会直接编译不过。下面按官方接口逐个对齐。一、Worker 里能不能用系统 Kit:官方判断标准《TaskPool使用规范》原句:「TaskPool/Worker等工作线程不支持使用操作UI的模块、线程不安全的模块以及其他只支持在主线程中使用的模块。不支持UI模块是因为目前工作线程不支持操作UI,不支持线程不安全的模块是因为多线程使用该模块可能会导致多线程问题,只支持在主线程中使用的模块明确在文档中说明的有ApplicationContext (应用上下文)等。线程安全的模块是指多线程同时使用该模块也不会引入多线程问题,如TaskPool/hilog等。」据此的判断顺序:先看该接口的 API 文档有没有线程说明(写了仅主线程的直接出局);没有明确说明的,按是否依赖 UI / Context / 系统服务会话做初筛;编码前用探针工程在 Worker 里实测。你的 LocationKit 模块属于依赖系统能力的一类,import 进 Worker 也拿不到 binding,这条边界绕不过去,「主线程采集 → postMessage 纯数据 → Worker 计算」就是正确形态。另给数据通道补一条官方硬限制:TaskPool 侧「序列化传输的数据量大小限制为16MB」,轨迹批量落库单批逼近这个量级时要拆批,不要一次性 postMessage。二、IPC 200KB 与 Ashmem 的正确链路《IPC Kit简介》约束原句:「单个设备上跨进程通信时,传输的数据量最大为200KB。超过200KB的数据量传输可以使用匿名共享内存。」——原文是「可以使用」而不是「必须」,但单批超限会直接失败,Ashmem 是常规解。ArkTS 侧 Ashmem 的当前接口(@ohos.rpc,版本号按官方参考页):① rpc.Ashmem.create(name, size)(9+)创建;② mapReadWriteAshmem()(9+)或 mapTypedAshmem(mapType)(9+)映射——mapAshmem、mapReadAndWriteAshmem、mapReadOnlyAshmem 均已标记废弃;③ writeDataToAshmem(buf: ArrayBuffer, size, offset)(11+)写入,入参是 ArrayBuffer;④ MessageSequence.writeAshmem(ashmem) 写入句柄、对端 sequence.readAshmem() 取出(官方示例即此用法);⑤ 对端 mapReadonlyAshmem()(9+)后 readDataFromAshmem(size, offset)(11+)读出 ArrayBuffer;⑥ unmapAshmem()、closeAshmem()(8+)创建方与使用方各自成对释放。1 楼示例里的 ashmem.writeAshmem(data, byteLength, 0):Ashmem.writeAshmem 是废弃接口且入参是 number[](writeToAshmem 同);mapReadFromAshmem 在 ArkTS 侧不存在,应为 mapReadonlyAshmem + readDataFromAshmem。生命周期:句柄传过去后两端各自持有自己的映射,unmap/close 由创建方与使用方各自配对调用;释放时机用业务层回执保证(对端确认读完后再释放本端),不要假设系统替你做时序。三、同步阻塞:ArkTS 侧统一走异步sendMessageRequest 在 ArkTS 侧是 Promise 形式,官方示例即 .then(...) 并在 .finally 里 reclaim data/reply 两块 MessageSequence——调用发起后不会把主线程挂住,照示例在 finally 里 reclaim 即可,不需要在业务层自建超时封装。你引用的「同步 SendRequest 无超时、要 wait_for 兜底」属于 C/C++ 侧接口的约束,本轮未核验其行为,不在 ArkTS 结论里展开。分片兜底:批次ID+序号+总片数+分片校验是自建协议,官方没有现成协议可引;仅在 Ashmem 确实不便时再考虑,优先把整批数据收进 Ashmem 一次传。说明:代码为接口片段、未经编译;引号内为官方原句,本轮已逐页打开核对。你提到的 1003702002 错误码我在官方文档未核到对应条目,不做引用,不影响走 Ashmem 的结论。依据:《TaskPool使用规范》 https://developer.huawei.com/consumer/cn/doc/doccenter-capabilities/task-pool-usage-guidelines 《IPC Kit简介》 https://developer.huawei.com/consumer/cn/doc/harmonyos-guides/ipc-rpc-overview-V5 @ohos.rpc 参考 https://developer.huawei.com/consumer/cn/doc/harmonyos-references-V14/js-apis-rpc-V14 TaskPool简介 https://developer.huawei.com/consumer/cn/doc/harmonyos-guides-V14/taskpool-introduction-V14
点赞
回复于4天前
在ArkUI中使用List时,当用户滚动列表,如何避免内部的TextInput自动失去焦点?有没有推荐的焦点管理方案?

评论7

浏览 72

发布于4天前
Mandelx Hemen
|
采纳答复
在 ArkUI 的 List 中滚动导致 TextInput 失焦,根源通常不是“滚动”动作本身,而是 LazyForEach / @Reusable 的组件复用机制:输入框滑出可视区域后被回收或重置,节点不存在,焦点自然丢失。如果你的场景(如聊天页、表单页)必须保持输入状态:在 onFocus 中记下当前获焦输入框的 id,失焦时判断是否由滚动引起(滚动期间不清除记录),滚动停止后再通过 FocusController 把焦点还给原来的输入框。容易出现失误的地方:1· key 必须稳定:ForEach 的第三个参数要使用稳定且唯一的值(如 id.toString()),否则滚动时数组被整体替换,组件重建,焦点管理会失效。2· onBlur 里的滚动判断是核心:滚动引起的失焦不清除 focusedInputId,否则 onScrollStop 时就找不到要恢复的目标了。如果你的交互习惯是滚动即收起键盘(大多数列表的默认行为),官方文档提供了更简单的做法。通过 @State isFocusable 变量,在 onScrollStart 时设为 false(隐藏键盘),onScrollStop 时恢复为 true,并绑定到 TextInput 的 .focusable(this.isFocusable) 属性上。这适合不需要在滚动过程中持续输入的场景。参考内容(ArkUI中List滚动时如何避免TextInput失焦?):https://developer.huawei.com/consumer/cn/forum/topic/0203229177718567302(《滚动组件是否支持滚动时隐藏键盘》)https://developer.huawei.com/consumer/cn/doc/doccenter-dev-faq/faqs-arkui-1211
点赞1
回复于4天前
在ArkUI中自定义控件时,如何优雅地管理多种状态切换的逻辑,避免状态混乱和代码耦合?有没有推荐的设计模式或官方最佳实践?

评论6

浏览 52

发布于4天前
Z
|
采纳答复
核心思路就三步:用枚举收拢状态、用 @Monitor 监听变化、用 @Computed 派生 UI 属性。状态切换散落在各处 onClick 回调里才是混乱的根源,把"当前是什么状态"收成一个枚举变量,所有切换逻辑都走这个变量,UI 层只读这个变量,自然就解耦了。1. 用枚举定义状态机多种状态最怕用一堆 boolean 互相组合(比如 loading + error + success 三变量并存),改一个忘改另一个就出 bug。用枚举是最直接的做法:enum ButtonState { NORMAL, PRESSED, DISABLED, LOADING } @ObservedV2 class ButtonViewModel { @Trace state: ButtonState = ButtonState.NORMAL @Trace countdown: number = 0 press(): void { if (this.state === ButtonState.NORMAL) { this.state = ButtonState.PRESSED } } release(): void { if (this.state === ButtonState.PRESSED) { this.state = ButtonState.NORMAL } } disable(): void { this.state = ButtonState.DISABLED } enable(): void { this.state = ButtonState.NORMAL } }状态切换逻辑全放在 ViewModel 的方法里,组件只调方法、不直接赋值。2. 用 @Monitor 响应状态变化需要在状态切换时做副作用(打日志、发事件、联动其他变量),用 @Monitor 而不是在 onClick 里堆逻辑:@ComponentV2 struct StatefulButton { @Local vm: ButtonViewModel = new ButtonViewModel() @Monitor('vm.state') onStateChanged(monitor: IMonitor): void { const before = monitor.value()?.before as ButtonState const after = monitor.value()?.after as ButtonState if (after === ButtonState.LOADING) { this.startCountdown() } if (after === ButtonState.NORMAL && before === ButtonState.LOADING) { this.stopCountdown() } } @Local countdown: number = 0 private timer: number = -1 private startCountdown(): void { this.countdown = 5 this.timer = setInterval(() => { this.countdown-- if (this.countdown <= 0) { clearInterval(this.timer) this.vm.state = ButtonState.NORMAL } }, 1000) } private stopCountdown(): void { clearInterval(this.timer) this.countdown = 0 } @Computed get bgColor(): ResourceColor { switch (this.vm.state) { case ButtonState.PRESSED: return '#1565C0' case ButtonState.DISABLED: return '#BDBDBD' case ButtonState.LOADING: return '#42A5F5' default: return '#1976D2' } } @Computed get textContent(): string { if (this.vm.state === ButtonState.LOADING) { return `提交中 ${this.countdown}s` } if (this.vm.state === ButtonState.DISABLED) { return '不可用' } return '提交' } build() { Button(this.textContent) .backgroundColor(this.bgColor) .enabled(this.vm.state !== ButtonState.DISABLED && this.vm.state !== ButtonState.LOADING) .onClick(() => { this.vm.press() }) .gesture( LongPressGesture() .onAction(() => { this.vm.disable() }) ) } }这样 UI 层零条件判断,颜色文案全靠 @Computed 从状态枚举派生,状态切换的副作用全靠 @Monitor,互相不耦合。3. 跨组件共享状态状态需要穿透多层组件时,用 @Provider / @Consumer 代替逐层 @Param 传递:@ComponentV2 struct ParentPage { @Provider('buttonVM') vm: ButtonViewModel = new ButtonViewModel() build() { Column() { StatefulButton() StatusLabel() } } } @ComponentV2 struct StatusLabel { @Consumer('buttonVM') vm: ButtonViewModel = new ButtonViewModel() build() { Text(`当前状态: ${this.vm.state}`) .fontSize(14) } }不需要中间层组件感知这个状态,@Consumer 直接拿到 ViewModel 引用。关键点状态枚举是单一数据源,@Computed 是纯函数派生 UI 属性,@Monitor 是副作用入口,三者各司其职。这比散落的 boolean + 手动 if/else 好维护得多。
点赞1
回复于4天前
在做一个穿戴设备配套的模块,一边要维持 BLE 连接收数据,一边要在本地处理设备传过来的图片做预览和压缩。结果两边都在“资源管理”上翻了车。先交代 BLE 这边。 用的是 @kit.ConnectivityKit 的 BLE 能力,设备搜到了、连上了,但过一会儿就断,有时候几十秒,有时候几分钟。断开之后我在 BLEConnectionStateChange 回调里直接调 connect() 重连,结果有时候能连上,有时候一直连不上,必须把应用杀掉重开才行。后来查了资料,断连的核心原因集中在几个地方:连接间隔(Connection Interval)设置不当,设备进入休眠后链路就没了;应用切后台后 GATT 连接被系统终止;以及重连时反复新建 gattClient 却没有 close 旧实例,资源泄漏导致后续连接状态异常。官方示例的思路是重用现有的 gattClient 对象,断连时用同一个对象发起重连;如果确实需要重新创建,必须先把旧对象 close 掉。我现在卡在几个具体问题上:连接间隔到底设多少比较稳? 我看到有示例给的是 connIntervalMin: 10、connIntervalMax: 20、supervisionTimeout: 3000(单位 1.25ms,对应 12.5ms 到 25ms 的间隔)。但手环、传感器这类低功耗设备,间隔设得太短功耗会上去,设得太长又容易断。这个值应该怎么根据设备类型和业务频率来权衡,而不是直接抄示例?重连时“重用 gattClient”和“先 close 再新建”的边界到底在哪里? 官方说优先重用,但什么情况下必须重建?如果断连是因为底层蓝牙栈重启或者设备 MAC 轮转,重用的 gattClient 还能正常工作吗?我看到自动重连方案里提到“旧 GattClient 清理 + 断连三级分类”,这个分类具体应该按什么维度来分,是看断开原因、看设备是否在广播,还是看上层业务是否主动断开?后台保活到底需不需要申请长时任务? 有资料说应用后台时 GATT 连接会被系统终止,需要申请 KEEP_BACKGROUND_RUNNING 并启动后台任务。但长时任务的类型选哪个?bluetoothInteraction 是唯一合适的选择吗,还是说短时间的后台传输有其他更轻量的保活方式?再说图片处理这边。 设备传过来的图片要在本地解码、缩放、再编码成缩略图。图片稍微多几张,内存峰值就飙得很高,低端机偶尔直接闪退。查了 Image Kit 的资料才意识到,PixelMap 的像素数据存在 Native 层,ArkTS 侧只持有 JS 包装对象。Native 内存释放只有两条路:主动调 release(),或者等 GC 回收 JS 对象时顺带释放。GC 是按阈值触发的,不是对象一变垃圾就立刻回收,所以多张大图同时驻留时,峰值很容易冲上去。官方在高像素图片处理指南里也强调,编辑、压缩、加水印这类链路要尽量串行处理并复用中间结果,避免同时持有多份大图数据。我想请教的是:批量处理多张图时,ImageSource、PixelMap、ImagePacker 的释放顺序和时机到底怎么安排最稳? 是每张图处理完立刻 release 三个对象再处理下一张,还是可以攒一批 PixelMap 最后统一释放?如果某一步异步操作还没完成就调了 release,会直接报错还是静默出问题?如果业务上确实需要同时持有几张图的 PixelMap 做对比或拼接,有没有办法降低峰值,而不是只能靠“串行处理”?比如用 sourceSize 限制解码分辨率、或者用 YUV 像素格式来减少单张图的内存占用?这些手段在 ArkTS 侧和 C API 侧的支持程度一样吗?BLE 接收和图片处理都在同一个页面里跑,蓝牙回调、图片解码、UI 刷新互相抢占主线程,这种场景下是不是应该把图片处理整体挪到 TaskPool 里,只把最终的缩略图 PixelMap 或文件路径回传主线程?但 PixelMap 跨线程传递本身有没有什么限制,会不会出现“传过去之后原对象不能再用”的情况?这两个问题表面上一个是蓝牙一个是图片,但底层都是“资源创建了,但没有在正确的时机释放或复用”。想请教一下有经验的大佬,这两块的资源管理有没有什么共通的收口原则,比如“谁创建谁释放”“异步操作完成后才释放”“跨线程传递后所有权转移”之类的,可以先照着把最明显的泄漏点堵上。

评论13

浏览 81

发布于5天前
飞b6
|
推荐答复
结论:这两个问题确实可以用同一套资源生命周期管理原则解决,但要分别处理 BLE 连接状态和图片 Native 内存。针对你的穿戴设备场景,建议采用:BLE:单设备单连接管理器 + 有限重试状态机 + 异常时销毁重建 + 合规后台任务。图片:限制并发 + 解码时降采样 + try/finally 释放资源 + 缩略图落盘。线程:BLE 回调只负责接收数据,图片解码压缩交给 TaskPool 或 Worker,主线程只负责 UI。最重要的一点是:不要把每次 BLE 断连都当成需要立即重建连接,也不要把每张图片都完整解码后再缩小。 前者容易造成连接状态竞争,后者容易造成 Native 内存峰值过高。一、BLE:如何解决断连和重连失败?1. 连接间隔怎么配置?BLE 的连接间隔需要结合数据频率、允许的延迟以及外设电池容量调整。可以参考以下工程起始值:设备业务连接间隔建议适用特点高频实时传感器15~30ms低延迟,功耗较高手环持续数据通知30~100ms延迟、功耗相对均衡低频温湿度传感器100~500ms节能优先图片分片传输15~50ms传输期间使用,结束后可放宽以上是调优起点,不是华为官方固定推荐值,最终由中心设备和外设协商确定。另外,你提到的参数单位需要特别注意:BLE 标准连接间隔单位通常为 1.25ms,因此 10~20 对应 12.5~25ms。BLE 标准 supervision timeout 单位为 10ms,不是 1.25ms。如果某个鸿蒙接口明确要求超时时间单位为毫秒,3000 才表示 3 秒。不能把 supervisionTimeout: 3000 直接按 1.25ms 换算。 必须依据实际使用的接口定义判断单位。另外,supervision timeout 只是链路失联的判定时间,不能单纯通过增大它解决设备休眠或系统后台管控造成的断连。2. 重连什么时候复用,什么时候重建?建议采用以下分类:断连原因推荐操作普通信号中断、设备短暂离开先重用现有 GattClient外设休眠,暂时无广播暂停重连,等待重新发现蓝牙开关关闭或蓝牙服务重启清理旧会话,蓝牙恢复后重建旧 GattClient 持续报状态异常close() 后重新创建用户主动断开不自动重连设备地址发生变化重新发现设备,必要时重建客户端华为 Connectivity Kit 的常见问题文档也建议监听 BLEConnectionStateChange,并在连接成功后进行 GATT 服务发现。对于外设随机地址变化,需要重新确认目标设备标识。不要直接在断连回调里同步执行无限重连。推荐状态机:这里建议额外做三件事:同一设备同时只能有一个连接或重连任务。每次重新连接都使用新的会话版本号,避免旧回调影响新连接。记录 deviceId、断连时间、连接阶段、错误码和蓝牙开关状态,不要只记录“断开了”。3. 后台是否需要长时任务?如果用户明确要求手环持续连接、后台接收 BLE 数据,可以评估 BackgroundMode.BLUETOOTH_INTERACTION。官方后台任务模式包括:模式适用业务BLUETOOTH_INTERACTION蓝牙相关持续交互DATA_TRANSFER符合要求的数据传输业务MULTI_DEVICE_CONNECTION多设备互联协同对持续 BLE 外设通信,通常优先评估 BLUETOOTH_INTERACTION。但长时任务不能保证蓝牙永不断连,也不能保证应用进程永久存活。如果只是用户发起一次图片传输,完成后立即结束,更适合短生命周期任务,不建议为了短时间传输长期维持后台运行。二、PixelMap:如何控制大图内存?1. 三种资源应该怎样释放?推荐每张图片独立处理,执行完毕立即释放中间资源。资源创建时机释放时机ImageSource开始解码当前图片当前图片所有解码操作完成后PixelMap解码或图像处理时编码完成,且 UI/其他任务不再使用后ImagePacker开始压缩编码时packToFile / packToData 完成后不要积累一批完整 PixelMap 再统一释放。尤其注意:如果 PixelMap 已交给 UI 展示,就不能在工作线程或当前函数结束时立即释放,否则 UI 可能访问已经失效的图片资源。华为近期更新的 Image Kit 常见崩溃文档明确说明,编码过程中提前释放或改 PixelMap 可能造成 Native 崩溃;同一个 ImageSource 上并发执行多个解码操作也可能引发资源竞争。2. 推荐的图片处理实现下面使用 @kit.ImageKit,对图片进行降采样解码,再编码为 JPEG 文件。import { image } from '@kit.ImageKit'; // 输入和输出文件均应由调用方管理 async function createThumbnail( inputPath: string, outputFd: number ): Promise<void> { let source: image.ImageSource | undefined; let pixelMap: image.PixelMap | undefined; let packer: image.ImagePacker | undefined; try { source = image.createImageSource(inputPath); // 解码阶段直接限制分辨率 pixelMap = await source.createPixelMap({ desiredSize: { width: 640, height: 640 } }); packer = image.createImagePacker(); const options: image.PackingOption = { format: 'image/jpeg', quality: 80 }; // 必须等待编码完成 await packer.packToFile( pixelMap, outputFd, options ); } finally { // 只有全部异步操作结束后才能释放 if (packer) { await packer.release(); } if (pixelMap) { await pixelMap.release(); } if (source) { await source.release(); } } }示例中的 desiredSize 是目标解码尺寸,实际产品应先读取原图尺寸、计算比例,再设置目标宽高,避免改变图片宽高比。输入输出文件描述符也应在调用方的 finally 中关闭。如果部分项目使用的 SDK 接口类型不同,请以对应版本的 image.DecodingOptions 为准。3. 为什么降采样比解码后缩放更有效?以 RGBA_8888 为例:如果一次同时解码 5 张 4000×3000 的 RGBA 图片,光像素数据就可能占用约 229 MiB,还没有计算源文件缓存、编码缓冲、图片副本和 UI 显示资源。因此,应尽量在解码时降低分辨率,而不是先完整解码,再调用 scale() 缩小。4. 确实需要同时持有多张 PixelMap 怎么办?推荐按照以下优先级优化:先缩小再持有:拼接和对比界面优先使用适合显示尺寸的 PixelMap。限制同时驻留数量:例如只持有当前可见的 2~3 张缩略图。优先落盘:原图或压缩后的中间结果存入缓存文件,不长期驻留 Native 内存。复用工作缓冲:C++ 图像处理场景可结合 NAPI 管理可复用的处理资源。按需选择像素格式:没有透明度要求时可评估更低内存占用的格式,但要确认解码器、图像算法和编码器是否支持。YUV420 的理论像素数据量约为 RGBA_8888 的 37.5%,但并不是所有 ArkTS 图像处理接口都能直接使用 YUV PixelMap。不能简单地把 pixelFormat 改为 YUV 就认为可以节省内存。C API 与 ArkTS API 在像素格式、内存分配器、直接操作像素缓冲等方面存在能力差异,复杂的 YUV 数据处理更适合在 Native 层评估。三、BLE 和图片处理要不要拆到 TaskPool?建议拆分,但不建议把 BLE 连接管理器和 PixelMap 都直接跨线程传来传去。推荐架构:1. TaskPool 与 Worker 怎么选择?任务推荐BLE 状态管理、监听回调统一连接管理器单张图片独立压缩TaskPool批量图片压缩TaskPool + 并发限制需要长期维护关联任务和缓存WorkerUI 图片展示ArkUI 主线程华为提供了 TaskPool 批量生成缩略图的实践案例,图片编解码也属于适合考虑并发执行环境的耗时任务。2. PixelMap 跨线程会发生所有权转移吗?不能默认认为跨线程传递 PixelMap 就意味着所有权转移。需要区分:ArkTS 普通对象的序列化传递。ArrayBuffer 等可转移对象的传输。PixelMap 通过系统支持的序列化或共享机制跨线程使用。Native C++ 原生指针及其内存所有权。这些机制并不完全相同。对于 PixelMap,是否能够直接作为 TaskPool 参数或返回值、是否复制底层数据、是否存在使用限制,应以目标 API 的并发传输能力为准。更稳妥的方案是工作线程接收文件路径,内部创建和释放 PixelMap,最终仅返回缩略图文件路径。这样可以避免多个线程共同持有同一个 Native 图像资源,减少重复释放、提前释放和数据竞争的风险。四、BLE 和 PixelMap 共通的资源管理原则建议在项目中统一执行以下规则:原则BLE图片处理明确所有权一个连接管理器维护一个 GattClient一个处理任务管理自己的图像资源避免重复创建重连时避免同时创建多个客户端避免反复全尺寸解码异步操作完成后释放先终止旧连接任务,再关闭客户端await 编解码完成后释放限制并发单设备串行连接与重连限制同时处理的图片数量防止旧任务干扰新任务使用连接会话版本号使用图片任务 ID 和取消标记统一异常清理取消重试、注销监听、关闭客户端finally 释放 ImageSource、PixelMap、Packer另外,页面关闭时不要直接释放正在被异步操作使用的资源,而应该先标记任务取消,停止新任务进入,等待正在执行的操作安全结束,再释放对应资源。五、建议优先修改的地方按照实际收益,推荐先处理这五项:BLE 只保留一个连接管理器,防止断连回调重复发起 connect()。GattClient 重连失败达到阈值时,注销旧监听并关闭旧实例,再重新发现和创建。图片解码时就使用 desiredSize 降采样,不再一次解码多张全尺寸图片。图片编码使用 await + finally,避免未完成编码就释放 PixelMap。图片任务通过有界队列进入 TaskPool,主线程只接收缩略图路径。建议重点观察 BLE 活跃客户端数量、重连成功率、Native Heap 峰值、图片并发数量和页面帧率。这样能区分真正的资源泄漏与正常的短时内存峰值。官方参考Connectivity Kit:BLE 扫描与连接状态常见问题Image Kit:异步编码提前释放导致崩溃等常见问题TaskPool 与 Worker 并发任务开发长时任务 BackgroundMode API最终建议: 这两个问题最值得先收口的并不是某个单独的 close() 或 release() 调用,而是建立统一的资源所有权和任务生命周期。BLE 由连接管理器统一创建、重连和销毁;图片由独立处理任务创建、编码、释放;页面只消费结果,不直接管理底层资源。这样即使页面退出、设备突然断连或图片任务失败,也能让资源按照明确的规则安全退出。
点赞
回复于5天前
我的项目需要在鸿蒙App中接收超声波,由于需要与基站进行时钟同步,精度要求在亚毫秒级,因此需要获取非常准确的麦克风录音的起始时间,申请了系统权限可使用下面的方式调用,部分机型是可行且准确的,但有一些机型获取的时间戳是上一次录音的起始时间,导致了300ms左右的差异,请问是否有办法处理?

评论13

浏览 142

发布于2026-10-22 08:29
Z
|
推荐答复
nearby_record_time 是硬件厂商自定义参数,getAudioParameter 本身从 API 11 起已废弃,官方文档明确说"不同设备平台所支持的参数会存在差异"——这就是你遇到的机型不一致的根因。这个参数不是标准音频 API 的一部分,行为不可控,不建议继续依赖。应该用 AudioCapturer 的标准时间戳 API,有三个层次可选:getAudioTime() / getAudioTimeSync()(API 8+):返回纳秒级时间戳,但只给时间不给帧位置,精度够用但缺少帧位置信息来做更精确的校准。文档:AudioCapturergetAudioTimestampInfo() / getAudioTimestampInfoSync()(API 19+):返回 AudioTimestampInfo,同时包含 timestamp(纳秒)和 framePos(帧位置),可以精确关联"哪个帧在什么时刻被采集到",这才是你做时钟同步真正需要的。如果你最低支持 API 19,优先用这个。Native 层 OH_AudioCapturer_GetTimestamp()(API 10+):C 接口,参数 clockid_t 指定时钟源(建议 CLOCK_MONOTONIC),输出 framePosition + timestamp(纳秒),等价于方案 2 但在更早 API 版本可用,且直接操作硬件时钟源,精度和一致性最好。文档:native_audiocapturer.h建议方案:如果项目对时间精度要求亚毫秒级,用 Native 层 OH_AudioCapturer_GetTimestamp 搭配 CLOCK_MONOTONIC,在 start() 之后、on('readData') 首次回调时取一次时间戳作为录音起始时间。这样拿到的是音频 HAL 层实际采集时间,不依赖厂商自定义参数,跨机型一致。ArkTS 方案(API 19+)示例:import { audio } from '@kit.AudioKit'; let audioCapturer: audio.AudioCapturer | null = null; let audioStreamInfo: audio.AudioStreamInfo = { samplingRate: audio.AudioSamplingRate.SAMPLE_RATE_48000, channels: audio.AudioChannel.CHANNEL_1, sampleFormat: audio.AudioSampleFormat.SAMPLE_FORMAT_S16LE, encodingType: audio.AudioEncodingType.ENCODING_TYPE_RAW }; let audioCapturerInfo: audio.AudioCapturerInfo = { source: audio.SourceType.SOURCE_TYPE_MIC, capturerFlags: 0 }; let audioCapturerOptions: audio.AudioCapturerOptions = { streamInfo: audioStreamInfo, capturerInfo: audioCapturerInfo }; audio.createAudioCapturer(audioCapturerOptions).then((capturer: audio.AudioCapturer) => { audioCapturer = capturer; audioCapturer.on('readData', (buffer: ArrayBuffer) => { if (audioCapturer !== null) { let info: audio.AudioTimestampInfo = audioCapturer.getAudioTimestampInfoSync(); let timestampNs: number = info.timestamp; let framePos: number = info.framePos; let timestampMs: number = timestampNs / 1_000_000; console.info(`Recording timestamp: ${timestampMs}ms, framePos: ${framePos}`); } }); audioCapturer.start(); });Native C 方案(API 10+,推荐)示例:#include <ohaudio/native_audiocapturer.h> #include <time.h> // 在 start 之后首次 readData 回调中调用 int64_t framePosition = 0; int64_t timestampNs = 0; OH_AudioStream_Result result = OH_AudioCapturer_GetTimestamp(capturer, CLOCK_MONOTONIC, &framePosition, &timestampNs); if (result == AUDIOSTREAM_SUCCESS) { // timestampNs 就是该帧实际被采集的纳秒时间戳 // framePosition 可用来反推第一帧的时间: // 起始时间 = timestampNs - (framePosition / samplingRate) * 1e9 }关于你日志里的"返回上一次录音时间戳"问题:这是 nearby_record_time 参数在部分机型上没有及时更新的 bug,切到标准 API 后不会出现。另外 onReadData 回调文档提到"录音启动后前 100ms 数据会做静音处理消除上电杂音",如果你需要那 100ms 内的时间信息,也要注意这个行为。
点赞1
回复于2026-10-23 03:13
在做一个后台数据处理的模块,主线程负责 UI 和系统能力采集,Worker 线程跑轨迹计算和文件落库。结果两条路都走得很不顺。先说 Worker 这条线。 我把一部分计算逻辑抽成了独立的 ArkTS 模块,在 Worker 里用 napi_load_module 动态加载。但这个模块内部 import 了 @kit.LocationKit,加载进来一调用就报 binding = undefined。同一个模块放主线程里完全正常,LocationKit 接口都能调,一到 Worker 就废了。后来才搞明白,Worker 线程的 JS 引擎是隔离环境,不会自动注入系统 Kit 的 native binding。napi_load_module 只负责在当前 Runtime 里加载模块,不会给 Worker 补齐 UIAbilityContext 或某个 Kit 所需的运行环境。官方答复里甚至给了个大致边界:util、crypto、纯 ArkTS 模块、不依赖系统能力的自研 NAPI 扩展可以在 Worker 用;而 UI、AbilityContext、Location、Media、Camera 这些依赖主线程环境的 Kit 基本不行。我现在的困惑是:这个边界应该怎么系统性地判断,而不是靠零散清单? 官方说“以具体 API 文档的线程约束为准”,那我在设计阶段逐个翻 API 文档的“线程模型”说明,是唯一可靠的办法吗?有没有办法提前知道某个 Kit 的某个接口到底能不能在 Worker 里跑,而不是写完 NAPI 封装才发现调不通?napi_load_module_with_info 在 Worker 里加载模块时,会不会尝试补齐一些运行环境? 还是说它只是把模块文件读进来,binding 缺失的问题依然存在?如果我在 Worker 里必须加载一个依赖系统 Kit 的模块,除了“主线程采集、postMessage 丢纯数据”之外,还有没有别的架构空间?如果计算过程中 Worker 需要频繁回调主线程获取系统状态,这种来回通信的开销会不会把 Worker 的并行收益吃掉?官方建议的“主线程采集 → Worker 计算 → 结果回传”模式,在需要高频状态查询的场景下还成立吗?再说 IPC 这条线。 我需要把一批带缩略图的记录从 A 进程传到 B 进程,单次数据量超过了 200KB 的上限,直接报 1003702002 IPC data is oversized。IPC Kit 的文档写得很明确:单设备跨进程通信最大 200KB,超过必须用匿名共享内存(Ashmem)。我现在的困惑是:Ashmem 在 ArkTS 侧的完整链路到底怎么串? 创建共享内存、写入数据、通过 MessageSequence 传递句柄、对端映射读取、最后释放,这一整套在 ArkTS 层有可用的封装吗,还是必须下沉到 C API?共享内存的生命周期谁负责释放,会不会出现“传过去了但对端还没读完就被回收”的时序问题?如果暂时不走 Ashmem,分片传输的原子性怎么保证? 拆成多个 200KB 以内的消息依次发,中间某一片失败或者超时,对端怎么知道这批分片不完整、需要丢弃重传?有没有比较成熟的“批次 ID + 序号 + 总片数”协议可以参考,还是说应该让每条分片自带完整性校验?批量场景下偶发卡死,是不是同步 IPC 调用的阻塞问题? 我看到资料里提到同步 SendRequest 会在业务线程上阻塞等待 reply,没有超时机制,必须投递到独立线程并用 wait_for 设超时兜底。在 ArkTS 侧有没有办法避免主线程被同步 IPC 挂住,是应该改用异步接口,还是在业务层加一层超时封装?这两条线放在一起看,我总觉得“什么该留在主线程、什么能下沉到 Worker、大数据走哪条通道” 这三个决策是互相牵扯的:如果把 Kit 调用全压回主线程,主线程又可能被 IPC 同步调用堵住;如果把大数据全走 Ashmem,又得额外管理生命周期和分片协议。想请教一下有经验的大佬,这种场景下架构拆分的优先级应该怎么排,有没有一个可以先跑起来的“最小可靠骨架”。

评论5

浏览 43

发布于5天前
大雷神
|
推荐答复
先说两条线各自的结论:Worker 这条线没有捷径,边界只能按 API 文档的线程约束逐项判定;IPC 这条线 ArkTS 侧有完整的 Ashmem 封装,不用下沉到 C API——@ohos.rpc 里就有 Ashmem 类和 MessageSequence.writeAshmem/readAshmem。下面把接口名和调用链给全,避免再靠猜。一、200KB 是硬约束,官方指定出口是匿名共享内存《IPC Kit 简介》约束与限制原文:「单个设备上跨进程通信时,传输的数据量最大为200KB。超过200KB的数据量传输可以使用匿名共享内存。」你贴的 1003702002 就是这个约束拦下来的,不是参数写错。另外提醒一点:MessageSequence.setCapacity(size) 确实存在(用来设置该对象的存储容量 / 限制可写字节数),但它是调整序列化缓冲区,不是绕过跨进程单次传输上限的官方通道;官方对「超 200KB」给的唯一出口仍是匿名共享内存。二、Ashmem 在 ArkTS 侧的完整链路(全部来自官方 @ohos.rpc 声明,SystemCapability.Communication.IPC.Core)类 rpc.Ashmem 的可用方法:· static createAshmem(name: string, size: number): Ashmem / static createAshmemFromExisting(ashmem: Ashmem): Ashmem· mapReadWriteAshmem(): void / mapReadonlyAshmem(): void / mapTypedAshmem(mapType: int): void / setProtectionType(protectionType: int): void· writeToAshmem(buf: number[], size: number, offset: number): boolean / readFromAshmem(size: number, offset: number): number[]· getAshmemSize(): int / unmapAshmem(): void / closeAshmem(): voidMessageSequence 侧:writeAshmem(ashmem: Ashmem): void 与 readAshmem(): Ashmem,官方注释明确要求「This method must be used in pairs with the readAshmem() method.」——写入方 writeAshmem,接收方 readAshmem 取回对象。所以链路是:发送端 createAshmem → mapReadWriteAshmem → writeToAshmem → writeAshmem 进 MessageSequence 发送;接收端 readAshmem → mapReadonlyAshmem → readFromAshmem → unmapAshmem → closeAshmem。传过去的是共享内存对象的句柄,不是那批数据本身,所以不受 200KB 限制。三、生命周期与时序(你担心的「对端还没读完就被回收」)① 释放顺序:先 unmapAshmem() 再 closeAshmem(),两者都要做——只 close 不 unmap,映射还在,内存不会立刻释放;只 unmap 不 close,句柄泄漏。② 发送端何时 close:不要以「writeAshmem 返回」为判据,那只能说明句柄写进了消息,不代表对端已经 readAshmem。建议在协议层加一个「已接收」应答(或让接收端在读完后再回一条确认消息),收到确认后再 closeAshmem;跨进程异步场景下这是最省事的正确做法。③ 接收端不要在 readFromAshmem 之前 close:readAshmem 拿到的对象需要 map 之后才能读,先 close 会拿不到数据。④ 权限位:只在接收端读时用 mapReadonlyAshmem()(只读映射),不要两边都用读写映射,减少误写导致的脏数据。四、分片方案:官方没有现成协议,需要自己带批次语义如果暂时不上 Ashmem,分片必须自己保证原子性,最小字段集建议:batchId + seq + total + payloadLen + checksum,接收端按 batchId 聚合、按 seq 排序、等 total 齐了再提交,任一片超时/校验失败就整批丢弃并回 NACK 让发送端重传整批(不要只重传单片,否则序号与总片数会错位)。这套协议官方没有推荐实现,属于业务自建,别把它当成某个 API 的能力。五、Worker 这条线:可执行的判定规则没有「Worker 可用 Kit 总清单」这种官方文档,判定依据是每个 API 参考条目里的线程模型约束。工程上更稳的做法是结构上先隔离,而不是先写 NAPI 再试:把「需要上下文/系统服务的采集」和「纯计算」拆成两个模块,计算模块只依赖纯 ArkTS 数据结构与不依赖 UIAbilityContext 的工具类;napi_load_module 只负责在当前 Runtime 里加载模块,不会为 Worker 补齐缺失的 native binding——所以模块一旦 import 了依赖主线程环境的 Kit,在 Worker 里就是 binding undefined,这与你观察到的现象一致。真要高频回读系统状态,正确方向是把「状态快照」批量下发(主线程按固定节奏采集后 postMessage),而不是让 Worker 反向频繁同步调用。说明:200KB 约束与 Ashmem 接口签名来自官方文档与官方 SDK 声明核对,代码为接口片段、未在设备上编译运行;Ashmem 的实际吞吐与 close 时机建议在真机上用日志验证。依据(本轮已实际打开核对):《IPC Kit 简介》(200KB 约束与匿名共享内存原句):https://device.harmonyos.com/cn/docs/apiref/harmonyos-guides/ipc-rpc-overview接口签名核对自官方 @ohos.rpc 声明文件(Ashmem 类、MessageSequence.writeAshmem/readAshmem、setCapacity)。
点赞
回复于5天前
在开发鸿蒙应用时,自定义控件内部包含多个可交互子组件,如何在用户操作时正确控制焦点的获取与释放,避免焦点丢失或误触?是否有推荐的焦点管理策略?

评论9

浏览 81

发布于5天前
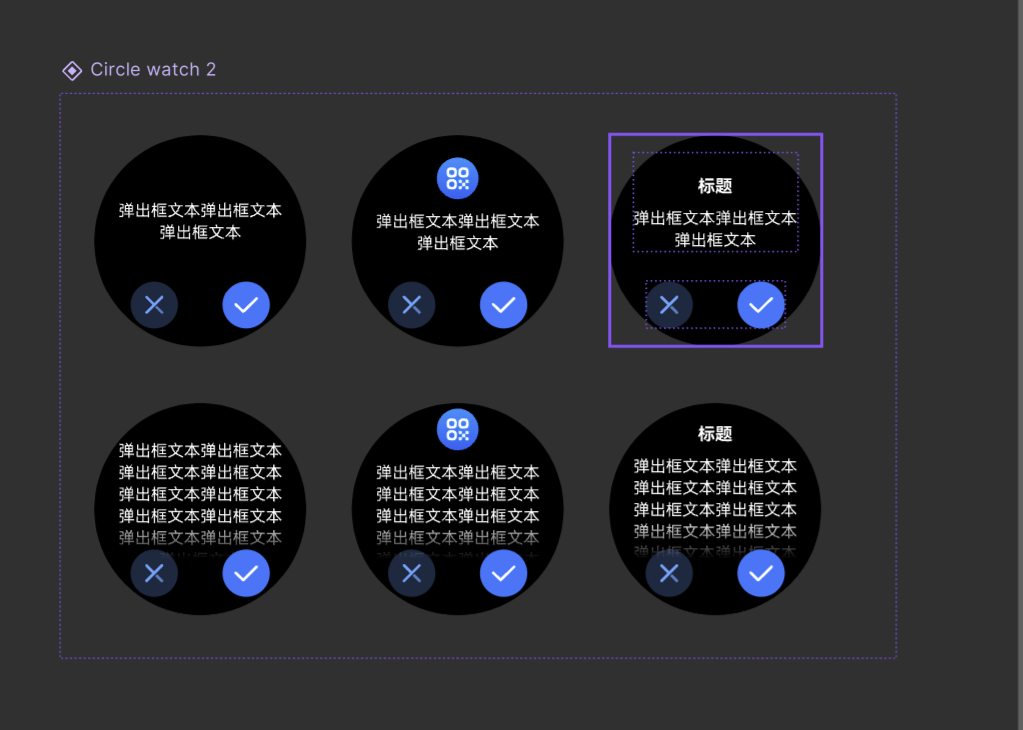
如题,找不到调用这种弹出框的方法

评论14

浏览 131

发布于6天前
明先生
|
技术支持
手表端用的就是 ArkUI 的标准弹窗组件,没有单独的"手表专用弹窗"组件。您提供的设计样式的弹框需要使用自定义弹框CustomDialog 实现。比如弹窗里放自定义按钮、文本列表等。具体可以参考官网:自定义弹窗文档如下示例代码可以参考:@CustomDialog struct CustomDialogExample { controller?: CustomDialogController; build() { Column() { Text('标题') .fontSize(18) .fontWeight(300) .height(20) Text('弹出框文本弹出框文本弹出框文本弹出框文本') .margin({top:10}) .fontSize(16) .height(40) .width('80%') Row(){ Button('×') .backgroundColor('#ff1c73a2') .margin({top:10,right:10}) .onClick(() => { if (this.controller != undefined) { this.controller.close(); console.info('用户点击取消'); } }) .width(50) .height(50) .borderRadius(25) Button('✓') .backgroundColor('#ff1742bf') .margin({top:10,left:10}) .onClick(() => { if (this.controller != undefined) { this.controller.close(); console.info('用户点击确认'); } }) .width(50) .height(50) .borderRadius(25) } .margin(10) } .justifyContent(FlexAlign.Center) .borderRadius(32) .backgroundColor(Color.Black) .shadow(ShadowStyle.OUTER_DEFAULT_SM) .width('100%') .height('100%') } } @Entry @Component struct CustomDialogUser { @State currentWidth: number = 0 dialogController: CustomDialogController | null = new CustomDialogController({ builder: CustomDialogExample(), backgroundColor:Color.Black, customStyle: true, isModal: false, }) build() { Column() { Button('CustomDialog') .margin(20) .onClick(() => { if (this.dialogController != null) { this.dialogController.open(); } }) } .width('100%') .height('100%') .justifyContent(FlexAlign.Center) } }
点赞
回复于5天前

我要提问题

月度答复贡献榜
用户头像
橙动创意
回帖1.1k
粉丝64
关注
用户头像
Z
回帖702
粉丝13
关注
用户头像
蓝瘦的蜕变
回帖510
粉丝135
关注
用户头像
心系天下
回帖489
粉丝21
关注
用户头像
飞b6
回帖471
粉丝16
关注
邀您回答
海泰浏览器扩展程序开发
mate70pro+相机拍照微微偏红
页面销毁后网络请求回调更新状态如何避免崩溃?
ArkUI Canvas 离屏 PixelMap 在后台切回来之后偶尔变黑、纹理丢失,怎么做生命周期恢复与缓存校验?
热门标签
1

HarmonyOS 5

2

HarmonyOS 6

3

DevEco Studio

4

UI

5

HarmonyOS

6

ArkUI (方舟UI框架)

7

HarmonyOS 7

8

App开发

9

Ability框架

了解社区公约,与您携手共创和谐专业的开发者社区。
在 App 中查看