















版权声明:本文为博主原创文章,遵循 CC 4.0 BY-SA 版权协议,转载请附上原文出处链接和本声明。
本文链接:https://blog.csdn.net/weixin_43931438/article/details/103333465
利用Python分析《庆余年》人物图谱和微博传播路径
庆余年电视剧终于在前两天上了,这两天赶紧爬取微博数据看一下它的表现。
庆余年
《庆余年》是作家猫腻的小说。这部从2007年就开更的作品拥有固定的书迷群体,也在文学IP价值榜上有名。
期待已久的影视版的《庆余年》终于播出了,一直很担心它会走一遍《盗墓笔记》的老路。
在《庆余年》电视剧上线后,就第一时间去看了,真香。
庆余年微博传播分析
《庆余年》在微博上一直霸占热搜榜,去微博看一下大家都在讨论啥:
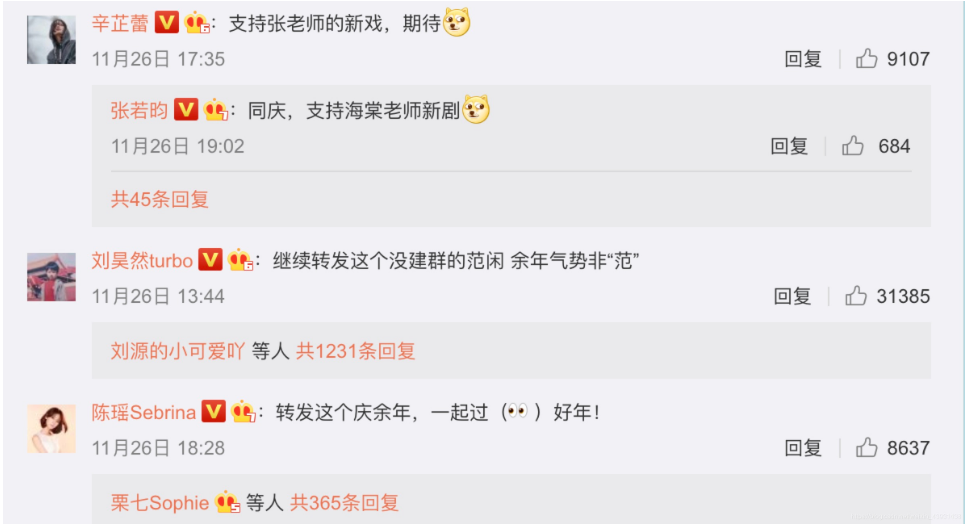
一条条看显然不符合数据分析师身份。
于是爬取了微博超话页面,然后找到相关人员,分别去爬取相关人员的微博评论,看看大家都在讨论啥。
import re
import time
import copy
import pickle
import requests
import argparse
'''微博爬虫类'''
class weibo():
def __init__(self, **kwargs):
self.login_headers = {
'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/72.0.3626.109 Safari/537.36',
'Accept': '*/*',
'Accept-Encoding': 'gzip, deflate, br',
'Accept-Language': 'zh-CN,zh;q=0.9,en;q=0.8',
'Connection': 'keep-alive',
'Origin': 'https://passport.weibo.cn',
'Referer': 'https://passport.weibo.cn/signin/login?entry=mweibo&r=https%3A%2F%2Fweibo.cn%2F&backTitle=%CE%A2%B2%A9&vt='
}
self.login_url = 'https://passport.weibo.cn/sso/login'
self.home_url = 'https://weibo.com/'
self.headers = {
'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/72.0.3626.109 Safari/537.36',
}
self.session = requests.Session()
self.time_interval = 1.5
'''获取评论数据'''
def getComments(self, url, url_type='pc', max_page='all', savename=None, is_print=True, **kwargs):
# 判断max_page参数是否正确
if not isinstance(max_page, int):
if max_page != 'all':
raise ValueError('[max_page] error, weibo.getComments -> [max_page] should be <number(int) larger than 0> or <all>')
else:
if max_page < 1:
raise ValueError('[max_page] error, weibo.getComments -> [max_page] should be <number(int) larger than 0> or <all>')
# 判断链接类型
if url_type == 'phone':
mid = url.split('/')[-1]
elif url_type == 'pc':
mid = self.__getMid(url)
else:
raise ValueError('[url_type] error, weibo.getComments -> [url_type] should be <pc> or <phone>')
# 数据爬取
headers = copy.deepcopy(self.headers)
headers['Accept'] = 'application/json, text/plain, */*'
headers['MWeibo-Pwa'] = '1'
headers['Referer'] = 'https://m.weibo.cn/detail/%s' % mid
headers['X-Requested-With'] = 'XMLHttpRequest'
url = 'https://m.weibo.cn/comments/hotflow?id={}&mid={}&max_id_type=0'.format(mid, mid)
num_page = 0
comments_data = {}
while True:
num_page += 1
print('[INFO]: Start to get the comment data of page%d...' % num_page)
if num_page > 1:
url = 'https://m.weibo.cn/comments/hotflow?id={}&mid={}&max_id={}&max_id_type={}'.format(mid, mid, max_id, max_id_type)
res = self.session.get(url, headers=headers)
comments_data[num_page] = res.json()
if is_print:
print(res.json())
try:
max_id = res.json()['data']['max_id']
max_id_type = res.json()['data']['max_id_type']
except:
break
if isinstance(max_page, int):
if num_page < max_page:
time.sleep(self.time_interval)
else:
break
else:
if int(float(max_id)) != 0:
time.sleep(self.time_interval)
else:
break
if savename is None:
savename = 'comments_%s.pkl' % str(int(time.time()))
with open(savename, 'wb') as f:
pickle.dump(comments_data, f)
return True
'''模拟登陆'''
def login(self, username, password):
data = {
'username': username,
'password': password,
'savestate': '1',
'r': 'https://weibo.cn/',
'ec': '0',
'pagerefer': 'https://weibo.cn/pub/',
'entry': 'mweibo',
'wentry': '',
'loginfrom': '',
'client_id': '',
'code': '',
'qq': '',
'mainpageflag': '1',
'hff': '',
'hfp': ''
}
res = self.session.post(self.login_url, headers=self.login_headers, data=data)
if res.json()['retcode'] == 20000000:
self.session.headers.update(self.login_headers)
print('[INFO]: Account -> %s, login successfully...' % username)
return True
else:
raise RuntimeError('[INFO]: Account -> %s, fail to login, username or password error...' % username)
'''获取PC端某条微博的mid'''
def __getMid(self, pc_url):
headers = copy.deepcopy(self.headers)
headers['Cookie'] = 'SUB=_2AkMrLtDRf8NxqwJRmfgQzWzkZI11ygzEieKdciEKJRMxHRl-yj83qhAHtRB6AK7-PqkF1Dj9vq59_dD6uw4ZKE_AJB3c;'
res = requests.get(pc_url, headers=headers)
mid = re.findall(r'mblog&act=(\d+)\\', res.text)[0]
return mid
if __name__ == '__main__':
import argparse
parser = argparse.ArgumentParser(description="weibo comments spider")
parser.add_argument('-u', dest='username', help='weibo username', default='')
parser.add_argument('-p', dest='password', help='weibo password', default='')
parser.add_argument('-m', dest='max_page', help='max number of comment pages to crawl(number<int> larger than 0 or all)', default=100)
parser.add_argument('-l', dest='link', help='weibo comment link', default='')
parser.add_argument('-t', dest='url_type', help='weibo comment link type(pc or phone)', default='pc')
args = parser.parse_args()
wb = weibo()
username = args.username
password = args.password
try:
max_page = int(float(args.max_page))
except:
pass
**加粗样式**url = args.link
url_type = args.url_type
if not username or not password or not max_page or not url or not url_type:
raise ValueError('argument error')
wb.login(username, password)
wb.getComments(url, url_type, max_page)
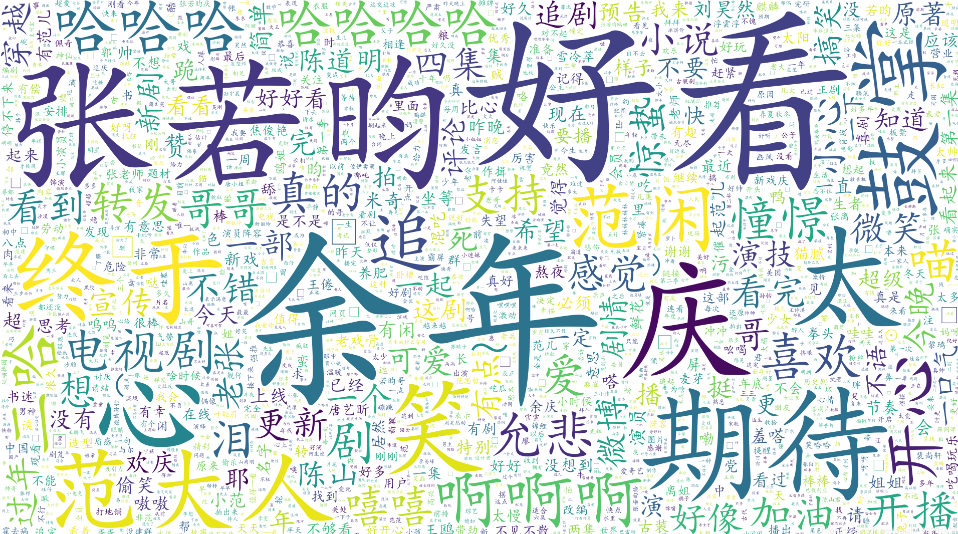
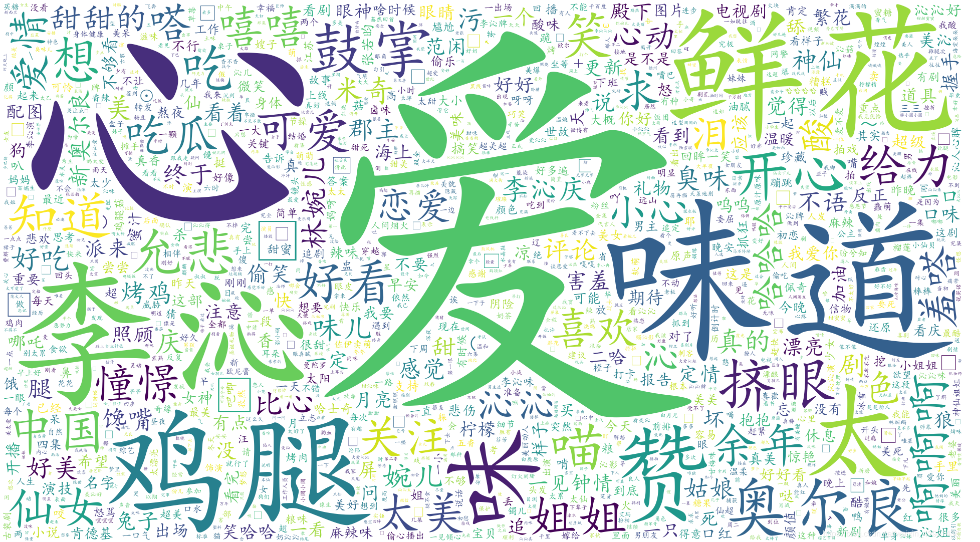
爬取到微博评论后,老规矩,词云展示一下,不同主角的评论内容差别还是挺大的
微博评论词云分析
不同主演的评论风格差异较大,也与微博内容息息相关。
张若昀:
李沁:
肖战:
emmm…算了吧
从目前大家的评论来看,情绪比较正向,评价较高,相信《庆余年》会越来越火的。
这部剧在微博热度这么高,都是谁在传播呢?
于是我进一步点击用户头像获取转发用户的公开信息。
看了一下几位主演的相关微博,都是几十万的评论和转发,尤其是肖战有百万级的转发,尝试爬了一下肖战的微博,执行了6个小时只爬了十分之一。
最终还是败给了各位小飞侠,之后有结果再同步给大家。
于是我只能挑软柿子捏,换成官微的微博。
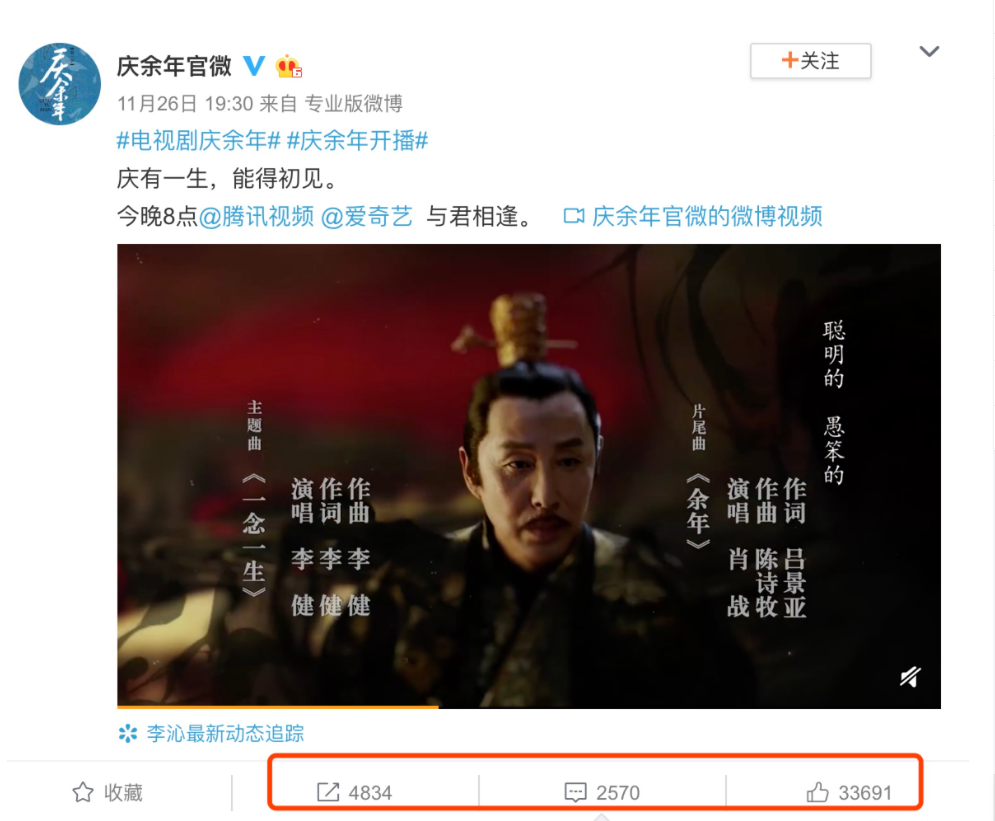
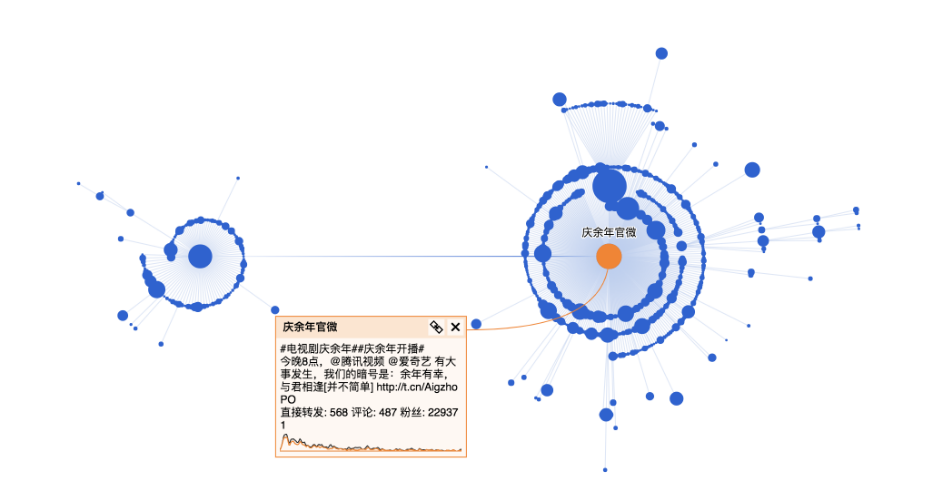
这条微博发布时间是26号,经过一段时间已经有比较好的传播,其中有几个关键节点进一步引爆话题。
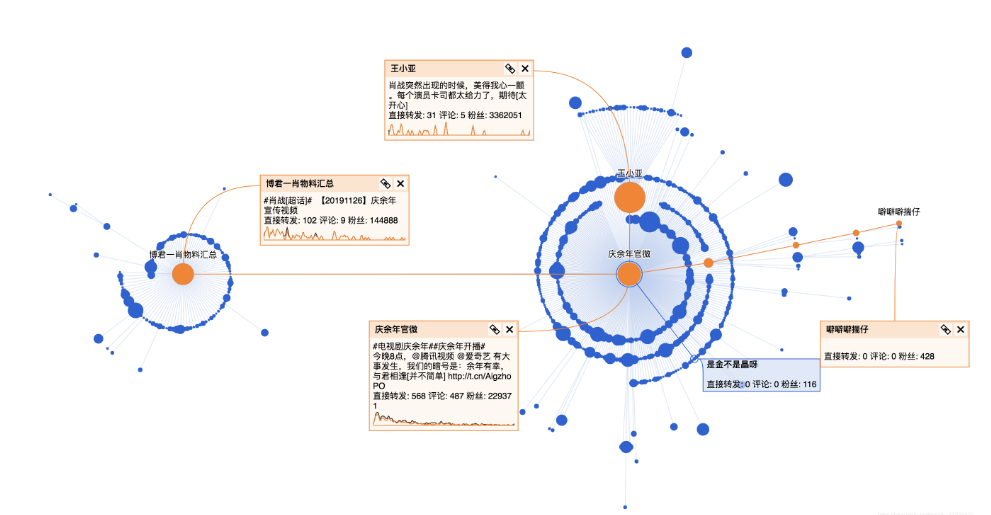
经过几个关键节点后,进一步获得传播,这几个关键节点分别是:
肖战的超话:https://weibo.com/1081273845/Ii1ztr1BH
王小亚的微博:https://weibo.com/6475144268/Ii1rDEN6q
继续看一下转发该微博的用户分析:
进一步了解转发微博的受众,掌握传播范围和深度。
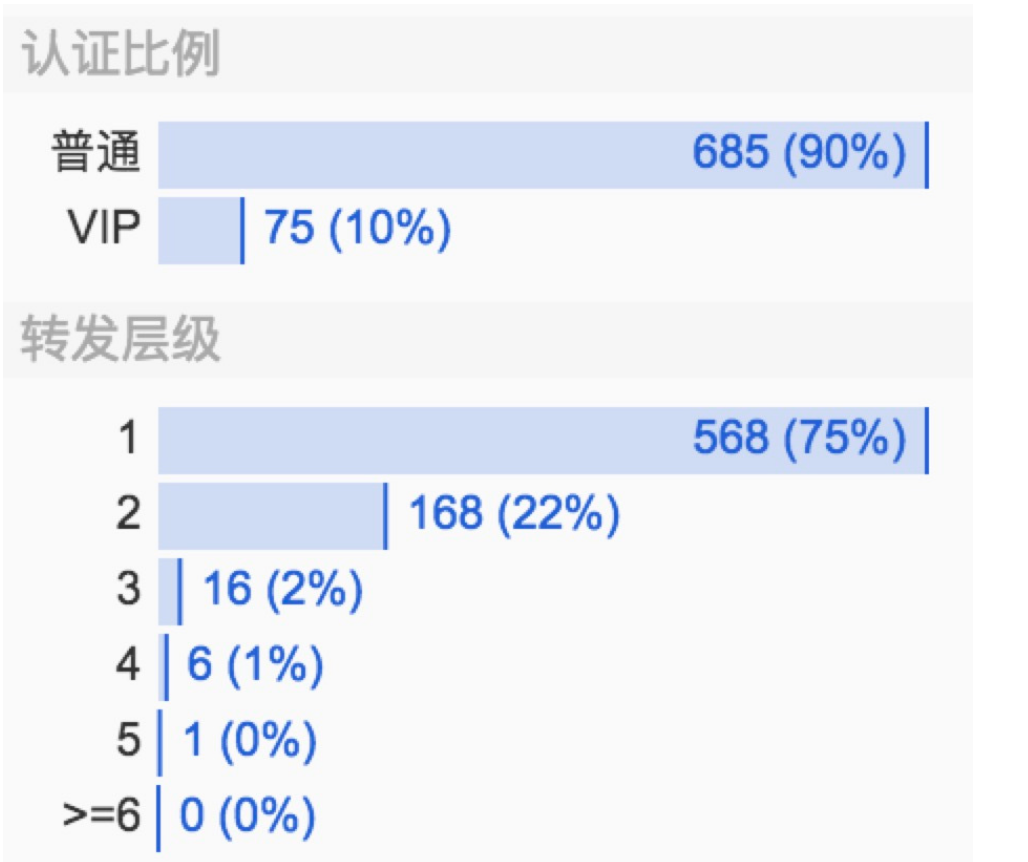
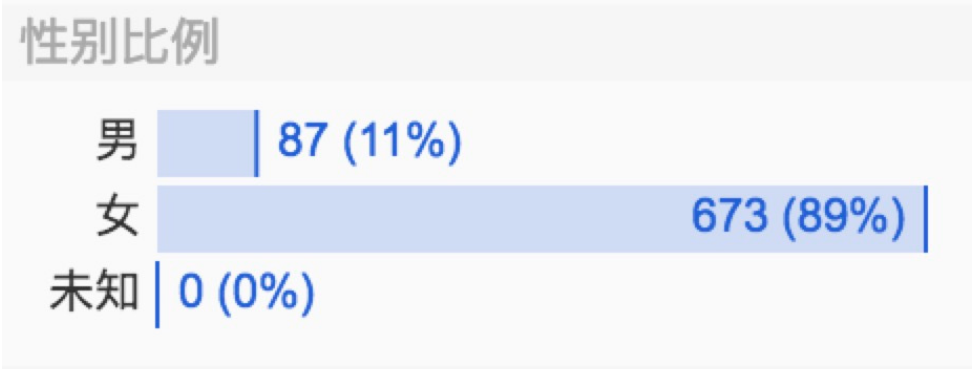
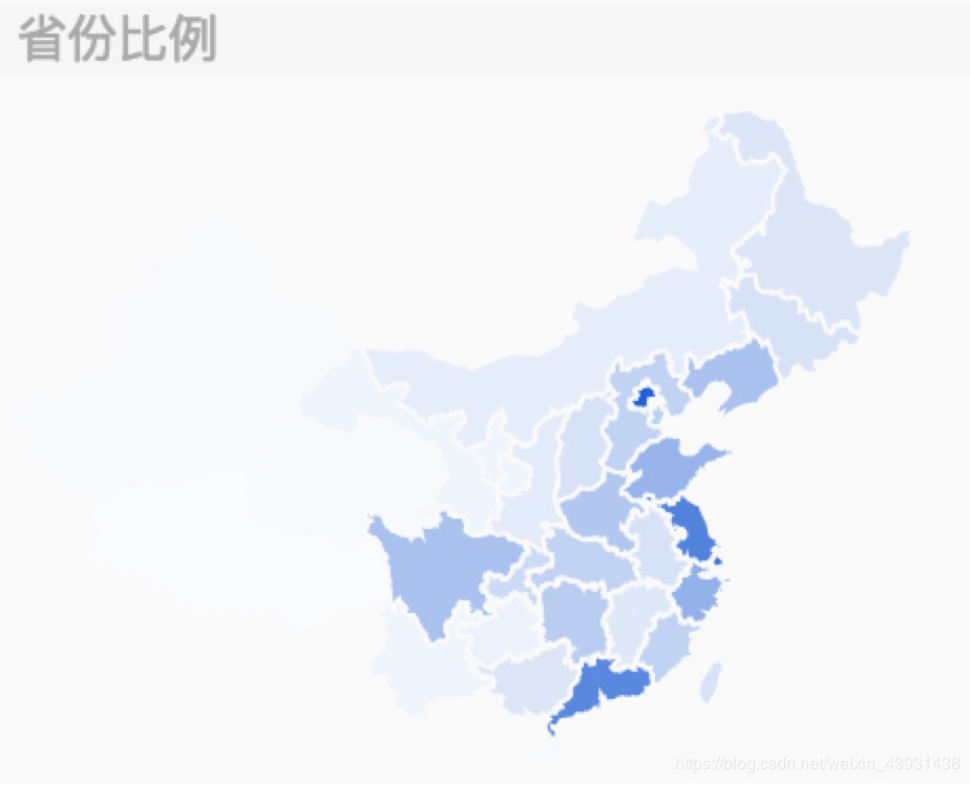
整体看下来,庆余年官微的这条微博90%都是普通用户的转发,这部剧转发层级达到5层,传播范围广,在微博上的讨论女性居多(占比89%),大部分集中在一二线城市。
原著人物关系图谱
如果只看微博,不分析原著,那就不是一个合格的书粉。
于是我去下载了原著画一下人物关系图谱。
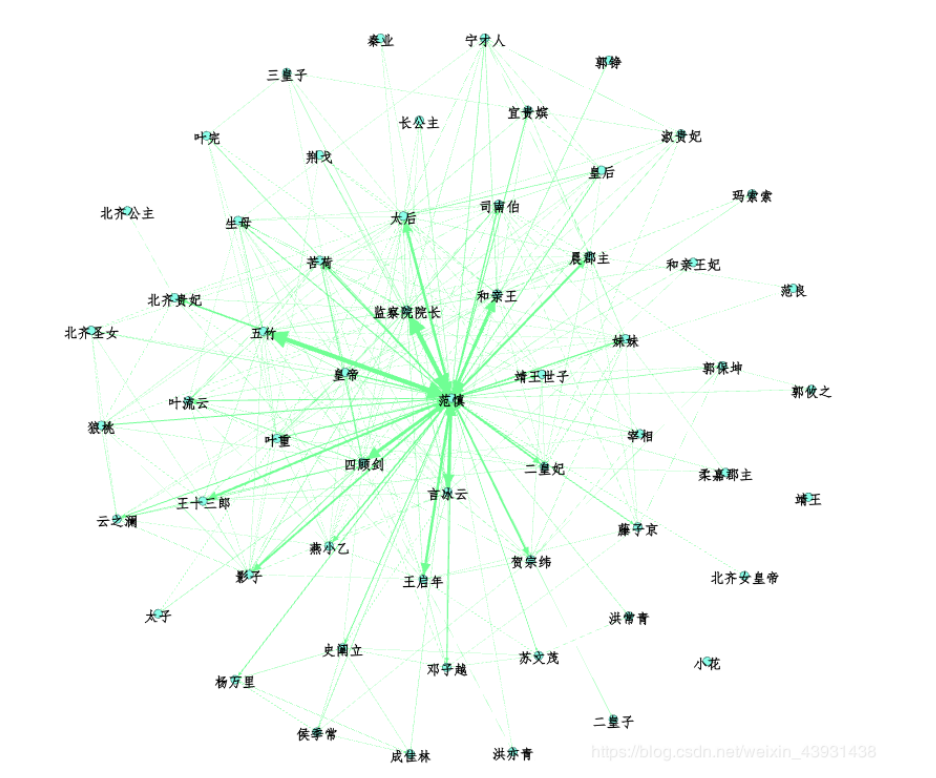
先给大家看一下原著的人物关系图谱:
emmm…确实挺丑的,大家可以去Gephi上调整。
首先我需要从原著里洗出人物名,尝试用jieba分词库来清洗:
import jieba
test= 'temp.txt' #设置要分析的文本路径
text = open(test, 'r', 'utf-8')
seg_list = jieba.cut(text, cut_all=True, HMM=False)
print("Full Mode: " + "/ ".join(seg_list)) # 全模式
生成一个适合你的列表
发现并不能很好的切分出所有人名,最简单的方法是直接准备好人物名称和他们的别名,这样就能准确定位到人物关系。
存储好人物表,以及他们对应的别名(建立成字典)
def synonymous_names(synonymous_dict_path):
with codecs.open(synonymous_dict_path, 'r', 'utf-8') as f:
lines = f.read().split('\n')
for l in lines:
synonymous_dict[l.split(' ')[0]] = l.split(' ')[1]
return synonymous_dict
接下来,清理文本数据:
def clean_text(text):
new_text = []
text_comment = []
with open(text, encoding='gb18030') as f:
para = f.read().split('\r\n')
para = para[0].split('\u3000')
for i in range(len(para)):
if para[i] != '':
new_text.append(para[i])
for i in range(len(new_text)):
new_text[i] = new_text[i].replace('\n', '')
new_text[i] = new_text[i].replace(' ', '')
text_comment.append(new_text[i])
return text_comment
我们需要进一步统计人物出现次数,以及不同人物间的共现次数:
text_node = []
for name, times in person_counter.items():
text_node.append([])
text_node[-1].append(name)
text_node[-1].append(name)
text_node[-1].append(str(times))
node_data = DataFrame(text_node, columns=['Id', 'Label', 'Weight'])
node_data.to_csv('node.csv', encoding='gbk')
结果样例如下:
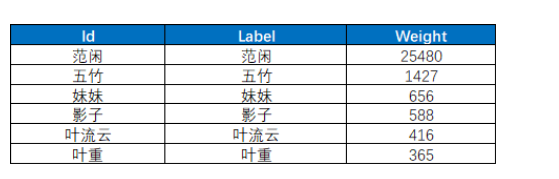
不愧是主角,范闲出现的次数超过了其他人物出现次数的总和,基本每个人都与主角直接或间接地产生影响。
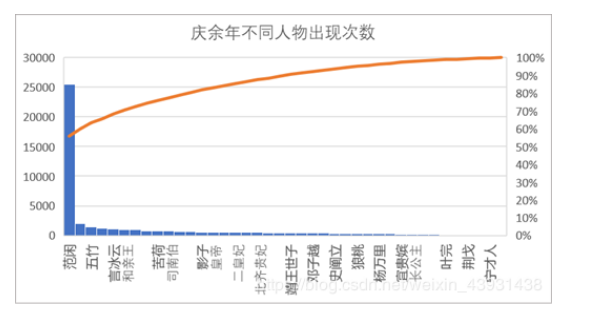
同理可以得到不同人物的边,具体代码参考源文件。
接下来需要做的就是利用Gephi绘制人物关系图谱:
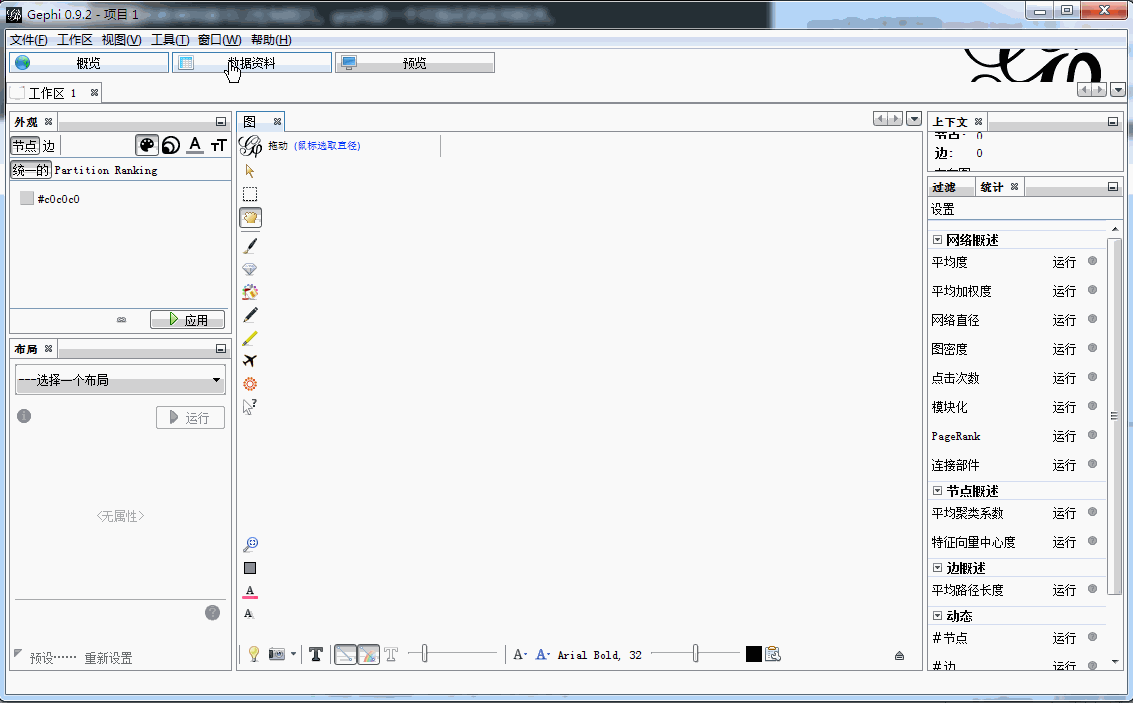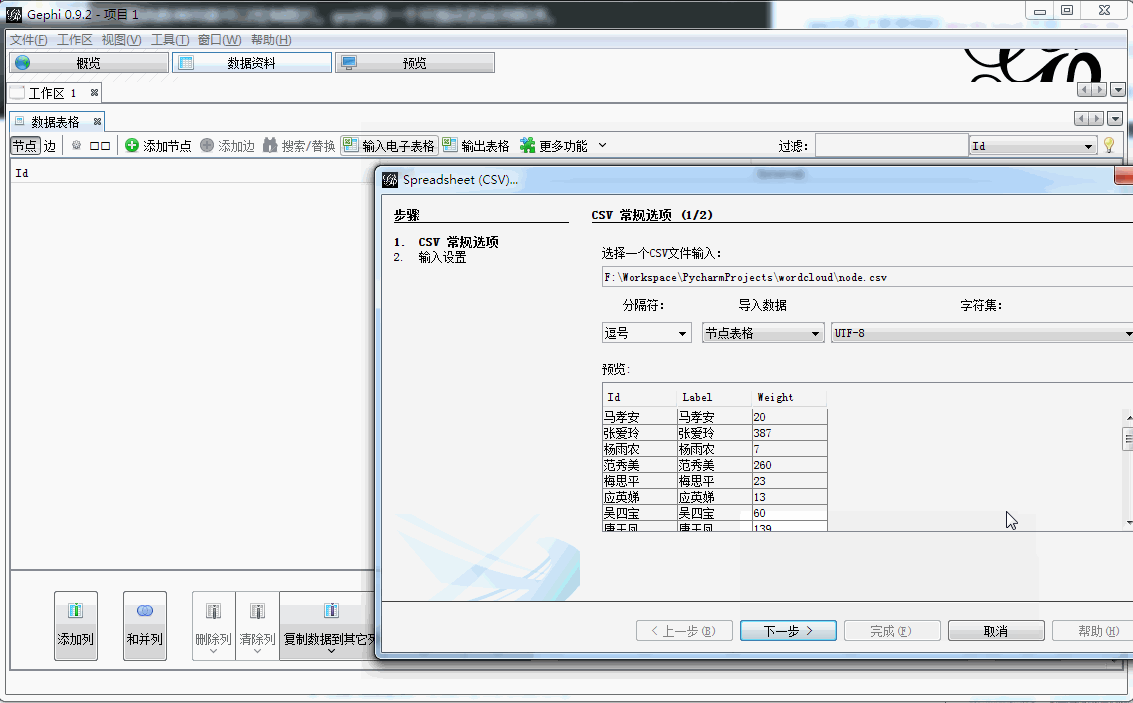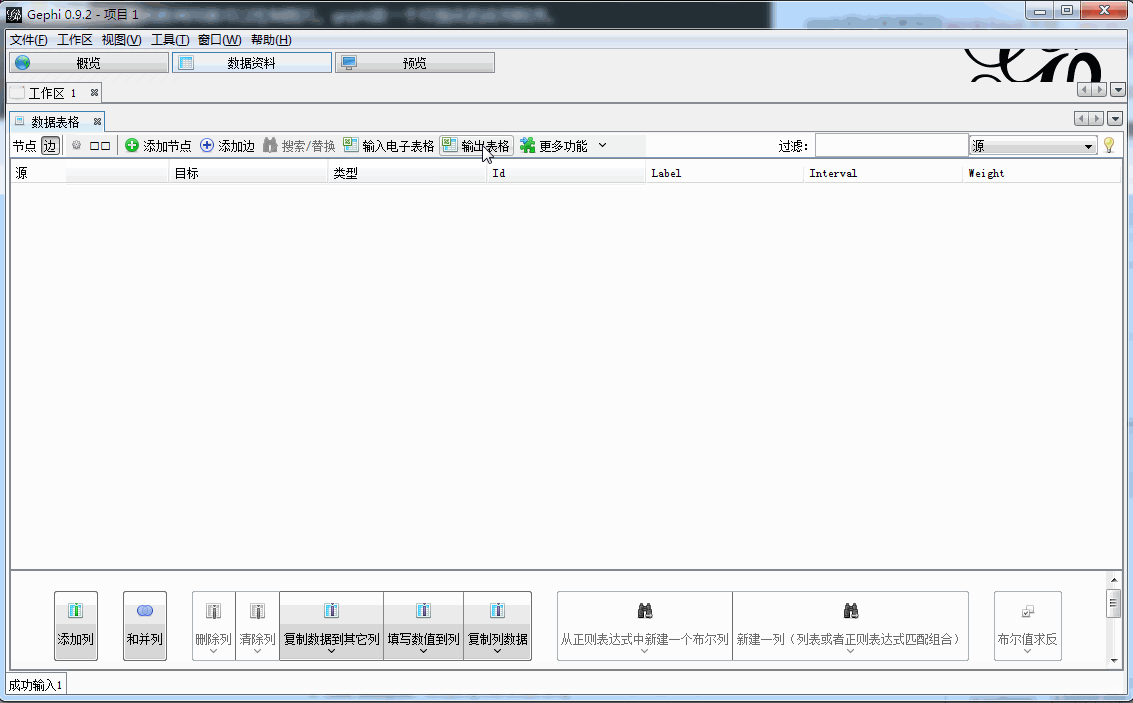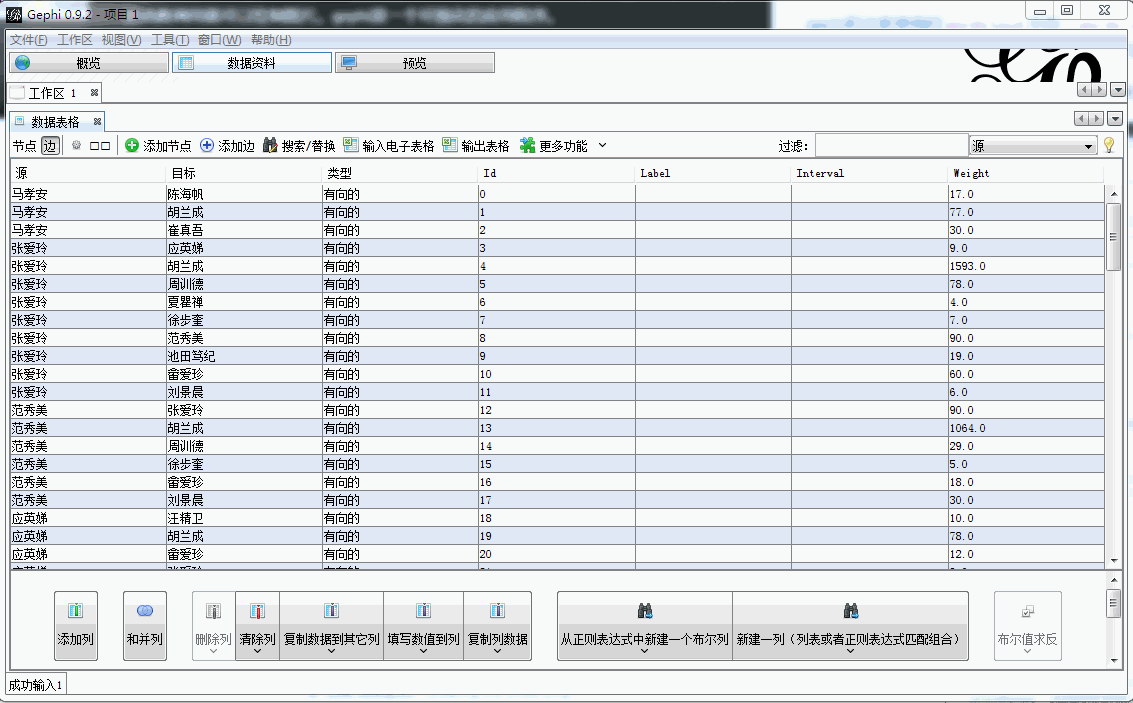
运行结果:
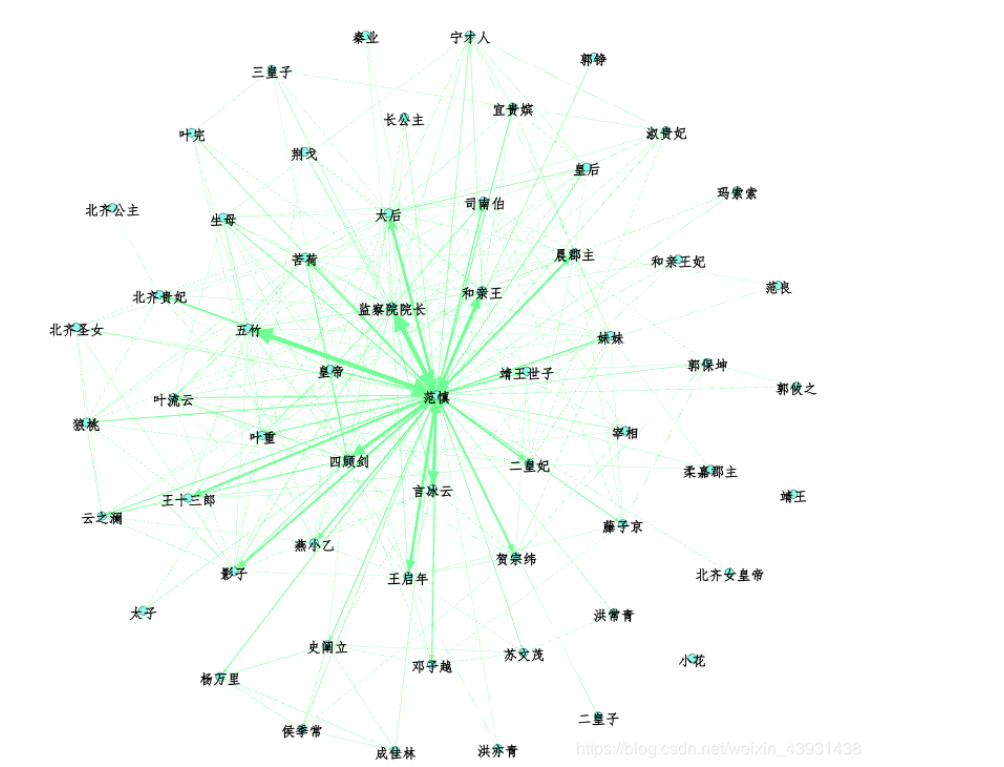
参考文献:Ren, Donghao, Xin Zhang, Zhenhuang Wang, Jing Li, and Xiaoru Yuan. “WeiboEvents: A Crowd Sourcing Weibo Visual Analytic System.” In Pacific Visualization Symposium (PacificVis) Notes, 2014 IEEE, pp. 330-334. IEEE, 2014.
有任何问题,欢迎私信。
————————————————
版权声明:本文为CSDN博主「数据札记-A字头」的原创文章,遵循 CC 4.0 BY-SA 版权协议,转载请附上原文出处链接及本声明。
原文链接:https://blog.csdn.net/weixin_43931438/article/details/103333465


 苏公安网备 32011402010933号