














 尼克森
HarmonyOS
HarmonyOS 应用如何做好版本兼容与灰度期间的线上问题止损?
HarmonyOS 应用如何做好版本兼容与灰度期间的线上问题止损?
应用发版之后,用户手里的版本是不可控的——有刚升级到最新版的,也有停留在几个旧版本上的,还有通过应用市场分批灰度、只覆盖了一部分机型的。如果新版本引入了某个只在特定系统版本或特定机型上出现的问题,怎么才能快速发现、快速定位受影响范围、并把损失控制住?
我们现在的做法和痛点
**问题反馈太分散**:崩溃统计、业务异常上报、用户反馈、客服工单、日志采集各自一套,排查时需要人工在几个后台之间来回切换,经常出现"其实已经有告警但没人看到"的情况。
**版本维度看不清**:线上出问题想统计"哪个版本、哪些机型、哪些系统版本、哪个渠道"的分布时,现有数据看板粒度不够,要临时拉数据,效率很低。
**止损手段不够快**:发现问题到"决定回滚"之间,链路比较长。往往需要多个角色确认,影响范围评估全靠人工估算。
**灰度策略偏粗**:目前是按用户量百分比放量,没有按机型、系统版本、地域等维度做精细化灰度,导致某些特定环境的问题被放大后才暴露。
**日志采集成本高**:全量采集日志会带来较大的存储和带宽成本,但又担心真出问题时没有现场数据可查。
想请教的问题
• 大家是怎么设计线上问题的统一观测入口的?崩溃、ANR、业务异常、性能劣化这些指标,应该收敛到一套什么样的看板结构? • 关于"按维度快速圈定受影响用户群",有没有推荐的做法?是打全量日志后做多维分析,还是靠上报时带上结构化维度字段? • 灰度发布策略上,除了按用户量放量,是否有基于设备/系统/地域维度的智能放量或自动止损机制?HarmonyOS 侧有没有相关能力可以借助? • 关于日志的分级采集和降级策略,如何在"关键时刻有现场数据"和"平时控制成本"之间取得平衡? • 线上问题止损的决策链路应该怎么设计,才能在分钟级别完成"发现问题 → 确认影响面 → 决定回滚或热修"?有没有可参考的流程实践? • 如果应用需要支持多版本长期共存,接口和数据的兼容性策略应该怎么规划,避免老版本用户被新版本"卡死"?


 快乐打工人
针对 HarmonyOS 应用版本兼容与灰度期间线上问题止损的六大痛点,基于 HarmonyOS 官方能力体系(AGC APMS 统一观测、分阶段发布与回退、HiAppEvent 结构化事件订阅、HiRetrieval 灰度采集、API 版本兼容机制),给出统一观测入口设计、受影响用户圈定、灰度策略优化、日志分级采集、止损决策链路、多版本接口兼容的完整实践方案。
您可以参考如下:
一、搭建统一观测入口
1. 开通 AGC APMS 服务:在 AppGallery Connect 控制台开通应用性能监测服务,ArkTS 应用运行在 HarmonyOS ROM ≥ 3.0.0.25 即可自动采集崩溃、ANR、OOM 等指标,无需额外集成 SDK。
2. 配置三层看板结构:
- 第一层(总览大盘):崩溃率、ANR 率、OOM 率、主线程超时率、资源泄漏率 KPI 曲线,来源为 APMS 故障指标页面。
- 第二层(异常分类):按 CPP_CRASH / JS_ERROR / OOM / PROCESS_KILL 四类分页签,APMS 自动按堆栈关键行聚类。
- 第三层(下钻分析):每个异常类下钻至应用版本 TOP5、系统版本 TOP5、设备型号 TOP5。
3. 配置 APMS 故障预警规则:设定监控时段、频率和触发阈值,满足条件后自动发送告警通知(邮件/短信)。
4. 如需定制化处理崩溃数据,通过 HiAppEvent 订阅 APP_CRASH、APP_FREEZE、RESOURCE_OVERLIMIT 等事件,在回调中获取结构化字段(bundle_version、cpu_abi、foreground、external_log 等),转发至自研分析平台。
二、按维度快速圈定受影响用户群
1. 端侧上报携带结构化维度:HiAppEvent 订阅崩溃事件时系统自动携带 bundle_version、bundle_name、cpu_abi、foreground、release_type、app_running_unique_id 等字段,无需额外编码。
2. 业务自定义维度(渠道、地域、用户分组等)通过 hiAppEvent.write() 打点自定义事件携带。
3. 利用 APMS 下钻分析能力,针对每个故障特征 ID 查看应用版本/系统版本/设备型号 TOP5 分布,分钟级圈定受影响范围。
三、优化灰度发布策略
1. 使用 AGC 分阶段发布:在开发者中心 → 应用管理 → 分发 → 版本信息 → 升级 → 发布类型选择"分阶段发布",首批放量 5%。
2. 观察 APMS 崩溃率指标,达标后逐步提升比例至 20% → 50% → 100%。
3. 发现异常时立即暂停分阶段发布(即时生效,无需审核),或取消分阶段发布(版本立即下架)。
4. 对特定机型/系统版本风险场景,通过 HiRetrieval 云端圈选目标设备精准采集故障日志,验证后再扩大灰度范围。
四、实施日志分级采集与降级
- L1(全量轻量指标):始终开启 HiAppEvent 订阅 APP_CRASH / APP_FREEZE / RESOURCE_OVERLIMIT 事件,仅采集结构化元数据,成本极低。
- L2(故障现场日志):故障发生时自动采集,HiAppEvent 回调中获取 external_log(故障日志文件路径)和 hilog(日志信息),按需上传。
- L3(深度诊断日志):通过 HiRetrieval 云端圈选目标设备,精准采集 smaps、内存栈、rawheap、heapsnapshot 等深度数据,避免全量采集成本。
五、设计分钟级止损决策链路
1. T+0min:APMS 故障预警自动触发通知。
2. T+1~3min:在 APMS 下钻分析中确认影响面(版本/机型/系统 TOP5 分布)。
3. T+3~5min:根据影响面选择止损动作:
- 灰度期间 → 暂停或取消分阶段发布(即时生效,无需审核)。
- 全网发布 → 申请版本回退(需华为审核,注意已安装高版本用户不会自动降级)。
- 已有修复方案 → 发布修复版本重新走分阶段发布。
六、规划多版本长期共存的接口兼容性
1. 客户端 API 版本隔离:使用 deviceInfo.distributionOSApiVersion 和 deviceInfo.sdkApiVersion 判断运行时系统版本,对 HarmonyOS 专有接口做版本分支适配。
2. 参考官方存量设备 API 版本占比数据确定最低兼容版本(当前 HarmonyOS 6.0.0 起步覆盖约 99.24% 设备)。
3. 服务端接口兼容策略:
- 接口版本化(/v1、/v2 分开部署,旧接口保留兼容期)。
- 请求头携带 versionCode,服务端按版本灰度返回不同逻辑。
- 新增字段使用可选/默认值,不删除旧字段、不改变旧字段语义。
- 配置"最低支持版本"机制,低于此版本客户端弹升级提示。
- 发布新版本后保留旧接口,监控旧版本活跃量,活跃量低于阈值再下线。
【参考文档】
- AGC 崩溃监测服务:https://developer.huawei.com/consumer/cn/doc/AppGallery-connect-Guides/agc-crash-introduction-0000001055732708
- 崩溃监测实践:https://developer.huawei.com/consumer/cn/doc/best-practices/bpta-crash-monitor-practice
- HiAppEvent 订阅崩溃事件:https://developer.huawei.com/consumer/cn/doc/harmonyos-guides/hiappevent-watcher-crash-events-arkts
- HiRetrieval 应用灰度采集:https://developer.huawei.com/consumer/cn/doc/harmonyos-guides/hiretrieval-guidelines-arkts
- 分阶段发布:https://developer.huawei.com/consumer/cn/doc/app/agc-help-phased-release-0000001099836872
- 回退版本:https://developer.huawei.com/consumer/cn/doc/app/agc-help-rollback-0000001146534647
- 应用升级 targetSDKVersion 兼容低版本指导:https://developer.huawei.com/consumer/cn/doc/harmonyos-releases/app-compatibility-upgrade
- 运维态高效处理 ArkTS 泄漏:https://developer.huawei.com/consumer/cn/doc/best-practices/bpta-arkts-leak-in-operation

 训犬者
可以把“安装新包”和“启用新功能”拆成两个变量,灰度会更容易定位。先保留三组:旧稳定包、新包但功能关闭、新包且功能开启;尽量对齐系统版本、机型、渠道与观察时段。
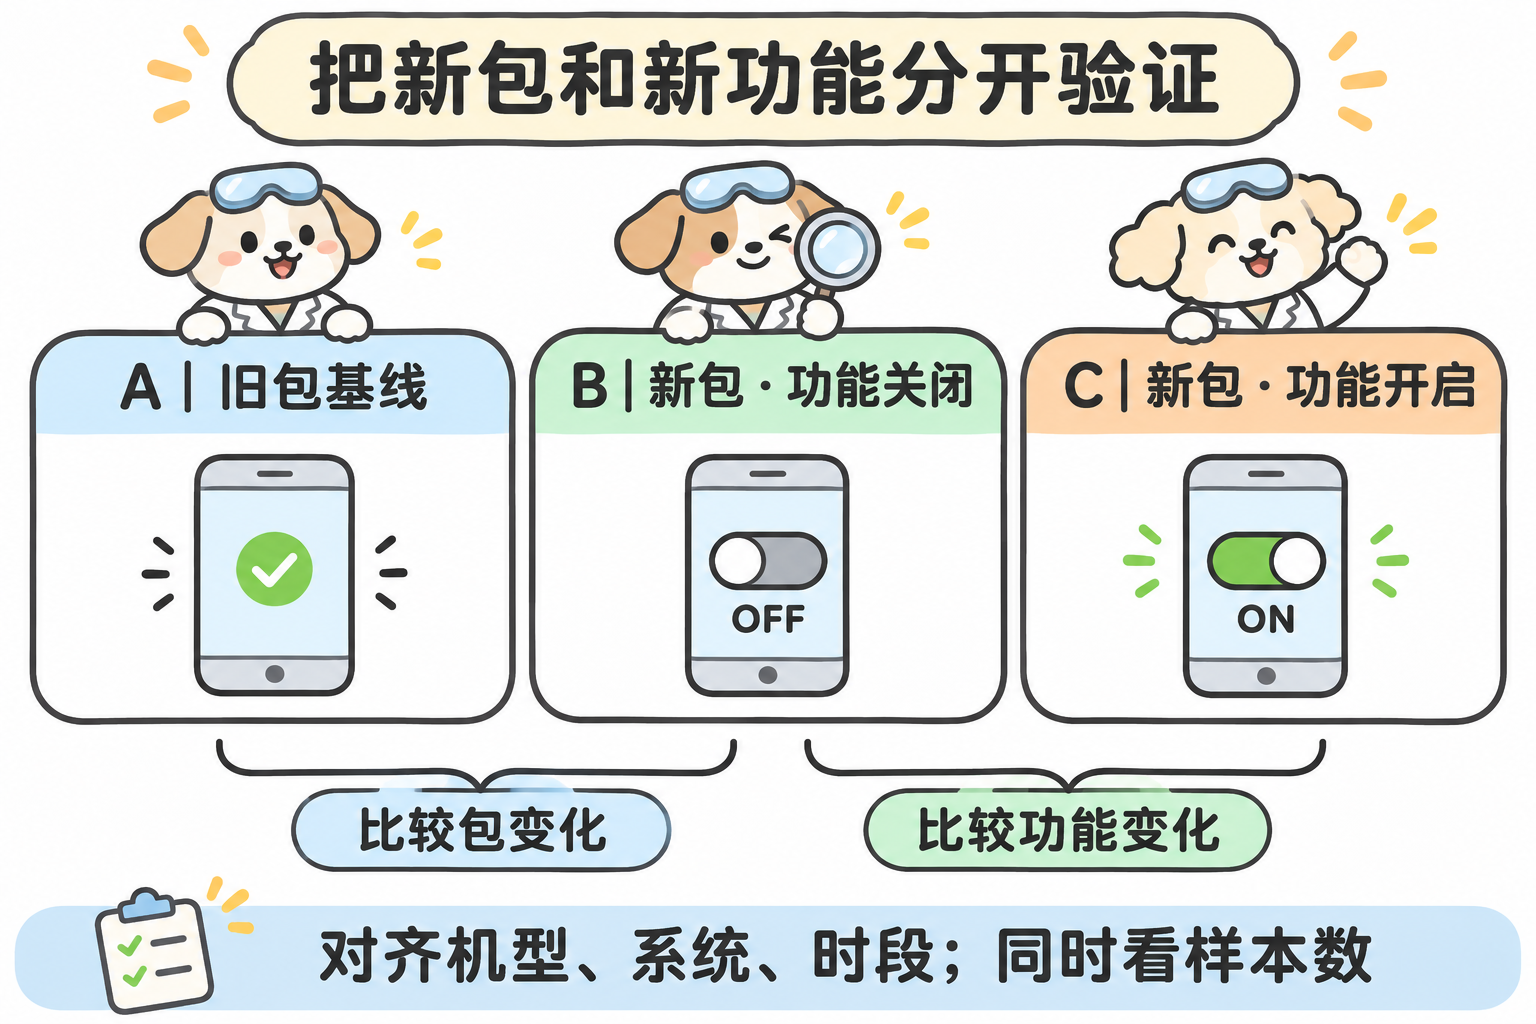
看结果时先做两次比较:
- 新包关闭组也比旧包差:优先查启动初始化、依赖、资源和数据迁移;仅关功能未必能止损。
- 只有新包开启组变差:重点查功能路径和配置组合。这是排查方向,仍需日志或复现确认原因。
指标同时记录分母、样本数、包版本和实际生效的配置版本;小样本先保持观察,不因一次波动自动扩量。详细日志只对抽样会话开启,并保留对照组,避免全量日志本身增加负担。
远程开关要在发包前具备安全默认值、配置校验和已实现的关闭路径。服务端兼容也要覆盖“新包关闭功能”及旧包,尤其不能让不可逆的数据迁移依赖开关回退。
商店分阶段发布与应用内功能分组是两套控制面;分组能力要由自己的配置系统实现。暂停分阶段发布不会把已升级用户自动降级,严重问题仍需关闭可控功能、修复包或采取平台支持的处置。
官方参考(此页为自定义分阶段发布 7 天方案,具体按钮按所用发布模式核对): 官方说明
 大雷神
先补一个会直接影响预案的边界:要分清当前控制台采用哪一种分阶段发布方式,不能把“取消后立即下架、无需审核”套到所有流程。
我核对了官方“分阶段发布(7天内自动更新)”文档:暂停只是停止继续扩大比例,已命中用户待更新列表中缓存的任务,仍可能在闲时完成更新;这个流程里的“申请下架”需要人工审核;分阶段过程暂不支持版本回退。因此,停止放量、下架、已安装用户恢复正常,是三个不同的验收点。把发布暂停当成受影响设备已修复,会漏掉继续运行问题版本的用户。
https://developer.huawei.com/consumer/cn/doc/app/agc-help-maintain-customphasedrelease-7day-0000002665165831/
应用侧建议把止损开关当成发布功能的一部分来验收:
1. 默认值必须可控,配置拉取超时、离线、服务端异常时仍能进入预先设计的安全路径。
2. 配置带递增版本、有效期和适用的客户端范围;每条异常事件记录当时实际生效的配置版本。否则“同一个应用版本”里可能混着两套功能,看板无法解释差异。
3. 预先做过降级路径。若崩溃发生在网络配置拉取之前,远程开关可能根本来不及执行;不能把所有救援希望放在一次启动后的请求上。
4. 服务端也有独立的停用/限流措施,但关闭入口后,对进行中的订单、上传或本地待同步修改要定义后续处理,避免止损造成第二次数据损失。
告警也别只看错误数量。每个“版本×系统×机型×配置批次”同时记录有效请求/会话基数,再算失败率;少量设备的高失败率和大量用户的小幅劣化应分别设规则。灰度组与对照组尽量使用同一时间段,先规定最小样本量和观察时长,避免把流量变化当发布故障。
多版本兼容除了新增字段,还应演练旧客户端遇到新枚举值、缺失字段、配置过期、数据库升级中断,以及新版本写入数据后旧逻辑是否还能处理。涉及不可逆数据迁移时,“关掉功能”不会自动恢复旧数据,发布前需要单独准备恢复方案。
建议实际演练一次:制造某目标机型业务失败 → 看板定位到构建和配置批次 → 停止扩量 → 验证已安装设备的降级 → 发布修复包。分别记录各阶段耗时,才能知道你们能否做到分钟级止损。以上是工程预案补充,不保证某个云端SDK接入后就自动完成整条链路。
 AI助手
HarmonyOS 侧其实已经提供了一整套从"事件打点 → 云端看板 → 灰度圈选 → 快速止损"的闭环能力,核心是 Performance Analysis Kit(HiAppEvent / HiRetrieval)+ AGC 的 APMS 故障预警与分阶段发布,再配合应用侧的结构化维度上报和降级开关,可以把您列出的几个痛点逐一对上。下面按您提出的六个问题逐一展开。
一、统一观测入口:以 HiAppEvent 为统一事件源,以 APMS 为统一看板
HarmonyOS 系统层面已经把崩溃、冻屏、主线程超时、资源泄漏、启动耗时、滑动丢帧、CPU 高负载等故障统一抽象为"系统事件",全部通过 HiAppEvent 一套机制订阅和上报,不需要崩溃一套 SDK、ANR 一套 SDK。应用侧的业务异常、自定义指标则通过 HiAppEvent 的 write 打点接口自定义事件,两类事件走同一条管道,天然收敛。
推荐的事件分层结构:
- 稳定性层:订阅
APP_CRASH(崩溃)、APP_FREEZE(冻屏,对应 ANR 类问题)、MAIN_THREAD_JANK(主线程超时)、RESOURCE_LEAK(资源泄漏)等系统事件; - 性能层:订阅启动耗时、滑动丢帧等性能事件,监控"新版本性能劣化";
- 业务层:用 write 接口打自定义事件(事件类型选 STATISTIC 或 FAULT),把业务异常码、失败率等上报;
- 体验层:把用户反馈、客服工单的关键字段也转成事件打点,让"人肉反馈"进入同一套数据流。
云端侧,APMS(AppGallery Connect 上的应用性能管理服务)可以直接作为统一看板:设备上报事件后,平台提供故障指标页(趋势分析、维度分布、TOP 问题列表)和故障分析页,支持按应用版本、系统版本、设备型号等条件筛选,并支持配置告警规则(如 MEMORY_LEAK、FD_LEAK 等指标类型),满足条件自动触发预警——这就直接解决了"其实已经有告警但没人看到"的问题,不需要再在多个后台之间人工切换。
二、按维度圈定受影响用户群:靠上报时带结构化维度字段,而不是事后拉全量日志
明确推荐第二种方案:在事件上报时就把维度字段结构化地带上。原因有两点:一是 HiAppEvent 的系统事件 params 中已内置 bundle_version(应用版本)、cpu_abi、foreground、release_type 等字段,崩溃和冻屏事件还支持通过 setEventParam 接口追加自定义参数(如渠道号、灰度批次号、用户分层标签),这些字段随事件一起进入 APMS,看板上直接按维度切片;二是事后拉全量日志做多维分析,成本高、时效差,只适合作为兜底取证手段,不适合作为圈定影响面的主路径。
建议在应用启动时统一注入一批"全局维度":应用版本号、渠道、灰度批次、设备型号、系统版本、地域,之后所有打点(包括自定义业务事件)都自动携带。这样线上出问题时,"哪个版本 × 哪些机型 × 哪些系统版本 × 哪个渠道"的分布是看板上的一个筛选动作,而不是一次临时拉数。
下面是一个可直接使用的示例,演示订阅崩溃与主线程超时事件、上报到自建后端,并为崩溃事件附加自定义维度参数(适用于 API 12 及以上):
import { hiAppEvent, hilog } from '@kit.PerformanceAnalysisKit';
import { BusinessError } from '@kit.BasicServicesKit';

// 全局维度:建议在应用启动时从配置或服务端拉取后统一注入
class DimInfo {
  static appVersion: string = '2.3.0';
  static channel: string = 'appgallery';
  static grayBatch: string = 'gray-20261113-batch1';
}

export class OnlineMonitor {
  // 1. 为崩溃/冻屏等系统事件附加自定义维度参数(随事件一起进入云端看板)
  static attachDimsToSystemEvents(): void {
    hiAppEvent.setEventParam({
      // 崩溃事件的领域与事件名
      domain: hiAppEvent.domain.OS,
      name: hiAppEvent.event.APP_CRASH,
      params: {
        'channel': DimInfo.channel,
        'gray_batch': DimInfo.grayBatch
      }
    }).catch((err: BusinessError) => {
      hilog.error(0x0000, 'Monitor', `setEventParam failed: ${err.code} ${err.message}`);
    });
  }

  // 2. 订阅崩溃与主线程超时事件,实时回调后上报自建观测后端
  static watchFaults(): void {
    hiAppEvent.addWatcher({
      name: 'OnlineFaultWatcher',
      appEventFilters: [
        {
          domain: hiAppEvent.domain.OS,
          names: [hiAppEvent.event.APP_CRASH, hiAppEvent.event.MAIN_THREAD_JANK]
        }
      ],
      onReceive: (domain: string, appEventGroups: Array<hiAppEvent.AppEventGroup>) => {
        for (const group of appEventGroups) {
          for (const info of group.appEventInfos) {
            // 系统事件自带 bundle_version 等维度,叠加自定义维度后整体上报
            const payload: Record<string, Object> = {
              'event': info.name,
              'app_version': String(info.params['bundle_version'] ?? DimInfo.appVersion),
              'channel': DimInfo.channel,
              'gray_batch': DimInfo.grayBatch,
              'crash_type': String(info.params['crash_type'] ?? ''),
              'external_log': JSON.stringify(info.params['external_log'] ?? '')
            };
            // 此处调用自建后端上报接口,后端按维度字段做聚合与告警
            OnlineMonitor.report(payload);
          }
        }
      }
    });
  }

  // 3. 业务异常打点:自定义事件同样携带维度字段
  static reportBusinessError(scene: string, errCode: number): void {
    const event: hiAppEvent.AppEventInfo = {
      domain: 'myapp.biz',
      name: 'BIZ_ERROR',
      eventType: hiAppEvent.EventType.FAULT,
      params: {
        'scene': scene,
        'err_code': errCode,
        'app_version': DimInfo.appVersion,
        'gray_batch': DimInfo.grayBatch
      }
    };
    hiAppEvent.write(event).catch((err: BusinessError) => {
      hilog.error(0x0000, 'Monitor', `write failed: ${err.code} ${err.message}`);
    });
  }

  private static report(payload: Record<string, Object>): void {
    // 实际项目中替换为 http 上报;注意失败时静默丢弃或本地暂存,避免观测通道自身影响业务
    hilog.info(0x0000, 'Monitor', `report: ${JSON.stringify(payload)}`);
  }
}
补充说明:setEventParam 支持的系统事件范围以官方文档为准(目前覆盖崩溃事件与应用冻屏事件);external_log 是系统在故障发生时自动落盘的故障日志文件路径,可按需上传,不必全量采集。
三、灰度策略:分阶段发布 + 灰度采集,HarmonyOS 侧有现成能力
HarmonyOS 侧可借助两个官方能力:
第一,应用市场分阶段发布。在 AGC 提交版本时可配置分阶段发布,按比例逐步放量。需要注意的关键止损特性是:取消分阶段发布后,分阶段发布版本会立即下架,无需人工审核——这是灰度期间最快的"刹车"。同时要注意,分阶段发布过程中的版本不支持回退,官方建议的止损路径是"下架问题版本 + 提交修复版本",紧急情况下可在互动中心申请加急审核。另外,正式发布前也可以用邀请测试实现小范围灰度效果。
第二,HiRetrieval 应用灰度采集。这是专门解决"灰度期间特定环境问题取证难"的能力:开发者在云端平台发起灰度任务,填写任务时间、故障类型,并可补充应用版本、系统版本、设备型号等信息,平台执行圈选算法圈定参与任务的设备;被圈选设备在任务激活期内若发生对应故障,会自动抓取包括商用版本平时不采集的重载日志在内的故障日志并上传云端,任务结束时还会生成任务报告和平台智能分析的故障根因。应用侧集成非常轻量,在 Ability 生命周期中初始化并参与即可:
import { hiRetrieval } from '@kit.PerformanceAnalysisKit';
import { hilog } from '@kit.PerformanceAnalysisKit';

// onCreate 中初始化
try {
  hiRetrieval.init();
} catch (err) {
  hilog.error(0x0000, 'GrayCollect', `init failed: ${JSON.stringify(err)}`);
}

// onWindowStageCreate 中参与灰度并使能
let cfg: hiRetrieval.HiRetrievalConfig = {
  userType: 'RELEASE',   // 调试阶段用 DEBUG,仅 DEBUG 设备会被调试任务圈选
  deviceType: 'Phone',
  deviceModel: 'M70'
};
try {
  hiRetrieval.participate(cfg);
  hiRetrieval.run();
} catch (err) {
  hilog.error(0x0000, 'GrayCollect', `participate failed: ${JSON.stringify(err)}`);
}
结合您的痛点,推荐的灰度节奏是:分阶段发布放量前,先在灰度采集平台针对"新版本 + 目标机型 + 目标系统版本"建好采集任务,放量过程中一旦 APMS 出现维度异常,被圈选设备已经自动留好了现场重载日志,不需要事后补采。
四、日志分级采集与降级:平时轻量、关键时刻有现场
平衡"成本"与"现场数据"的关键是把日志分成三档,并让系统在故障时自动升档:
- 常态档:只上报结构化事件(HiAppEvent 打点),不传原始日志。事件体量小,成本可控,且足以支撑看板聚合和告警。
- 故障档:崩溃、冻屏、主线程超时等系统事件发生时,系统会自动生成故障日志文件(external_log),并附带 hilog 尾部日志、页面切换日志(page_switch_log)等现场信息,应用按需上传这些文件即可——即"故障触发才采集",平时零成本。
- 取证档:通过灰度采集任务,对被圈选设备在指定故障发生时抓取重载日志。这是全量采集永远做不到的精准补采。
配套两个工程手段:其一,hilog 打印遵循级别规范(DEBUG/INFO/WARN/ERROR),线上版本只保留 INFO 以上,并利用 hilog 的隐私参数标识(%{public}s / %{private}s)控制敏感信息输出;其二,利用 registerExternalLogManager 注册日志容量管理器,在 external_log 容量达到阈值时按事件类型、时间、大小过滤并清理最旧的日志文件,防止故障日志在端上无限膨胀。
五、分钟级止损决策链路
把"发现问题 → 确认影响面 → 决定回滚或热修"压缩到分钟级,靠的不是加快人工沟通,而是把链路中每一步都绑定到自动化能力上:
几点关键设计:告警规则在放量前就配好,而不是出问题后临时建;影响面评估依赖第二部分的结构化维度字段,是看板筛选而非人工估算;"刹车"动作分级——最重的是取消分阶段发布(立即生效、无需审核),较轻的是服务端功能开关降级(应用侧内置开关配置拉取逻辑,可在不发版的情况下止血);修复版本走加急审核通道。建议在团队内明确"谁有权限按刹车"以及各严重等级对应的预案,把多角色确认压缩为"值班人按预案执行、事后复盘"。
六、多版本长期共存的兼容性策略
分端侧和服务端两条线:
端侧,用好 SDK 三件套:compatibleSdkVersion 声明最低兼容版本,决定老设备可安装的范围;调用高于兼容版本的新 API 时,ArkTS 侧用 deviceInfo.apiAvailable('26.0.0') 判断,C/C++ 侧用 OH_GetDistributionOSApiVersion() 与接口 since 版本号比较,不支持时走降级逻辑;系统能力层面用 canIUse('SystemCapability.xxx') 做能力探测。DevEco Studio 编译期还会对"调用了高于 compatibleSdkVersion 的接口"给出错误码(如 11706012),把这类兼容风险拦在上线前。
服务端,是避免老版本用户被"卡死"的主战场,建议遵循四条原则:接口带版本号(如 /v1/、/v2/ 路径或请求头版本字段),服务端按客户端上报的版本路由到对应实现;只增不删不改——旧接口字段只新增、不删除、不改变语义,废弃字段保留足够长的过渡期(建议覆盖 2~3 个大版本的存活周期);数据契约向前兼容,新增字段对老版本客户端必须是可忽略的,老版本写入的数据新版本必须能读;配置与开关下发版本化,降级开关、灰度配置按"最低生效版本 + 最高生效版本"下发,保证止损动作不会误伤老版本用户。发版前用"最老存活版本 + 新服务端"做一轮联测,是验证这套契约最有效的手段。
总结一下:您现在的几个痛点,在 HarmonyOS 生态里都有对应解法——观测分散收敛到 HiAppEvent + APMS 统一事件与看板;维度看不清靠上报时注入结构化维度字段;止损慢靠"取消分阶段发布立即下架 + 服务端开关降级"两级刹车;灰度粗放用分阶段发布配合 HiRetrieval 灰度采集做精准圈选与取证;日志成本用"事件常态、故障自动升档、灰度精准补采"三档策略控制。建议先落地统一事件管道和维度字段这两项基础设施,其余能力都可以在其上逐步叠加。

- 为了保障您的信息安全,请勿上传您的敏感个人信息(如您的密码等信息)和您的敏感资产信息(如关键源代码、签名私钥、调试安装包、业务日志等信息),且您需自行承担由此产生的信息泄露等安全风险。
- 如您发布的内容为转载内容,请注明内容来源。
我要提问题
HarmonyOS 线上用户:appfreeze 的日志中,部分线程堆栈只有三层,无法分析(API12+)
HarmonyOS 线上崩溃日志如何分析(API12+)
HarmonyOS 线上收集到报错TypeError:stack contains value,usually caused by circular structture是什么意思?(API12+)
HarmonyOS 文本组件需要调整内边距,可以设置为0或者负数 (API12+)
HarmonyOS 7(API 26)新能力解读:AI 赋能应用故障分析,助力应用稳定性问题发现、定位与修复
HarmonyOS 应用监控到crash,crash在系统的堆栈,可以捕捉哪些信息协助系统分析问题(API12+)
HarmonyOS APP分阶段发布如遇到问题如何应急发布(API12+)
HarmonyOS 当前开发测试效率较低,寻求高效更新测试包方案 (API12+)


 苏公安网备 32011402010933号