














 waylau
Spark系列037——Spark GraphX图计算示例
本节演示Spark GraphX图计算的使用示例。有多种构建图的方式,本例演示的是使用从边构建图的过程。假设我们的图是如下图所示。
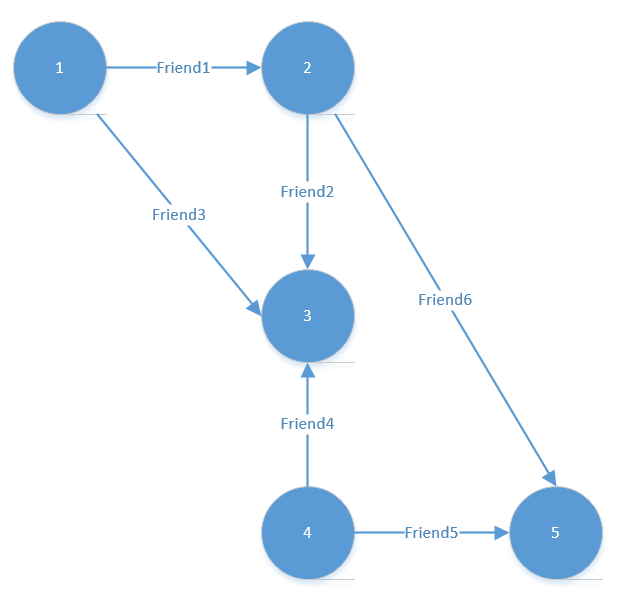
GraphX是基于RDD API的,因此,不需要额外的依赖。
初始化JavaSparkContext
与使用基本的RDD API的一样,需要先初始化JavaSparkContext:
// 要构建一个包含有Spark关应用程序信息的SparkConf对象
SparkConf conf = new SparkConf()
.setAppName("JavaRddGraphX")// 设置应用名称
.setMaster("local[4]"); // 本地4核运行
// 创建一个JavaSparkContext对象,它告诉Spark如何访问群集
JavaSparkContext sparkContext = new JavaSparkContext(conf);
初始化Edge
本例演示的是使用从边构建图的过程,因此先初始化Edge:
// 初始化Edge,属性是String类型
List<Edge<String>> edges = new ArrayList<>();
edges.add(new Edge<String>(1, 2, "Friend1"));
edges.add(new Edge<String>(2, 3, "Friend2"));
edges.add(new Edge<String>(1, 3, "Friend3"));
edges.add(new Edge<String>(4, 3, "Friend4"));
edges.add(new Edge<String>(4, 5, "Friend5"));
edges.add(new Edge<String>(2, 5, "Friend6"));
JavaRDD<Edge<String>> edgeRDD = sparkContext.parallelize(edges);
初始化Graph
通过Graph.fromEdges方法,从边构建图:
ClassTag<String> stringTag = scala.reflect.ClassTag$.MODULE$.apply(String.class);
// 从Edge初始化Graph
Graph<String, String> graph = Graph.fromEdges(edgeRDD.rdd(),
"v", // 默认Vertex属性值
StorageLevel.MEMORY_ONLY(), // 存储级别为内存
StorageLevel.MEMORY_ONLY(), // 存储级别为内存
stringTag, // 属性是String类型
stringTag); // 属性是String类型
从边集合构建图参数说明如下:
- edges-包含图形中的一组边的RDD
- defaultValue -用于每个顶点的默认顶点属性
- edgeStorageLevel -必要时缓存边的所需存储级别
- vertexStorageLevel -必要时缓存顶点的所需存储级别
- evidence$16-属性类型
- evidence$17-属性类型
输出Graph的内容
假设我们想输出Vertex,代码如下:
// 打印Vertex
graph.vertices().toJavaRDD().collect().forEach(System.out::println);
最终输出效果如下:

源码
上述示例源码,可以在https://github.com/waylau/apache-spark-tutorial
仓库JavaRddGraphXSample示例中找到。
/*
* Copyright (c) waylau.com, 2021. All rights reserved.
*/
package com.waylau.spark.java.samples.rdd;
import java.util.ArrayList;
import java.util.List;
import org.apache.spark.SparkConf;
import org.apache.spark.api.java.JavaRDD;
import org.apache.spark.api.java.JavaSparkContext;
import org.apache.spark.graphx.Edge;
import org.apache.spark.graphx.Graph;
import org.apache.spark.storage.StorageLevel;
import scala.reflect.ClassTag;
/**
* Java RDD GraphX sample.
*
* @author <a href="https://waylau.com">Way Lau</a>
* @since 2021-08-25
*/
public class JavaRddGraphXSample {
public static void main(String[] args) {
// 要构建一个包含有Spark关应用程序信息的SparkConf对象
SparkConf conf = new SparkConf()
.setAppName("JavaRddGraphX")// 设置应用名称
.setMaster("local[4]"); // 本地4核运行
// 创建一个JavaSparkContext对象,它告诉Spark如何访问群集
JavaSparkContext sparkContext = new JavaSparkContext(conf);
// 初始化Edge,属性是String类型
List<Edge<String>> edges = new ArrayList<>();
edges.add(new Edge<String>(1, 2, "Friend1"));
edges.add(new Edge<String>(2, 3, "Friend2"));
edges.add(new Edge<String>(1, 3, "Friend3"));
edges.add(new Edge<String>(4, 3, "Friend4"));
edges.add(new Edge<String>(4, 5, "Friend5"));
edges.add(new Edge<String>(2, 5, "Friend6"));
JavaRDD<Edge<String>> edgeRDD = sparkContext.parallelize(edges);
ClassTag<String> stringTag = scala.reflect.ClassTag$.MODULE$.apply(String.class);
// 从Edge初始化Graph
Graph<String, String> graph = Graph.fromEdges(edgeRDD.rdd(),
"v", // 默认Vertex属性值
StorageLevel.MEMORY_ONLY(), // 存储级别为内存
StorageLevel.MEMORY_ONLY(), // 存储级别为内存
stringTag, // 属性是String类型
stringTag); // 属性是String类型
// 打印Vertex
graph.vertices().toJavaRDD().collect().forEach(System.out::println);
// 关闭JavaSparkContext
sparkContext.close();
}
}
参考
本系列归档至《跟老卫学Apache Spark开发》 https://github.com/waylau/apache-spark-tutorial


- 为了保障您的信息安全,请勿上传您的敏感个人信息(如您的密码等信息)和您的敏感资产信息(如关键源代码、签名私钥、调试安装包、业务日志等信息),且您需自行承担由此产生的信息泄露等安全风险。
- 如您发布的内容为转载内容,请注明内容来源。
我要发帖子


 苏公安网备 32011402010933号