














 waylau
Spark系列007——启动Spark应用的方式
本节介绍如何来启动Spark应用。可以选择从最简单的通过Spark的交互式shell来体验Spark,也可以启动通过Java、Scala和Python语言来编写Spark应用程序启动器。
本节会介绍所有的启动Spark应用的方式。
使用Spark Shell与Spark进行交互
在Spark初始安装之后,体验Spark最为快捷的方式就是使用Spark Shell。Spark Shell提供了学习API的简单方法,以及交互式分析数据的强大工具。它可以在Scala(运行在Java虚拟机上,因此是使用现有Java库的好方法)或Python中使用。在Spark目录下运行以下命令启动它:
./bin/spark-shell
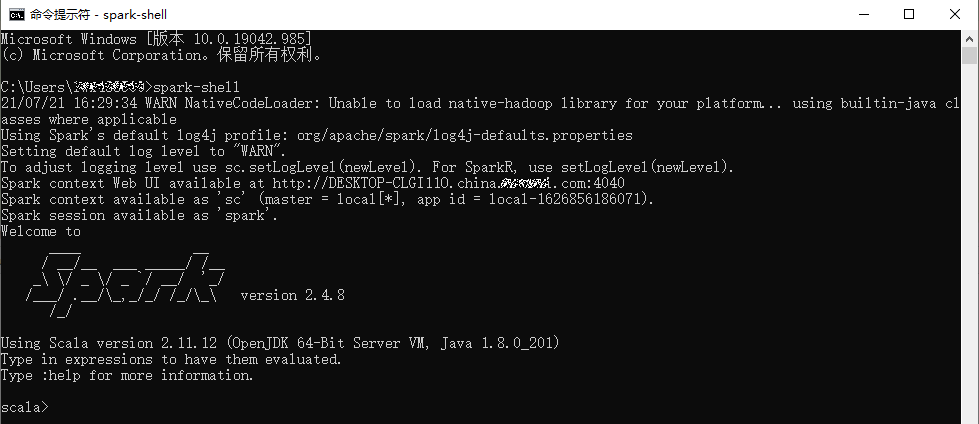
可以在Spark Shell里面定义变量:
scala> var hi = "hello"
上述定义了一个名为hi的字符串变量,值为“hello”。这里并不需要显示申明变量的数据类型,因为,Scala会自定从值推导出这是个String类型,并在控制台输出:
scala> var hi = "hello"
hi: String = hello
后续可以使用该变量,比如讲该变量在控制台打印出来:
scala> print(hi)
hello
使用spark-submit运行应用程序
如果是使用Java、Scala或者Python语言编写Spark自包含应用程序( self-contained application),则可以通过spark-submit运行应用程序。
自包含应用程序
何为自包含应用程序?自包含应用程序由单个可安装包组成,其中包含应用程序和运行应用程序所需的依赖,类似于现在所说的Fat JAR。
借助现代工具,可以轻松构建自包含应用程序,比如在Scala使用sbt,在 Java中使用Maven,在Python中使用pip。
使用Maven构建自包含应用程序
以Maven为例,在项目的pom.xml文件,描述如下:
<project xmlns="http://maven.apache.org/POM/4.0.0"
xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd">
<modelVersion>4.0.0</modelVersion>
<groupId>com.waylau.spark</groupId>
<artifactId>spark-java-samples</artifactId>
<version>1.0.0</version>
<name>spark-java-samples</name>
<packaging>jar</packaging>
<organization>
<name>waylau.com</name>
<url>https://waylau.com</url>
</organization>
<properties>
<scala.version>2.12</scala.version>
<spark.version>3.1.2</spark.version>
</properties>
<dependencies>
<dependency> <!-- Spark dependency -->
<groupId>org.apache.spark</groupId>
<artifactId>spark-sql_${scala.version}</artifactId>
<version>${spark.version}</version>
<scope>provided</scope>
</dependency>
</dependencies>
</project>
pom.xml文件里面引入了Spark的依赖。需要注意的是<scope>设置为了provided, 是因为,本地计算机中已经安装了Spark,因此,可以不用将Spark的依赖打包到最终的安装包里面,从而减少安装包的体积。
执行Maven的package命令来进行打包:
mvn clean package
[INFO] Scanning for projects...
[INFO]
[INFO] ------------------------------------------------------------------------
[INFO] Building spark-java-samples 1.0.0
[INFO] ------------------------------------------------------------------------
[INFO]
[INFO] --- maven-clean-plugin:2.5:clean (default-clean) @ spark-java-samples ---
[INFO] Deleting D:\git-devcloud\spark-java-demos\target
[INFO]
[INFO] --- maven-resources-plugin:2.6:resources (default-resources) @ spark-java-samples ---
[INFO] Using 'UTF-8' encoding to copy filtered resources.
[INFO] Copying 0 resource
[INFO]
[INFO] --- maven-compiler-plugin:3.1:compile (default-compile) @ spark-java-samples ---
[INFO] Changes detected - recompiling the module!
[INFO] Compiling 5 source files to D:\git-devcloud\spark-java-demos\target\classes
[INFO]
[INFO] --- maven-resources-plugin:2.6:testResources (default-testResources) @ spark-java-samples ---
[INFO] Using 'UTF-8' encoding to copy filtered resources.
[INFO] skip non existing resourceDirectory D:\git-devcloud\spark-java-demos\src\test\resources
[INFO]
[INFO] --- maven-compiler-plugin:3.1:testCompile (default-testCompile) @ spark-java-samples ---
[INFO] Nothing to compile - all classes are up to date
[INFO]
[INFO] --- maven-surefire-plugin:2.12.4:test (default-test) @ spark-java-samples ---
[INFO] No tests to run.
[INFO]
[INFO] --- maven-jar-plugin:2.4:jar (default-jar) @ spark-java-samples ---
[INFO] Building jar: D:\git-devcloud\spark-java-demos\target\spark-java-samples-1.0.0.jar
[INFO] ------------------------------------------------------------------------
[INFO] BUILD SUCCESS
[INFO] ------------------------------------------------------------------------
[INFO] Total time: 2.177 s
[INFO] Finished at: 2021-07-21T20:19:17+08:00
[INFO] Final Memory: 36M/442M
[INFO] ------------------------------------------------------------------------
可以看到应用程序被打成了spark-java-samples-1.0.0.jar安装包。
spark-submit运行应用程序
打好安装包之后如何来运行?假设应用程序的入口函数如下:
package com.waylau.spark.java.samples.sql;
import com.waylau.spark.java.samples.common.Person;
import org.apache.spark.sql.SparkSession;
import org.apache.spark.sql.Dataset;
import org.apache.spark.sql.Encoder;
import org.apache.spark.sql.Encoders;
import org.apache.spark.sql.SaveMode;
import java.util.List;
import java.util.ArrayList;
public class WriteCVSExample {
public static void main(String[] args) {
SparkSession sparkSession = SparkSession.builder()
.appName("WriteCVS") // 设置应用名称
.master("local") // 本地单线程运行
.getOrCreate();
// 创建Java Bean
Person person01 = new Person();
person01.setName("Way Lau");
person01.setAge(35);
person01.setHomePage("https://waylau.com");
Person person02 = new Person();
person02.setName("Andy Huang");
person02.setAge(25);
person02.setHomePage("https://waylau.com/books");
List<Person> personList = new ArrayList<>();
personList.add(person01);
personList.add(person02);
// 创建Java Bean的编码器
Encoder<Person> personEncoder = Encoders.bean(Person.class);
// 转为Dataset
Dataset<Person> javaBeanListDS =
sparkSession.createDataset(personList, personEncoder);
// 导出为CSV文件
javaBeanListDS.write().format("csv") // 文件格式
.mode(SaveMode.Overwrite) // 如果第一次生成了,后续会覆盖
.option("header", "true")
.save("target/outfile/people"); // 保存的文件所在的目录路径
// 上述导出方式等同于下面的快捷方式:
// 导出为CSV文件
javaBeanListDS.write()
.mode(SaveMode.Overwrite) // 如果第一次生成了,后续会覆盖
.option("header", "true")
.csv("target/outfile/people"); // 保存的文件所在的目录路径
// 关闭SparkSession
sparkSession.stop();
}
}
则,执行以下方法即可运行上述程序:
spark-submit --class "com.waylau.spark.java.samples.sql.WriteCVSExample" target/spark-java-samples-1.0.0.jar
其中,--class参数用于指明入口函数所在类名。
如果是Python或者是R语言编写的程序,则无需打包,直接可以用spark-submit运行,示例如下:
# Pytho示例
/spark-submit examples/src/main/python/pi.py
# R示例
/spark-submit examples/src/main/r/dataframe.R
以编程方式启动Spark应用程序
Spark提供了启动器实现的基类AbstractLauncher,用于以编程方式启动Spark应用程序。启动器可以实现让Spark从另一个应用程序来启动Spark应用程序,比如Web应用程序,这样就方便实现Spark自动化运行。
AbstractLauncher提供了两个子类:
- SparkLauncher将应用程序作为子进程使用
- InProcessLauncher将应用程序在进程内启动
SparkLauncher
该类SparkLauncher使用生成器模式允许客户端配置Spark应用程序并将其作为子进程启动。示例如下:
package com.waylau.spark.java.samples.launcher;
import java.io.IOException;
import java.util.concurrent.CountDownLatch;
import org.apache.spark.launcher.SparkAppHandle;
import org.apache.spark.launcher.SparkLauncher;
/**
* SparkLauncher Sample
*
* @author <a href="https://waylau.com">Way Lau</a>
* @since 2021-07-22
*/
public class SparkLauncherSample {
public static void main(String[] args) throws IOException, InterruptedException {
SparkAppHandle handle = new SparkLauncher()
.setAppResource("target/spark-java-samples-1.0.0.jar") // 应用程序
.setMainClass("com.waylau.spark.java.samples.sql.WriteCVSExample")// 启动函数入口
.setMaster("local") // 集群配置
.setConf(SparkLauncher.DRIVER_MEMORY, "2g") // 配置
.startApplication();
CountDownLatch countDownLatch = new CountDownLatch(1);
// 启动程序是异步的,所以要事件监听任务是否执行完成了
handle.addListener(new SparkAppHandle.Listener() {
@Override
public void stateChanged(SparkAppHandle sparkAppHandle) {
if (sparkAppHandle.getState().isFinal()) {
// 启动程序完成允许结束
countDownLatch.countDown();
}
System.out.println("state:" + sparkAppHandle.getState().toString());
}
@Override
public void infoChanged(SparkAppHandle sparkAppHandle) {
System.out.println("Info:" + sparkAppHandle.getState().toString());
}
});
// 线程等待启动程序完成
countDownLatch.await();
System.out.println("Done!");
}
}
InProcessLauncher
使用此类InProcessLauncher启动的应用程序将在与调用者相同的进程中运行。
由于Spark仅支持每个JVM的SparkContext的单个活动实例,因此使用此类的代码应小心启动了哪些应用程序。建议此启动程序仅用于在集群模式下启动应用程序。
因为Spark不能在同一进程中同时运行多个客户端模式应用程序。进程内启动器要求调用者线程的类加载器中存在必要的Spark依赖项(如Spark核心和群集管理器特定的模块)。
另请注意,在客户端模式下运行应用程序时,与JVM相关的配置(如驱动程序内存或修改驱动程序类路径的配置)不会生效。日志记录配置也从父应用程序继承。
InProcessLauncher示例与SparkLauncher,只是不需要通过事件去监听状态。
package com.waylau.spark.java.samples.launcher;
import java.io.IOException;
import org.apache.spark.launcher.SparkLauncher;
import org.apache.spark.launcher.InProcessLauncher;
/**
* InProcessLauncher Sample
*
* @author <a href="https://waylau.com">Way Lau</a>
* @since 2021-07-22
*/
public class InProcessLauncherSample {
public static void main(String[] args) throws IOException {
new InProcessLauncher()
.setAppResource("target/spark-java-samples-1.0.0.jar") // 应用程序
.setMainClass("com.waylau.spark.java.samples.util.LongAccumulatorSample")// 启动函数入口
.setMaster("local") // 集群配置
.setConf(SparkLauncher.DRIVER_MEMORY, "2g") // 配置
.startApplication();
System.out.println("Done!");
}
}
源码
上述示例源码,可以在https://github.com/waylau/apache-spark-tutorial仓库SparkLauncherSample、InProcessLauncherSample示例中找到。
参考
https://docs.oracle.com/javase/8/docs/technotes/guides/deploy/self-contained-packaging.html


- 为了保障您的信息安全,请勿上传您的敏感个人信息(如您的密码等信息)和您的敏感资产信息(如关键源代码、签名私钥、调试安装包、业务日志等信息),且您需自行承担由此产生的信息泄露等安全风险。
- 如您发布的内容为转载内容,请注明内容来源。
我要发帖子


 苏公安网备 32011402010933号