














 waylau
Spark系列016——Spark SQL之Dataset与DataFrame
Spark SQL 是 Spark 用于处理结构化数据的一个模块,提供了其中包括 SQL API和 Dataset/DataFrame API与 Spark SQL 进行交互。
SQL API
Spark SQL 的用法之一是执行 SQL 查询,它也可以从现有的 Hive 中读取数据。 如果从其它编程语言内部运行 SQL API,查询结果将作为一个 Dataset/DataFrame 返回。还可以使用命令行或者通过 JDBC/ODBC 来与SQL API进行交互。示例如下:
Dataset<Row> sqlDF = spark.sql("SELECT * FROM people");
Dataset/DataFrame API
Dataset 是一个分布式数据集,它是 Spark 1.6 版本中新增的一个接口, 它结合了 RDD API和 SQL API的优化执行引擎的好处。Dataset 可以从 JVM 对象构造得到,随后可以使用函数式的转换进行操作,比如map、flatMap、filter 等)。Dataset API 目前支持 Scala 和 Java 语言,还不支持 Python, 不过由于 Python 语言的动态性, Dataset API 的许多好处早就已经可用了。例如,可以使用 row.columnName 来访问数据行的某个字段。这种场景对于 R 语言来说是类似的。
DataFrame 是按命名列方式组织的一个 Dataset。从概念上来讲,它等同于关系型数据库中的一张表或者 R/Python 中的一个 data frame(数据帧), 只不过在底层进行了更多的优化。DataFrame 可以从很多数据源构造得到,比如结构化的数据文件、Hive 表、外部数据库或现有的 RDD。 DataFrame API 支持 Scala、Java、Python 以及 R 语言。在 Scala 和 Java 语言中, DataFrame 是一个Row类型的 Dataset 来表示的。在 Scala API 中, DataFrame 仅仅只是 Dataset[Row] 的一个类型别名,而在 Java API 中, 开发人员需要使用 Dataset<Row> 来表示一个 DataFrame。DataFrame也可以被称为“非类型化”(Untyped)的Dataset,或者是Dataset的子集。以下是一个DataFrame示例:
Dataset<Row> df = spark.read().json("examples/src/main/resources/people.json");
Dataset是特定于域的对象的强类型集合,这点与RDD有本质的区别。比如,以下是一个Person类型的Dataset
Dataset<Person> peopleDS = spark.read().json(path).as(personEncoder);
其次对于操作而言,与RDD类似,Dataset可用的操作也分为转换(Transformation)和动作(Action)。转换是用于生成新的Dataset,而动作是触发计算和返回结果。常见的转换操作包括map、filter、select和groupBy。常见的动作操作包括count、show或将数据写入文件系统。
Dataset也是懒执行(lazy)的,它们不会立即计算结果,直到有转换操作发生。在内部,Dataset表示一个逻辑计划,该计划描述生成数据所需的计算。当调用动作操作时,Spark的查询优化器(query optimizer)会优化逻辑计划(logical plan),并生成物理计划(physical plan),以便以并行和分布式的方式高效执行。要探索逻辑计划和优化的物理计划,请使用解释函数explain。
要有效地支持特定于域的对象,需要编码器。编码器将域特定类型T映射到Spark的内部类型系统。例如,给定一个具有两个字段name (string) 和age (int)的类Person,编码器用于告诉Spark在运行时生成代码,以将Person对象序列化为二进制结构。这种二进制结构通常具有更低的内存占用空间,并针对数据处理的效率进行了优化(例如,列式格式)。要了解数据的内部二进制表示,请使用模式函数schema。
RDD、Dataset、DataFrame优缺点总结
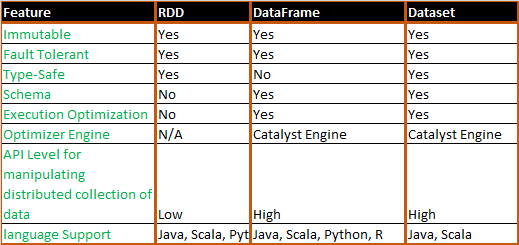
RDD的优点:
1.编译时类型安全,即编译时就能检查出类型错误。
2.面向对象的编程分格,即直接通过类名点的方式来操作数据。
3.功能强大,有很多内置函数,方便处理结构化或非结构化数据,比如group,map,filter等。
RDD的缺点:
1.无论是集群间的通信,还是IO操作都需要对对象的结构和数据进行序列化和反序列化,序列化和反序列化的性能开销大。
2.GC(垃圾回收)的性能开销大,频繁的创建和销毁对象,势必会增加GC。
3.没有内置优化引擎:在处理结构化数据时,RDD无法利用Spark的高级优化器,包括catalyst优化器和Tungsten执行引擎。开发人员需要根据每个RDD的属性进行优化。
4.处理结构化数据较弱:与DataFrame和Dataset不同,RDD不推断摄取数据的模式,而是要求用户指定它。
DataFrame的优点:
1、自带scheme信息,降低序列化和反序列化的开销。
2、将数据序列化为二进制格式的堆外存储,直接在里面执行转换,无需使用Java序列化来编码数据。
3、避免在为Dataset的每一行构造单个对象时引起的垃圾回收。
4、能够使用catalyst优化器和Tungsten执行引擎
5、数据处理强大:处理结构化和非结构化数据格式(Avro、CSV、弹性搜索和Cassandra)和存储系统(HDFS、HIVE表、MySQL等)。它可以从所有这些不同的数据源读取和写入。
6、兼容Hive
DataFrame的缺点:
1、编译时不能类型转化安全检查,运行时才能确定是否有问题
2、DataFrame内存存储的是Row对象而不能是自定义对象,对于对象支持不友好。
Dataset的优点:
1、快:大多数场景下,性能优于RDD;Encoders优于Kryo或者Java序列化,避免不必要的格式转化。
2、类似于RDD,函数尽可能编译时安全,而且支持自定义对象存储。
3、可以和DataFrame,RDD相互转化。
4、和DataFrame一样,支持结构化数据的sql查询。
5、具有RDD和DataFrame的优点,又避免了它们的缺点。支持结构化和非结构化数据。
6、官方建议使用Dataset
RDD、Dataset、DataFrame的相互转换
1、RDD ->Dataset
命令:val ds = rdd.toDS()
2、RDD ->DataFrame
命令:val df = spark.read.json(rdd)
3、Dataset -> RDD
命令:val rdd = ds.rdd
4、Dataset -> DataFrame
命令:val df = ds.toDF()
5、DataFrame -> RDD
命令:val rdd = df.toJSON.rdd
6、DataFrame -> Dataset
命令:val ds = df.toJSON
参考
本系列归档至《跟老卫学Apache Spark开发》 https://github.com/waylau/apache-spark-tutorial


- 为了保障您的信息安全,请勿上传您的敏感个人信息(如您的密码等信息)和您的敏感资产信息(如关键源代码、签名私钥、调试安装包、业务日志等信息),且您需自行承担由此产生的信息泄露等安全风险。
- 如您发布的内容为转载内容,请注明内容来源。
我要发帖子


 苏公安网备 32011402010933号