之前用glm5.3high是有1m上下文的,怎么MAX只有170k
赤辰DevEco Studio
为什么deveco code里的glm5.3MAX上下文只有170k左右
慢行
蓝瘦的蜕变
建议先区分界面显示的是上下文总上限、剩余额度,还是自动压缩阈值,这三个数可能不同。
排查办法:
- 在同一版本、同一供应商配置下,分别新建空会话,选择 high 和 MAX,对比初始额度。
- 如果空会话就分别显示 1M 和约 170K,优先检查两个选项实际对应的模型 ID、服务端额度或客户端配置。
- 如果只有旧会话显示约 170K,则检查已用上下文及压缩提示,不能据此判断模型总上限变小。
小草飞上天开发者你好:
我认为这可能是是 DevEco Code 内置模型服务在特定时期因资源限制,将 GLM-5.1 和 GLM-5.3 的上下文窗口临时限制在了 170K
Mandelx Hemen
不羁的木木这大概率是 DevEco Code 对不同模型档位采用了不同的上下文配置,不能直接理解为 GLM-5.3 MAX 本身只有 170K 上下文。
我查到的模型资料显示,GLM-5.3 本身支持 1M tokens 上下文,最大输出为 128K tokens。
你遇到的情况可能有以下原因:
- 模型路由不同:
GLM-5.3-High和GLM-5.3-MAX可能使用不同的服务配置。High 档位启用了 1M 上下文,而 MAX 档位当前使用约 170K 的上下文限制。 - 工具侧设置了上限:DevEco Code 除了模型本身的限制,还需要为系统提示词、工具定义、代码上下文和历史消息预留空间,因此界面显示的可用上下文可能小于模型理论上限。
- 1M 上下文需要单独启用:部分 GLM 接入渠道需要显式选择长上下文模型配置,不能只切换 High/MAX 档位就默认获得 1M。
目前我没有查到华为官方公开资料明确说明 DevEco Code 中 GLM-5.3-MAX 的上下文限制,因此还不能确定具体是哪一种原因。
建议先做两个检查:
- 在同一个 DevEco Code 版本、同一个工程中,分别切换 High 和 MAX,观察上下文上限是否始终是约 1M 和 170K。
- 查看 DevEco Code 是否提供独立的长上下文选项、模型变体或相关配置。如果只有模型档位可选,则需要华为侧确认 MAX 对应的服务配置是否支持 1M。
关键结论:GLM-5.3 的模型能力支持 1M,不代表 DevEco Code 中每个模型档位都开放了 1M。 如果 High 一直是 1M、MAX 一直只有 170K,更值得排查 DevEco Code 的模型路由和上下文配置,而不是认为 MAX 的推理能力导致上下文变短。
DevEco Code 的官方入口: DevEco Code
橙动创意你看到的 MAX 约 170k、High 约 1m,可以作为当前集成界面的实际表现;但 MAX 这个名称本身不保证窗口更大。我没找到能确认“固定走 200k 端点、预留 30k”这组数字的官方说明,暂时不能据此解释差异。
先核对 DevEco Code 版本、实际 model ID,以及界面显示的是总窗口还是剩余可输入量;后者可能还受会话历史和输出预算影响。用空白会话对照一次,仍有差异就带上述版本和界面数值反馈,API Key 不要放进截图或帖子。
心系天下
AI助手GLM-5.3 模型本身支持 1M(约 1048576 tokens)上下文长度,这是智谱AI官方公布的模型能力上限。但在 DevEco Code 中,MAX 档位与 high 档位观察到的可用上下文差异,主要源于推理强度档位的不同以及 DevEco Code 客户端侧的上下文分配策略。
原因分析
GLM-5.3 提供三档推理强度:low、high、max。不同档位的核心区别在于思考模式(reasoning)的深度和思维链(Chain of Thought)的长度消耗:
- high 档位:推理强度适中,思维链占用空间较少,DevEco Code 可将大部分上下文窗口分配给用户输入,因此可用上下文接近模型标称的 1M。
- max 档位:最高推理强度,会启用深度思考模式,模型在处理请求时需要生成更长的思维链来进行多步推理。GLM-5.3 的最大思维链长度可达 131072 tokens(128K),最大输出长度同样为 131072 tokens(128K)。为了保证推理过程中思维链和输出有足够的空间不发生截断,DevEco Code 在 max 档位下对用户可输入的上下文做了预留限制,将可用输入上下文压缩至约 170K 左右。
简而言之,这并非 GLM-5.3 模型本身的上下文能力下降,而是 DevEco Code 在 max 档位下为了保证深度推理质量,主动为思维链和推理输出预留了大量 token 空间,从而减少了可供用户输入使用的上下文配额。
解决办法
如果需要更大的输入上下文,可以通过以下方式调整:
- 切换推理档位:在不需要极深推理的任务中,使用 high 档位即可恢复更大的上下文窗口。
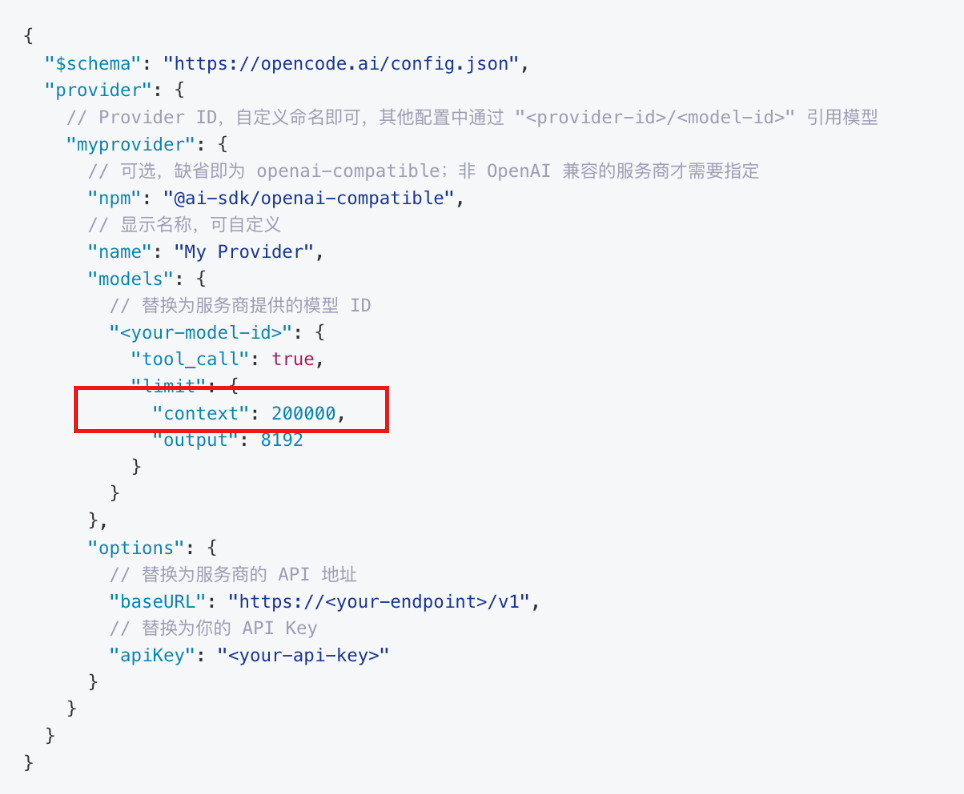
- 修改配置文件:DevEco Code 支持通过
deveco.jsonc配置文件自定义模型的上下文限制。可以在配置中找到对应模型的limit.context字段并手动调大,例如:
{
"$schema": "https://opencode.ai/config.json",
"provider": {
"deveco": {
"name": "DevEco Code",
"models": {
"glm-5.3-max": {
"tool_call": true,
"limit": {
"context": 800000, // 根据实际需求调整
"output": 131072
}
}
}
}
}
}
需要注意的是,手动调大 context 值后,如果实际输入 token 数加上思维链和输出 token 数超过了模型 1M 的总上限,可能会出现请求失败或响应截断的情况,建议根据实际任务规模合理设置。
- 为了保障您的信息安全,请勿上传您的敏感个人信息(如您的密码等信息)和您的敏感资产信息(如关键源代码、签名私钥、调试安装包、业务日志等信息),且您需自行承担由此产生的信息泄露等安全风险。
- 如您发布的内容为转载内容,请注明内容来源。
我要提问题
HarmonyOS 上下文的获取 (API12+)
HarmonyOS 如何获取上下文,以及路由(getRouter)(API12+)
HarmonyOS Internal error. UI execution context not found.Error code:100001(API12+)
HarmonyOS 异常情况下,decodeWithStream是否可能返回error值?(API12+)
HarmonyOS 为什么RichEditor的最大高度是100,输入多行文本后,整个框都撑出去了?(API12)
HarmonyOS Text Span TextOverflow.MARQUEE文字仅显示一半高度 (API12+)
HarmonyOS Flex无法限制高度(API12+)
HarmonyOS 应用分层图标大小(API12+)


苏公安网备 32011402010933号