















楔子
这篇文章是Alexander Hendorf 在PyData Florence 2017上做的报告。报告前半部分主要为初学者介绍Pandas的基本功能,如数据输入/输出、可视化、聚合与选择与访问,后半部分主要介绍如何使用Pandas进行时间序列分析,源代码亲测可用。
PS:PyData会议聚集数据分析工具的用户和开发者,大家交流经验、相互学习,为各领域的数据科学爱好者提供一个经验共享平台,一起讨论如何使用语言和工具应对来自数据管理、处理、分析和可视化各方面的挑战。
【Pandas起源与目标】
1. 开源Python库
2. 实际数据分析-高速/高效/简单
3. 无缝连接工作流
4. Wes McKinney 2008年开始编写, 再到现在Continuum Analytics的Anaconda
5. 定期更新的稳定项目
6. 地址:https://github.com/pandas-dev/pandas
【特征】
1. 支持CSV, Excel, JSON, SQL, SAS, clipboard, HDF5等数据格式
2. 数据清洗
3. 重塑(reshape)、数据合并(joins & merge)、数据透视(pivot)
4.数据可视化
5. 良好支持Jupyter notebooks (iPython)
6.类似数据库操作
7. 高性能
本文示例代码地址:https://github.com/Koenigsweg/data-timeseries-analysis-with-pandas
Part 1 Pandas基础功能
1. DataSeries & DataFrame
2. I/O(输入/输出)
3.Data analysis &aggregation(数据分析&聚合)
4.Indexes(索引)
5. Visualization(可视化)
6.Interacting with the Data(数据交互)
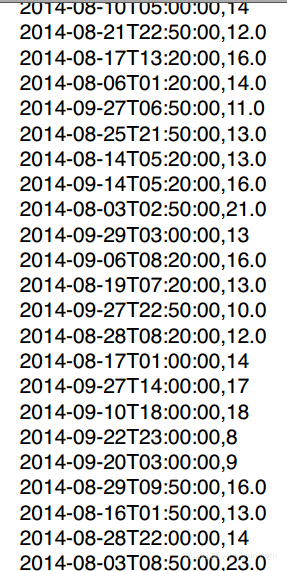
Note: 下面的例子都是在时间戳--温度数据上运行的,示例如下:
【输入/输出】
1. import pandas as pd
2. # 读取数据
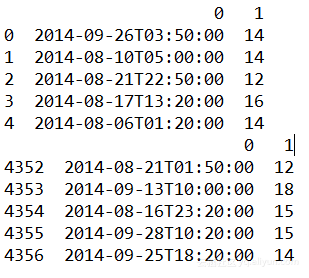
3. df = pd.read_csv('raw_weather_data_aug_sep_2014/tempm.csv', header=None)  4. print df.head(5)   #输出前n行
5. print df.tail(5)   #输出最后n行
得到:
【可视化】
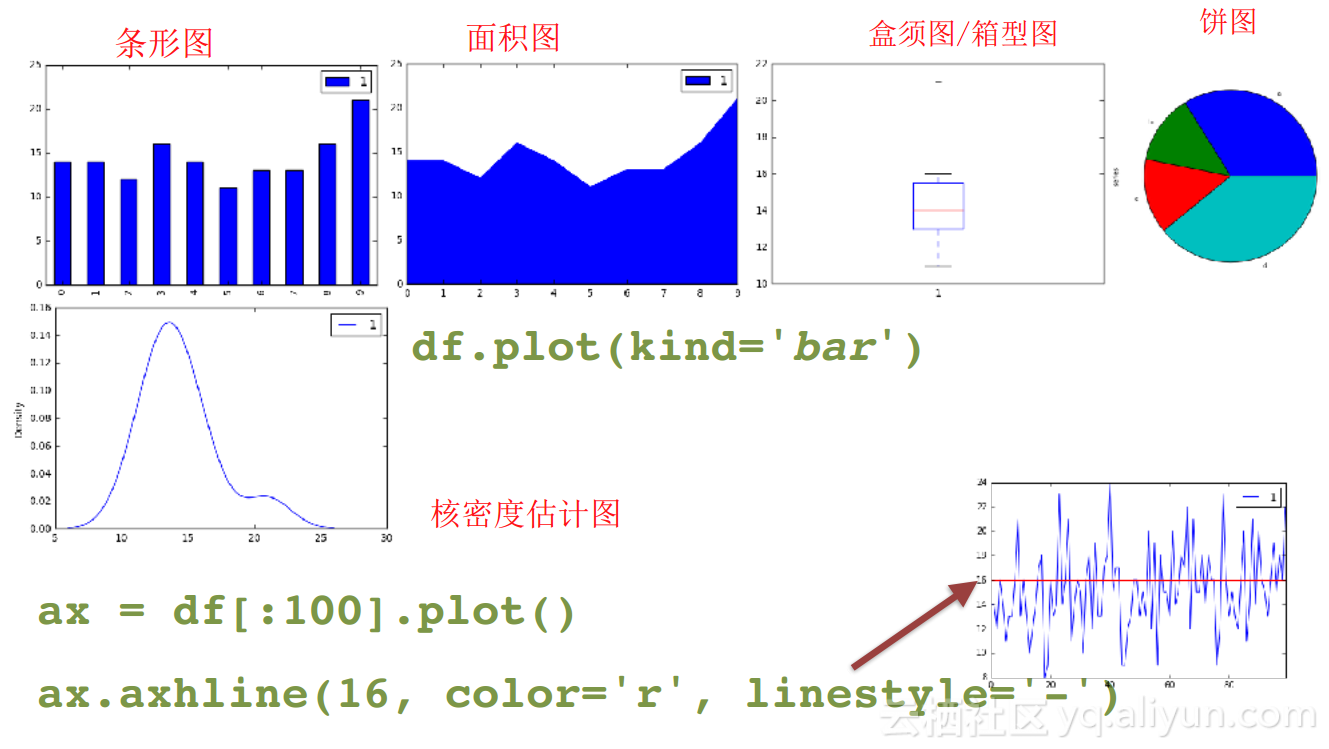
1. 使用Matplotlib库,.plot() 函数
2. 可定制,可扩展
3. 盒图、条形图、散点图等
4. 也可以使用Bokeh库或Seaborn库
【数据结构:Series和DataFrame】
【Series篇】
1. 一维有标签数组结构,可以存入任一种python的数据类型(integers, strings, floating point numbers, Python objects, etc.)
2. 序列的标签通常称为索引(index)
3. 如果index没给定,会自动创建()
4. pd.Series()函数中的参数,如data, index和dtype, 均是可选的
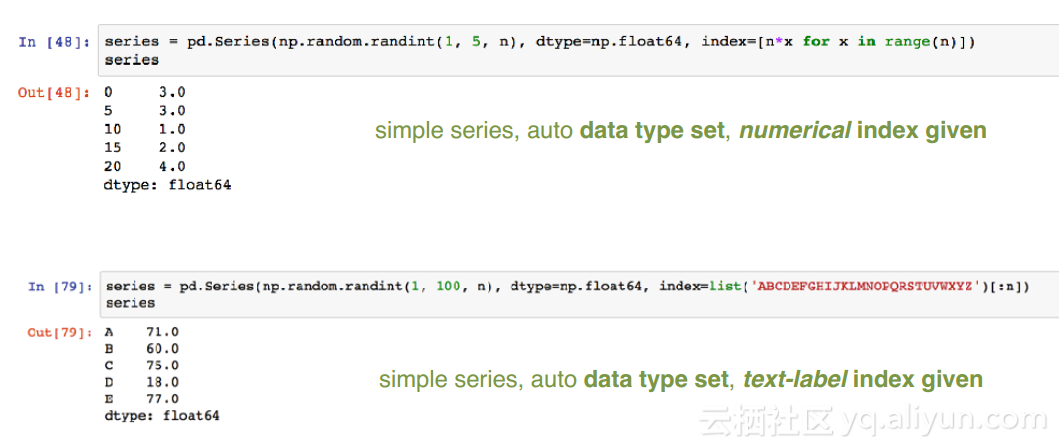
数据选择与访问方式:
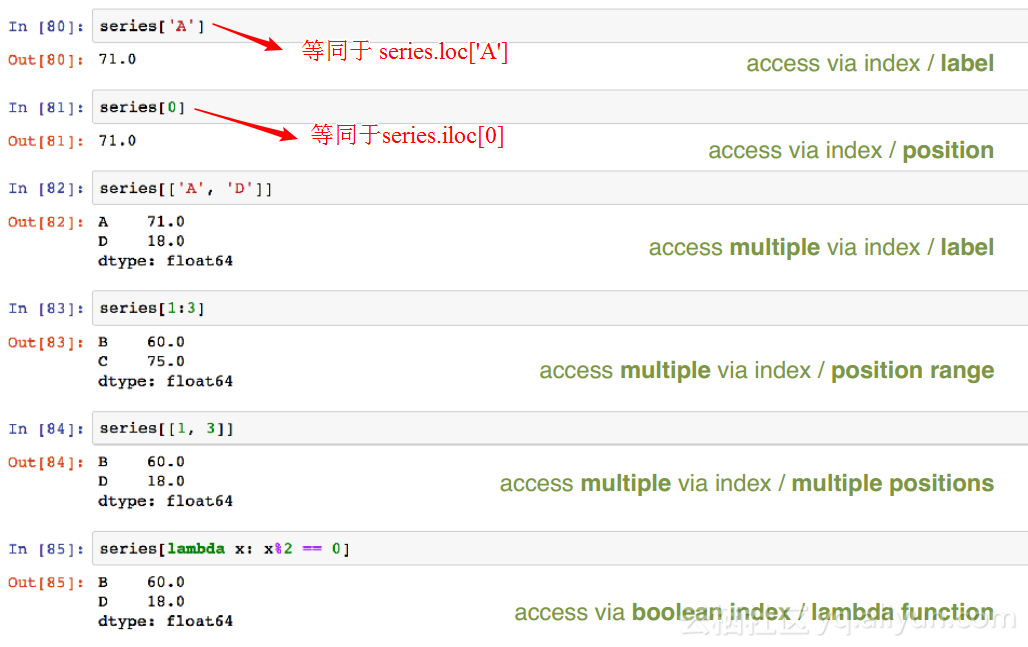
1. 可以通过标签(index)选择,也可以通过位置来选择(从0开始);
2. 通过切片/布尔索引访问数据,例如:
1. series[x], series[[x, y]] 2. series[2], series[[2, 3]], series[2:3] 3. series.ix() / .iloc() / .loc() 4. # .ix()这种方式相当于混合了loc()和iloc()两种方式
【DataFrame】
二维有标签数据结构,如2维Numpy数组,关于索引,有如下规定:
1.如果没有指定索引,将会自动创建;
2.索引可以重置或者替换;
3. 类型:位置,时间戳,时间范围,标签…;
4.一个索引号可能会出现多次(不唯一)
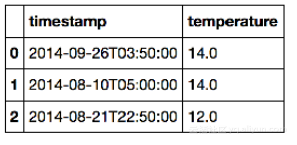
例1. 给列命名
1. df.columns = ['timestamp', 'temperature'] 2. df.head(3)输出:
例2. 对数据进行运算:
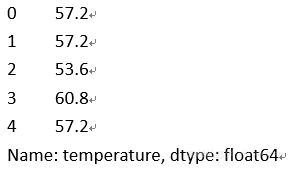
1. def to_fahrenheit(celsius): 2. return (celsius * 9./5.) + 32. 3. df['temperature'].map(to_fahrenheit)[:5] 4. df['temperature F'] = df['temperature'].map(to_fahrenheit) 5. df.head(5) 6. df['temperature F'] = df['temperature'].apply(lambda x: (x * 9./5.) + 32.) 7. df.head()
第3行仅仅是对temperature这一列进行了运算,则输出:
而第4行和第6行为不存在的列(temperature F)赋值,创建新列(temperatureF),均输出:
timestamp | temperature | temperature F | |
0 | 2014-09-26T03:50:00 | 14.0 | 57.2 |
1 | 2014-08-10T05:00:00 | 14.0 | 57.2 |
2 | 2014-08-21T22:50:00 | 12.0 | 53.6 |
3 | 2014-08-17T13:20:00 | 16.0 | 60.8 |
4 | 2014-08-06T01:20:00 | 14.0 | 57.2 |
例3. 两列之间也可以直接进行运算,如
1. df['ruleoftumb'] = df['temperature F'] / df['temperature'] 2. df.head()
输出:
timestamp | temperature | temperature F | ruleoftumb | |
0 | 2014-09-26T03:50:00 | 14.0 | 57.2 | 4.085714 |
1 | 2014-08-10T05:00:00 | 14.0 | 57.2 | 4.085714 |
2 | 2014-08-21T22:50:00 | 12.0 | 53.6 | 4.466667 |
3 | 2014-08-17T13:20:00 | 16.0 | 60.8 | 3.800000 |
4 | 2014-08-06T01:20:00 | 14.0 | 57.2 | 4.085714 |
【修改Series和DataFrame】
Series和DataFrame的方法实际上并没有修改原始的Series和DataFrame,而是返回一个新的Series或DataFrame,可以使用inplace参数来决定是否要用新结果替换掉原来的数据。
原列名被替换,输出:
timestamp | temperature | temperature F | bad_rule | |
0 | 2014-09-26T03:50:00 | 14.0 | 57.2 | 4.085714 |
1 | 2014-08-10T05:00:00 | 14.0 | 57.2 | 4.085714 |
2 | 2014-08-21T22:50:00 | 12.0 | 53.6 | 4.466667 |
3 | 2014-08-17T13:20:00 | 16.0 | 60.8 | 3.800000 |
4 | 2014-08-06T01:20:00 | 14.0 | 57.2 | 4.085714 |
删除bad_rule列,使用新DataFrame替代原DataFrame
5. # 删除列,inplace参数同上
6. df.drop('bad_rule', axis=1, inplace=True)  7. df.head()
输出:
timestamp | temperature | temperature F | |
0 | 2014-09-26T03:50:00 | 14.0 | 57.2 |
1 | 2014-08-10T05:00:00 | 14.0 | 57.2 |
2 | 2014-08-21T22:50:00 | 12.0 | 53.6 |
3 | 2014-08-17T13:20:00 | 16.0 | 60.8 |
4 | 2014-08-06T01:20:00 | 14.0 | 57.2 |
【数据聚集】
1. describe()
2. groupby()
3. groupby([]) & unstack()
4. mean(), sum(), median(),…
例1. 创建新列:
1. # .mean()函数计算指定数据的均值
2. df['deviation'] = df['temperature'] - df['temperature'].mean()  3. df.head()
输出:
timestamp | temperature | temperature F | deviation | |
0 | 2014-09-26T03:50:00 | 14.0 | 57.2 | -1.590951 |
1 | 2014-08-10T05:00:00 | 14.0 | 57.2 | -1.590951 |
2 | 2014-08-21T22:50:00 | 12.0 | 53.6 | -3.590951 |
3 | 2014-08-17T13:20:00 | 16.0 | 60.8 | 0.409049 |
4 | 2014-08-06T01:20:00 | 14.0 | 57.2 | -1.590951 |
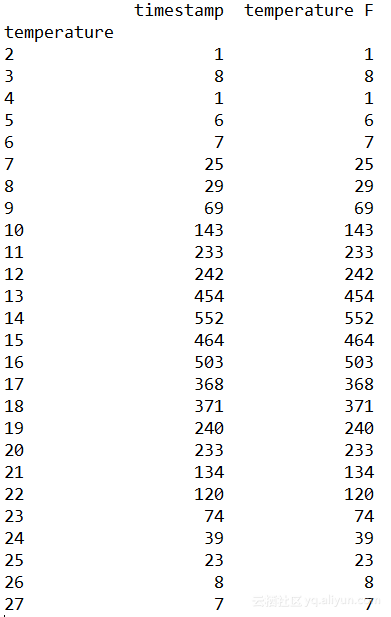
例2. 用groupby()分组
1. #按温度分组,统计每个温度出现的次数
2. df.groupby('temperature').count()
输出:
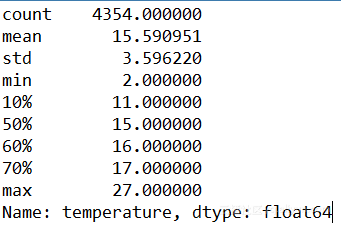
例3. 输出指定数据统计信息
1. # describe()方法返回数据的统计信息,不考虑空值
2. df['temperature'].describe(percentiles=[.1,.5,.6,.7])
输出:
【缺失值处理】
NaN表示空值,可以使用drop( )移除;也可以用默认值替换或者前向填充/后向填充


 苏公安网备 32011402010933号