















例1. 使用Isnull( )函数判断是否为空
1. df['temperature'].isnull()[2350:2357]输出:
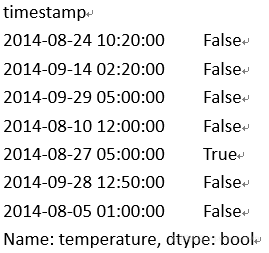
例2. 删除缺失值:
1. df.dropna(inplace=True) 2. print df['temperature'].isnull().any()
输出: False ,因为已经删除缺失值,并且用删除之后的数据替换掉原数据,所以判断是否存在空值时,返回False,即不存在空数据。
Part2 时间序列分析(以时间戳为index的序列)
在进行时间序列分析时,先将DataFrame的索引值由默认的数字索引变为时间戳索引:
1. #新增一列deviation,然后将默认的索引值变为时间戳索引值
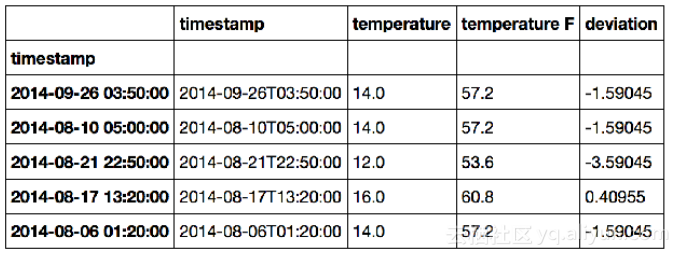
2. df['deviation']=df['temperature']-df['temperature'].mean()  3. df.index=pd.to_datetime(df['timestamp'])  4. df.head()
此时,DataFrame变为如下形式:
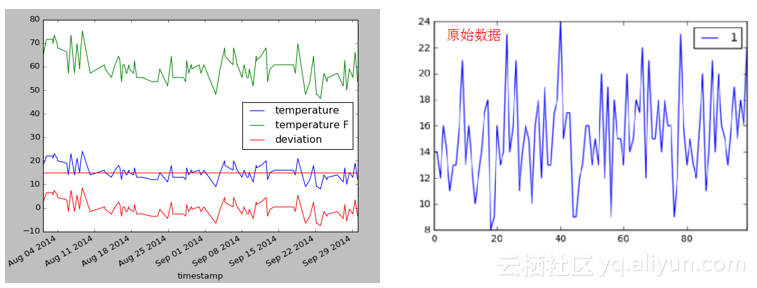
画出DataFrame前100行,此时图的横坐标不再是数值索引,而是时间戳。如下:
1. ax=df[:100].plot() 2. ax.axhline(df[:100]['temperature'].median(),color='r',linestyle='-')3. plt.show()
此时,对DataFrame加入weekday列和weekend列,
1. # DatetimeIndex.weekday 将返回该日期是一星期中的第几天,星期一是0,星期天是6  2. df['weekday'] = df.index.weekday
3. # isin()返回布尔值,表示df['weekday']是否在{5,6}中,
4. # 即判断是否是周末
5. df['weekend'] = df['weekday'].isin({5, 6})  6. # 根据日期来分组,进行统计
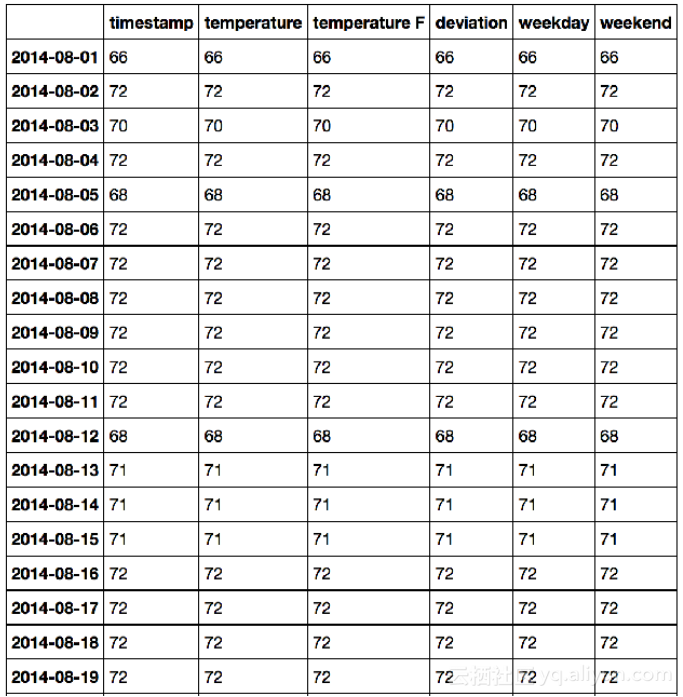
7. df.groupby(df.index.date).count()
目前,已经得到每天的数据包括时间戳,摄氏温度,华氏温度,偏差以及周几和是否周末,统计输出如下:
那么就可以进一步分析温度随着时间的变化趋势,比如观察每周气温的变化情况:
1. # 以周为时间单位进行聚合,分析气温的变化情况
2. # 前面已经将时间序列作为索引值,那么这里df.index.week返回的是一年的第几周3. df.groupby(df.index.week).plot()
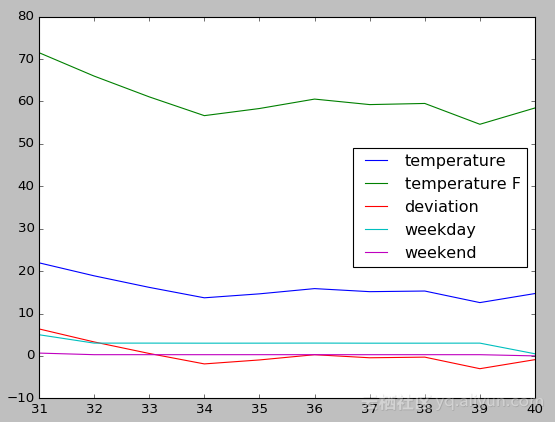
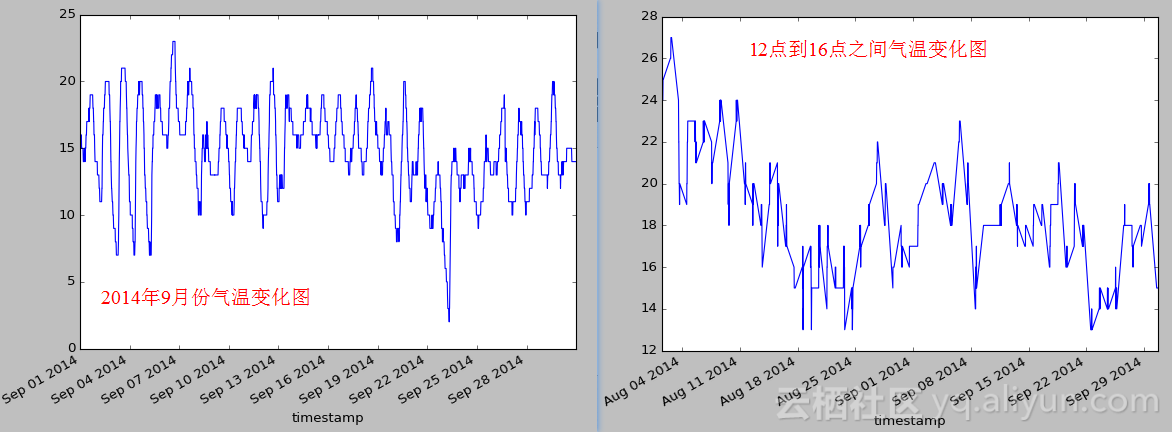
也可以分析指定时间内的温度变化趋势
时间序列重采样(resample)
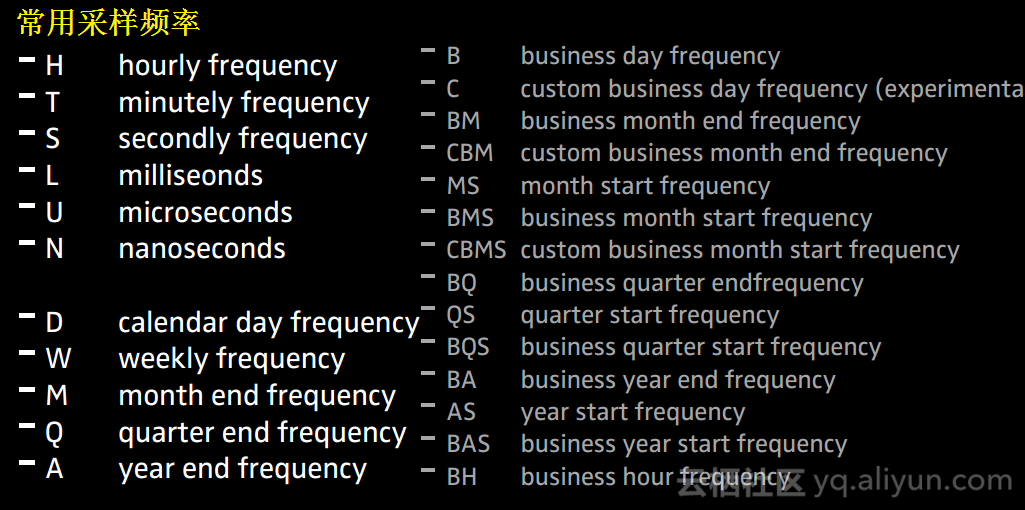
重采样是对原样本重新处理的一个方法,是一个对常规时间序列数据重新采样和频率转换的便捷的方法,分为降采样和升采样,将高频率数据聚合到低频率数据称为降采样(downsampling),将低频率转换到高频率称为升采样(upsampling)。
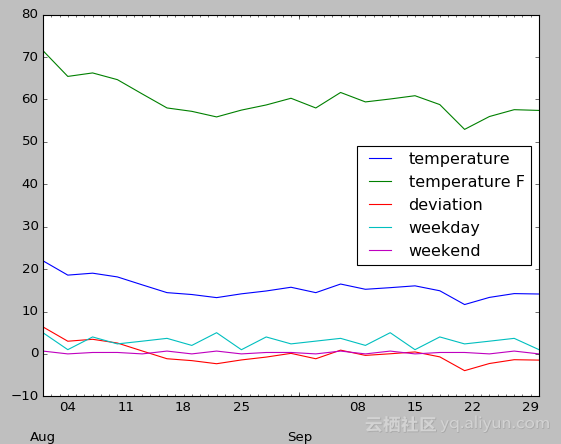
首先用DataFrame进行重采样:
1. # 按3天为时间间隔采样
2. df.resample('3D').plot()
输出:
又如对Series进行降采样:
1. import random
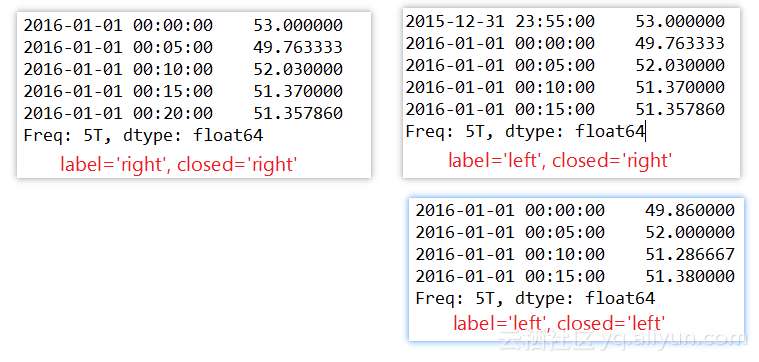
2. index = pd.date_range('1/1/2016', periods=1200, freq='S') 3. series = pd.Series([random.randint(0,100) for p in range(1200)], index=index)  4. # label参数表示采用区间左边的时间戳还是右边的时间戳,
5. # closed参数表示区间是左边闭合还是右边闭合,和数学中[  ),(  ]区间表示形式一样
6. # 一个时间戳只能属于一个时间段,所有时间段合并起来必须能组成原始的整个时间帧7. # 降采样,从之前的1秒变为5分钟8. resampled = series.resample('5T', label='right', closed='right')  9. print resampled
10. print series.resample('5T', label='left', closed='right')  11. print series.resample('5T', label='left', closed='left')
输出:
升采样,采样频率从5分钟变到100秒,
1. # 升采样默认会引入缺失值2. print resampled.resample('100S')[:6]  3. # ffill()向前填充,即用上一个有效值填充缺失数据
4. # bfill()向后填充,即用下一个有效值填充缺失数据
5. print resampled.resample('100S').ffill()[:6]  6. print resampled.resample('100S').bfill()[:6]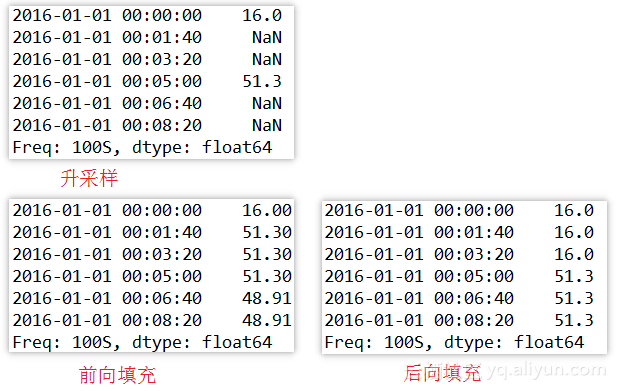
使用statsmodels库进一步分析时序数据
Note: statsmodels是一个包含统计模型、统计测试和统计数据挖掘python模块。对每一个模型都会生成一个对应的统计结果。统计结果会和现有的统计包进行对比来保证其正确性。
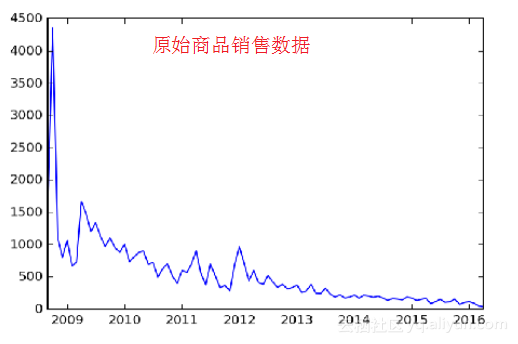
如上图所示,是某种商品的历史销售数据,为了更好地分析商品销售变化趋势,将销售时序数据分解为长期趋势、季节趋势和随机成分。statsmodels支持两类分解模型,加法模型和乘法模型。默认采用加法模型,即分解后的这3个趋势相加要等于原始数据。
1. dtap=pd.DataFrame(mdf.groupby(mdf.index)['activity'].sum())  2. # 对缺失数据插值
3. dtap.activity.interpolate(inplace=True)  4. res=sm.tsa.seasonal_decompose(dtap.activity)  5. resplot=res.plot()  6. resplot.set_size_inches(15,15)
输出:
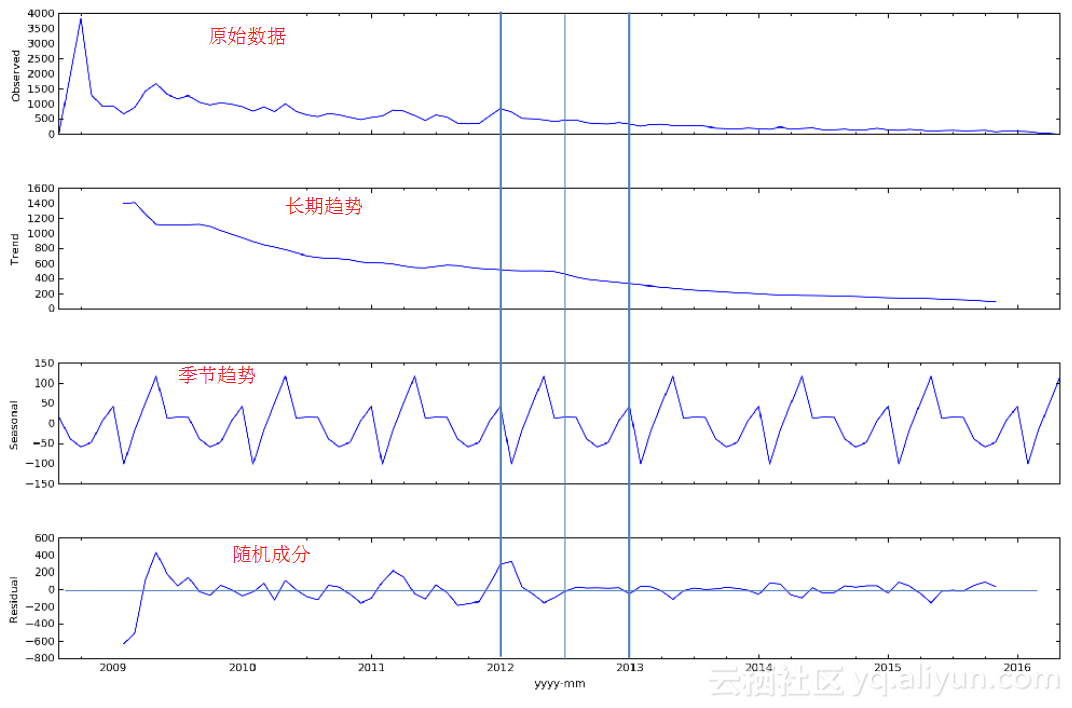
在得到不同的分解成分后,就可以使用时间序列模型对各个成分进行拟合,进行商品销量预测,这对商家库存管理和销售是很有帮助的。
尾声
安利一个会议:EuroPython 2017, 欧洲最大的Python会议,欢迎参加。
作者介绍
Alexander C. S. Hendorf
为创业和业界提供咨询服务
EuroPython & PyConDE 的组织者和程序委员会主席
MongoDB大师曾在MongoDB world, EuroPython, PyData等大会上作学术报告
以上为译文
文章原标题《Introduction to Pandas and Time Series Analysis》,作者:Alexander C. S. Hendorf,译者:李烽 审校:海棠-段志成文章为简译,更为详细的内容,请查看原文。
PS:中文译制PDF版食用更佳,可读性更强,见附件。


 苏公安网备 32011402010933号