















6.1、区别
List,Set都是继承自Collection接口,Map则不是;
List特点:元素有放入顺序,元素可重复; Set特点:元素无放入顺序,元素不可重复,重复元素会覆盖掉,(注意:元素虽然无放入顺序,但是元素在set中的位置是有该元素的HashCode决定的,其位置其实是固定的,加入Set 的Object必须定义equals()方法;
LinkedList、ArrayList、HashSet是非线程安全的,Vector是线程安全的;
HashMap是非线程安全的,HashTable是线程安全的;
6.2、List和Vector比较
Vector是多线程安全的,线程安全就是说多线程访问同一代码,不会产生不确定的结果。而ArrayList不是,这个可以从源码中看出,Vector类中的方法很多有synchronized进行修饰,这样就导致了Vector在效率上无法与ArrayList相比;
两个都是采用的线性连续空间存储元素,但是当空间不足的时候,两个类的增加方式是不同。
Vector可以设置增长因子,而ArrayList不可以。
Vector是一种老的动态数组,是线程同步的,效率很低,一般不赞成使用。
6.3、HashSet如何保证不重复
HashSet底层通过HashMap来实现的,在往HashSet中添加元素是
public boolean add(E e) {
return map.put(e, PRESENT)==null;
}


// Dummy value to associate with an Object in the backing Map
private static final Object PRESENT = new Object();
在HashMap中进行查找是否存在这个key,value始终是一样的,主要有以下几种情况:
如果hash码值不相同,说明是一个新元素,存;
如果hash码值相同,且equles判断相等,说明元素已经存在,不存;
如果hash码值相同,且equles判断不相等,说明元素不存在,存;
如果有元素和传入对象的hash值相等,那么,继续进行equles()判断,如果仍然相等,那么就认为传入元素已经存在,不再添加,结束,否则仍然添加;
6.4、HashSet与Treeset的适用场景
HashSet是基于Hash算法实现的,其性能通常都优于TreeSet。为快速查找而设计的Set,我们通常都应该使用HashSet,在我们需要排序的功能时,我们才使用TreeSet。
TreeSet 是二叉树(红黑树的树据结构)实现的,Treeset中的数据是自动排好序的,不允许放入null值
HashSet是哈希表实现的,HashSet中的数据是无序的,可以放入null,但只能放入一个null,两者中的值都不能重复,就如数据库中唯一约束。
HashSet是基于Hash算法实现的,其性能通常都优于TreeSet。为快速查找而设计的Set,我们通常都应该使用HashSet,在我们需要排序的功能时,我们才使用TreeSet。
6.5、HashMap与TreeMap、HashTable的区别及适用场景
HashMap 非线程安全,基于哈希表(散列表)实现。使用HashMap要求添加的键类明确定义了hashCode()和equals()[可以重写hashCode()和equals()],为了优化HashMap空间的使用,您可以调优初始容量和负载因子。其中散列表的冲突处理主要分两种,一种是开放定址法,另一种是链表法。HashMap的实现中采用的是链表法。
TreeMap:非线程安全基于红黑树实现,TreeMap没有调优选项,因为该树总处于平衡状态
7、 常量池
7.1、Interger中的128(-128~127)
当数值范围为-128~127时:如果两个new出来Integer对象,即使值相同,通过“”比较结果为false,但两个对象直接赋值,则通过“”比较结果为“true,这一点与String非常相似。
当数值不在-128~127时,无论通过哪种方式,即使两个对象的值相等,通过“”比较,其结果为false;
当一个Integer对象直接与一个int基本数据类型通过“”比较,其结果与第一点相同;
Integer对象的hash值为数值本身;
@Override
public int hashCode() {
return Integer.hashCode(value);
}
7.2、为什么是-128-127?
在Integer类中有一个静态内部类IntegerCache,在IntegerCache类中有一个Integer数组,用以缓存当数值范围为-128~127时的Integer对象。
8、泛型
泛型是Java SE 1.5的新特性,泛型的本质是参数化类型,也就是说所操作的数据类型被指定为一个参数。这种参数类型可以用在类、接口和方法的创建中,分别称为泛型类、泛型接口、泛型方法。 Java语言引入泛型的好处是安全简单。
泛型的好处是在编译的时候检查类型安全,并且所有的强制转换都是自动和隐式的,提高代码的重用率。
它提供了编译期的类型安全,确保你只能把正确类型的对象放入 集合中,避免了在运行时出现ClassCastException。
使用Java的泛型时应注意以下几点:
泛型的类型参数只能是类类型(包括自定义类),不能是简单类型。
同一种泛型可以对应多个版本(因为参数类型是不确定的),不同版本的泛型类实例是不兼容的。
泛型的类型参数可以有多个。
泛型的参数类型可以使用extends语句,例如。习惯上称为“有界类型”。
泛型的参数类型还可以是通配符类型。例如Class<?> classType =
Class.forName(“java.lang.String”);
8.1 T泛型和通配符泛型
? 表示不确定的java类型。
T 表示java类型。
K V 分别代表java键值中的Key Value。
E 代表Element。
8.2 泛型擦除
Java中的泛型基本上都是在编译器这个层次来实现的。在生成的Java字节码中是不包含泛型中的类型信息的。使用泛型的时候加上的类型参数,会在编译器在编译的时候去掉。这个过程就称为类型擦除。
泛型是通过类型擦除来实现的,编译器在编译时擦除了所有类型相关的信息,所以在运行时不存在任何类型相关的信息。例如 List在运行时仅用一个List来表示。这样做的目的,是确保能和Java 5之前的版本开发二进制类库进行兼容。你无法在运行时访问到类型参数,因为编译器已经把泛型类型转换成了原始类型。
8.3 限定通配符
限定通配符对类型进行了限制。
一种是<? extends T>它通过确保类型必须是T的子类来设定类型的上界,
另一种是<? super T>它通过确保类型必须是T的父类来设定类型的下界。
另一方面<?>表 示了非限定通配符,因为<?>可以用任意类型来替代。
例如List<? extends Number>可以接受List或List。
8.4 泛型面试题
你可以把List传递给一个接受List参数的方法吗?
对任何一个不太熟悉泛型的人来说,这个Java泛型题目看起来令人疑惑,因为乍看起来String是一种Object,所以 List应当可以用在需要List的地方,但是事实并非如此。真这样做的话会导致编译错误。如 果你再深一步考虑,你会发现Java这样做是有意义的,因为List可以存储任何类型的对象包括String, Integer等等,而List却只能用来存储Strings。
Array中可以用泛型吗?
Array事实上并不支持泛型,这也是为什么Joshua Bloch在Effective Java一书中建议使用List来代替Array,因为List可以提供编译期的类型安全保证,而Array却不能。
Java中List和原始类型List之间的区别?
原始类型和带参数类型之间的主要区别是,在编译时编译器不会对原始类型进行类型安全检查,却会对带参数的类型进行检查,通过使用Object作为类型,可以告知编译器该方法可以接受任何类型的对象,比如String或Integer。这道题的考察点在于对泛型中原始类型的正确理解。它们之间的第二点区别是,你可以把任何带参数的类型传递给原始类型List,但却不能把List传递给接受 List的方法,因为会产生编译错误。
List<?> 是一个未知类型的List,而List 其实是任意类型的List。你可以把List, List赋值给List<?>,却不能把List赋值给 List。
9、反射
9.1、概念
JAVA反射机制是在运行状态中,对于任意一个类,都能够知道这个类的所有属性和方法;对于任意一个对象,都能够调用它的任意一个方法;这种动态获取的信息以及动态调用对象的方法的功能称为java语言的反射机制。
9.2、作用
Java反射机制主要提供了以下功能: 在运行时判断任意一个对象所属的类;在运行时构造任意一个类的对象;在运行时判断任意一个类所具有的成员变量和方法;在运行时调用任意一个对象的方法;生成动态代理。
10、代理
代理这个词大家肯定已经非常熟悉,因为现实中接触的很多,其实现实中的东西恰恰可以非常形象和直观地反映出模式的抽象过程以及本质。现在房子不是吵得热火朝天吗?我们就以房子为例,来拨开代理的面纱。
假设你有一套房子要卖,一种方法是你直接去网上发布出售信息,然后直接带要买房子的人来看房子、过户等一直到房子卖出去,但是可能你很忙,你没有时间去处理这些事情,所以你可以去找中介,让中介帮你处理这些琐碎事情,中介实际上就是你的代理。本来是你要做的事情,现在中介帮助你一一处理,对于买方来说跟你直接交易跟同中介直接交易没有任何差异,买方甚至可能觉察不到你的存在,这实际上就是代理的一个最大好处。
接下来我们再深入考虑一下为什么你不直接买房子而需要中介?其实一个问题恰恰解答了什么时候该用代理模式的问题。
原因一:你可能在外地上班,买房子的人没法找到你直接交易。
对应到我们程序设计的时候就是:客户端无法直接操作实际对象。那么为什么无法直接操作?一种情况是你需要调用的对象在另外一台机器上,你需要跨越网络才能访问,如果让你直接coding去调用,你需要处理网络连接、处理打包、解包等等非常复杂的步骤,所以为了简化客户端的处理,我们使用代理模式,在客户端建立一个远程对象的代理,客户端就象调用本地对象一样调用该代理,再由代理去跟实际对象联系,对于客户端来说可能根本没有感觉到调用的东西在网络另外一端,这实际上就是Web Service的工作原理。另一种情况虽然你所要调用的对象就在本地,但是由于调用非常耗时,你怕影响你正常的操作,所以特意找个代理来处理这种耗时情况,一个最容易理解的就是Word里面装了很大一张图片,在word被打开的时候我们肯定要加载里面的内容一起打开,但是如果等加载完这个大图片再打开Word用户等得可能早已经跳脚了,所以我们可以为这个图片设置一个代理,让代理慢慢打开这个图片而不影响Word本来的打开的功能。申明一下我只是猜可能Word是这么做的,具体到底怎么做的,俺也不知道。
原因二:你不知道怎么办过户手续,或者说除了你现在会干的事情外,还需要做其他的事情才能达成目的。
对应到我们程序设计的时候就是:除了当前类能够提供的功能外,我们还需要补充一些其他功能。最容易想到的情况就是权限过滤,我有一个类做某项业务,但是由于安全原因只有某些用户才可以调用这个类,此时我们就可以做一个该类的代理类,要求所有请求必须通过该代理类,由该代理类做权限判断,如果安全则调用实际类的业务开始处理。可能有人说为什么我要多加个代理类?我只需要在原来类的方法里面加上权限过滤不就完了吗?在程序设计中有一个类的单一性原则问题,这个原则很简单,就是每个类的功能尽可能单一。为什么要单一,因为只有功能单一这个类被改动的可能性才会最小,就拿刚才的例子来说,如果你将权限判断放在当前类里面,当前这个类就既要负责自己本身业务逻辑、又要负责权限判断,那么就有两个导致该类变化的原因,现在如果权限规则一旦变化,这个类就必需得改,显然这不是一个好的设计。
好了,原理的东西已经讲得差不多了,要是再讲个没完可能大家要扔砖头了。呵呵,接下来就看看怎么来实现代理。
数据结构与算法
https://zhuanlan.zhihu.com/p/27005757?utm_source=weibo&utm_medium=social
1、排序
排序有内部排序和外部排序,内部排序是数据记录在内存中进行排序,而外部排序是因排序的数据很大,一次不能容纳全部的排序记录,在排序过程中需要访问外存。
1.1、 直接插入排序
思想:
将第一个数和第二个数排序,然后构成一个有序序列
将第三个数插入进去,构成一个新的有序序列。
对第四个数、第五个数……直到最后一个数,重复第二步。
代码:
首先设定插入次数,即循环次数,for(int i=1;i<length;i++),1个数的那次不用插入。
设定插入数和得到已经排好序列的最后一个数的位数。insertNum和j=i-1。
2、设计模式
参考:Android开发中的一些设计模式
2.1、单例设计模式
单例主要分为:懒汉式单例、饿汉式单例、登记式单例。
特点:
单例类只有一个实例
单例类必须自己创建自己的唯一实例
单例类必须给所有其他对象提供这一实例。
在计算机系统中,像线程池,缓存、日志对象、对话框、打印机等常被设计成单例。
懒汉式单例:
Singleton通过将构造方法限定为private避免了类在外部被实例化,在同一个虚拟机范围内,Singleton的唯一实例只能通过getInstance()方法访问。(事实上,通过Java反射机制是能够实例化构造方法为private的类的,那基本上会使所有的Java单例实现失效。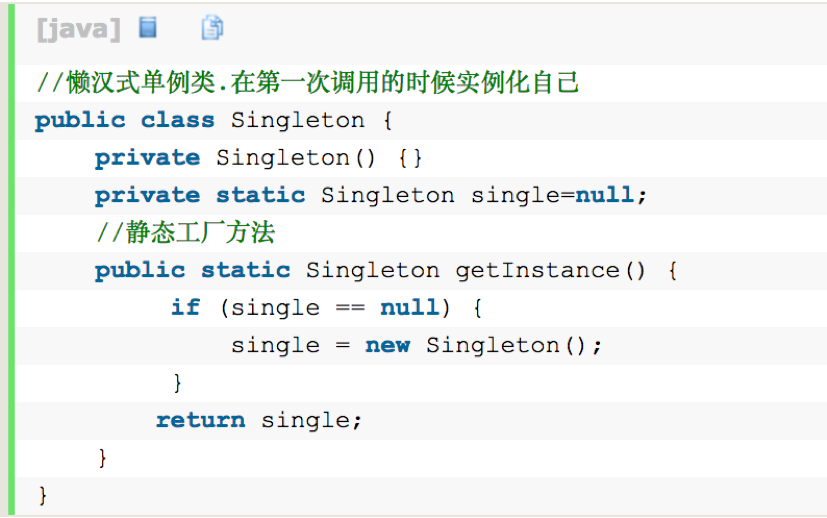
它是线程不安全的,并发情况下很有可能出现多个Singleton实例,要实现线程安全,有以下三种方式:
1.在getInstance方法上加上同步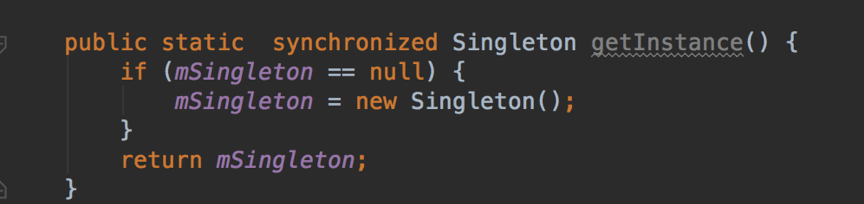
2.双重检查锁定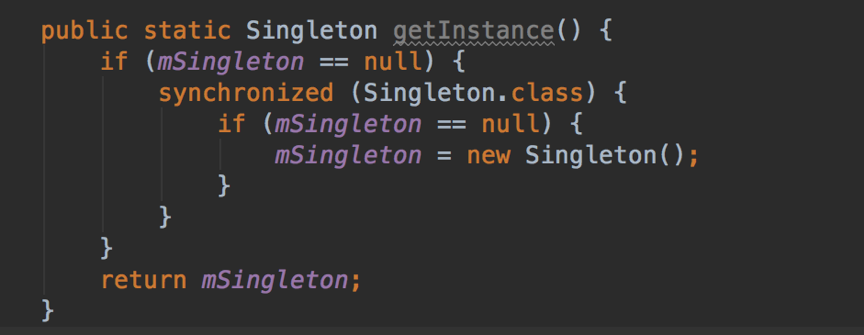
3.静态内部类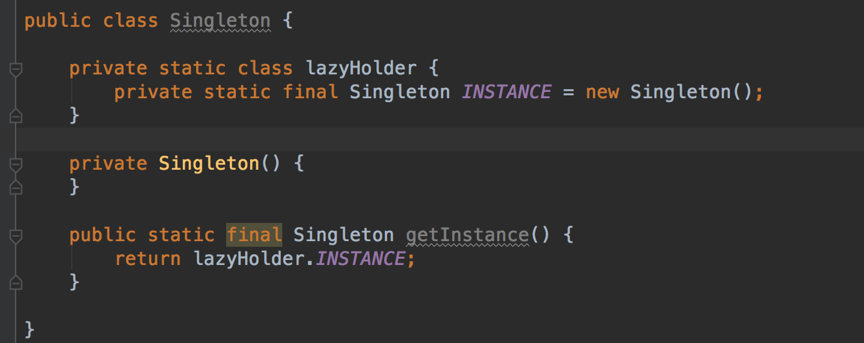
这种方式对比前两种,既实现了线程安全,又避免了同步带来的性能影响。
饿汉式单例:
饿汉式在创建类的同时就已经创建好了一个静态的对象供系统使用,以后不再改变,所以天生是系统安全。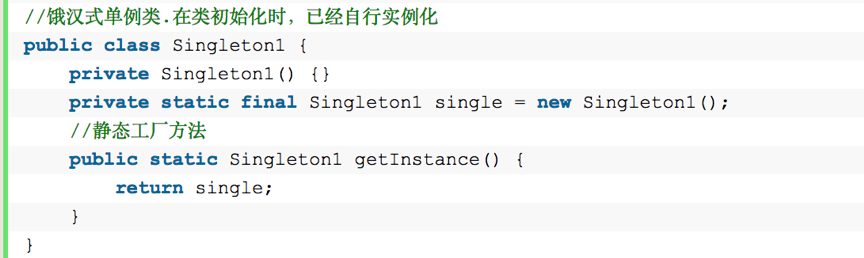


 苏公安网备 32011402010933号