















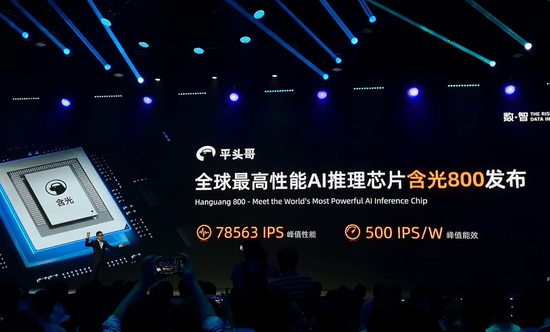
2019年云栖大会上,平头哥同学发布了首款AI芯片含光800,定位为NPU,主打视频图像推理。
有意思的是没有按常规发出INT8的算力数据,而是拿每秒处理的图像数出来对比:根据张建锋的说法,在业界标准的ResNet-50测试中,含光800推理性能达到78563 IPS(图片每秒),比目前业界最好的AI芯片性能高4倍;能效比500 IPS/W,是第二名的3.3倍。
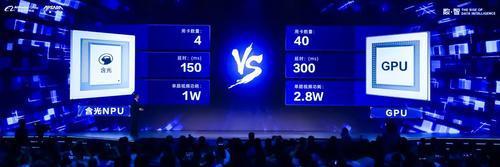
城市大脑实时处理杭州主城区交通视频,如果用传统GPU,需要40颗,延时为300ms,使用含光800仅需4颗,延时降至150ms。
再来一段媒体爆料:
含光800性能的突破得益于软硬件的协同创新,芯片架构方面,含光800采用创新的架构,针对深度学习中使用的大量权重参数和张量数据,在支持稀疏压缩与量化处理的基础上,通过独特设计的数据访存与流水线处理技术,大大减低了I/O需求和数据的搬移。NPU同时深度优化了卷积,矩阵乘,向量计算和各种激活函数,通过高有效的硬件资源调度和全并行的数据流处理,把AI运算的性能和能效都推向极致。
其中,性能的提升必须解决内存墙问题。所谓的内存墙,是指采用采用冯诺依曼结构的处理器,存储和运算处理分离,当进行深度神经网络处理时,算力得到了提升,但大量读写运行操作会受到带宽限制,芯片的整体性能提升也同时受到限制。
平头哥的做法是通过自研架构大幅减少对内存的访问,在保证性能的情况下,把芯片功耗降到最低水平。具体而言,含光800会根据神经网络推理运算特征,设计特定的硬件、高速连接的存储结构以及专用指令集,对内存和计算单元实现高效组织管理,实现单条指令完成多个操作,提高计算效率和内存访问效率。
另外,还集成了达摩院算法。针对CNN及视觉类算法深度优化计算、存储密度,可实现大网络模型在一颗NPU上完成计算。
综上所述,含光有如下特点:
1、独特的数据访存与流水线设计;
2、针对CNN及视觉类算法深度优化,达摩院算法能力的加持;
3、强调推理时延比GPU低;
4、目前都只说图像识别,没有其他的用途举例;
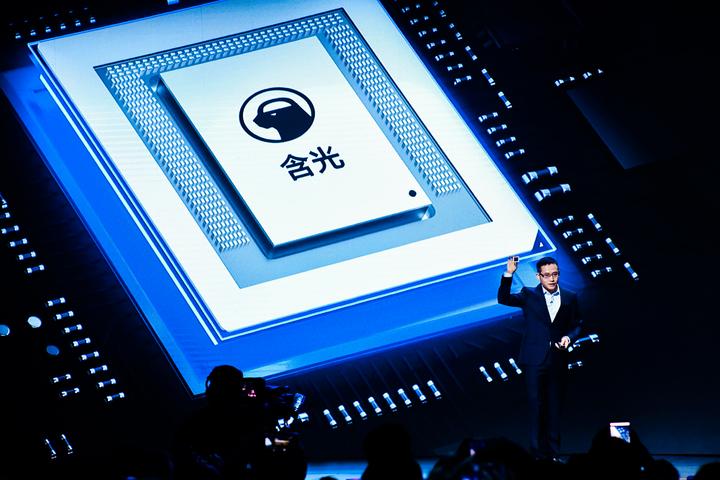
5、还有一点,就是12nm的工艺,体积相比同为推理芯片且16nm工艺的昇腾310个头真的大很多:
以上特征,是不是特别像FPGA?
再结合阿里巴巴此前已在FPGA方面的积累,在此大胆猜测,此款NPU主要还是参考了FPGA架构!
另外感觉发布会上含光800更多强调基于阿里巴巴业务自身的海量图像任务降成本,芯片的云端推理能力的售卖本人并不看好。
此次发布的意义就不是卖芯片,而是为了证明平头哥自己的芯片云端设计使能能力。7个月完成设计,3个月完成流片,可以说为众多的AIoT碎片化市场的公司打了个样(包括同日发布的天猫精灵CCL的智能语音芯片 TG6100N):
赶紧上来用我的无剑系统芯片平台、用我的飞天分布式计算平台快速开发出自己专属领域的芯片,一起来降成本吧!
最后,平头哥联合新思科技发布芯片云端设计白皮书《云端设计,与时间赛跑》。
——————————————————
BY:HW-ZLL


 苏公安网备 32011402010933号