















private void fill() throws IOException {
// 获取缓冲区
byte[] buffer = getBufIfOpen();
if (markpos < 0)
// 没有使用mark功能,重置pos
pos = 0;
else if (pos >= buffer.length)
if (markpos > 0) {
int sz = pos - markpos;
// 将 pos ~ markpos 之间的数据向左移动
// 移动完后数据位于 0 ~ sz,移动完后目前sz之后的数据无效
System.arraycopy(buffer, markpos, buffer, 0, sz);
pos = sz;
markpos = 0;
} else if (buffer.length >= marklimit) {
// 缓冲区容量大于可标记限制,所有数据都不要了
// mark标记也不要了
markpos = -1;
pos = 0;
} else if (buffer.length >= MAX_BUFFER_SIZE) {
// 缓冲区容量过大,抛出异常
throw new OutOfMemoryError('Required array size too large');
} else {
// 可标记区域大于缓冲区容量,对缓冲区进行扩容
int nsz = (pos <= MAX_BUFFER_SIZE - pos) ?
pos * 2 : MAX_BUFFER_SIZE;
if (nsz > marklimit)
nsz = marklimit;
byte nbuf[] = new byte[nsz];
System.arraycopy(buffer, 0, nbuf, 0, pos);
if (!bufUpdater.compareAndSet(this, buffer, nbuf)) {
throw new IOException('Stream closed');
}
buffer = nbuf;
}
// 记录count位置
count = pos;
// 向in读取数据,数量为缓冲区容量 - 当前缓冲区索引
int n = getInIfOpen().read(buffer, pos, buffer.length - pos);
// 读到有效数据,更新count
if (n > 0)
count = n + pos;
}
主要理解,从in读取缓冲数据,并更新pos和count,因为count - pos 得到缓冲区有效数据,pos则是有效数据的起点。
输出流缓冲 BufferedOutputStream
与输入流BufferedInputStream相似,输出流BufferedOutputStream同样是为了减少系统调度,只不过二者的数据走向方向相反。BufferedOutputStream接收数据并存入缓冲区,在缓冲池满或者主动调用flush()之后,触发系统调度,将缓冲池数据写出。平时可能少见触发flush()操作,在关闭输出流接口操作close()时,也会线触发flush()操作。
与分析BufferedInputStream时类似,输出流BufferedOutputStream直接看write()。
public synchronized void write(byte b[], int off, int len) throws IOException {
if (len >= buf.length) {
// 要写出的数据大于缓冲区的容量,也不用缓冲区策略
// 先将缓冲区数据写出
flushBuffer();
// 再直接通过输出流out直接将数据写出
out.write(b, off, len);
return;
}
if (len > buf.length - count) {
// 要写出的数据大于缓冲区还可写入的容量,将缓冲区数据写出
flushBuffer();
}
// 将要写出的数据写入到缓冲区
System.arraycopy(b, off, buf, count, len);
// 更新缓冲区已添加的数据容量
count += len;
}
当数据大于缓冲区容量时,不使用缓冲策略的原因和与分析写入流类似,都是尽可能少的进行系统调度,输出流缓冲写出过程可用下图表示。
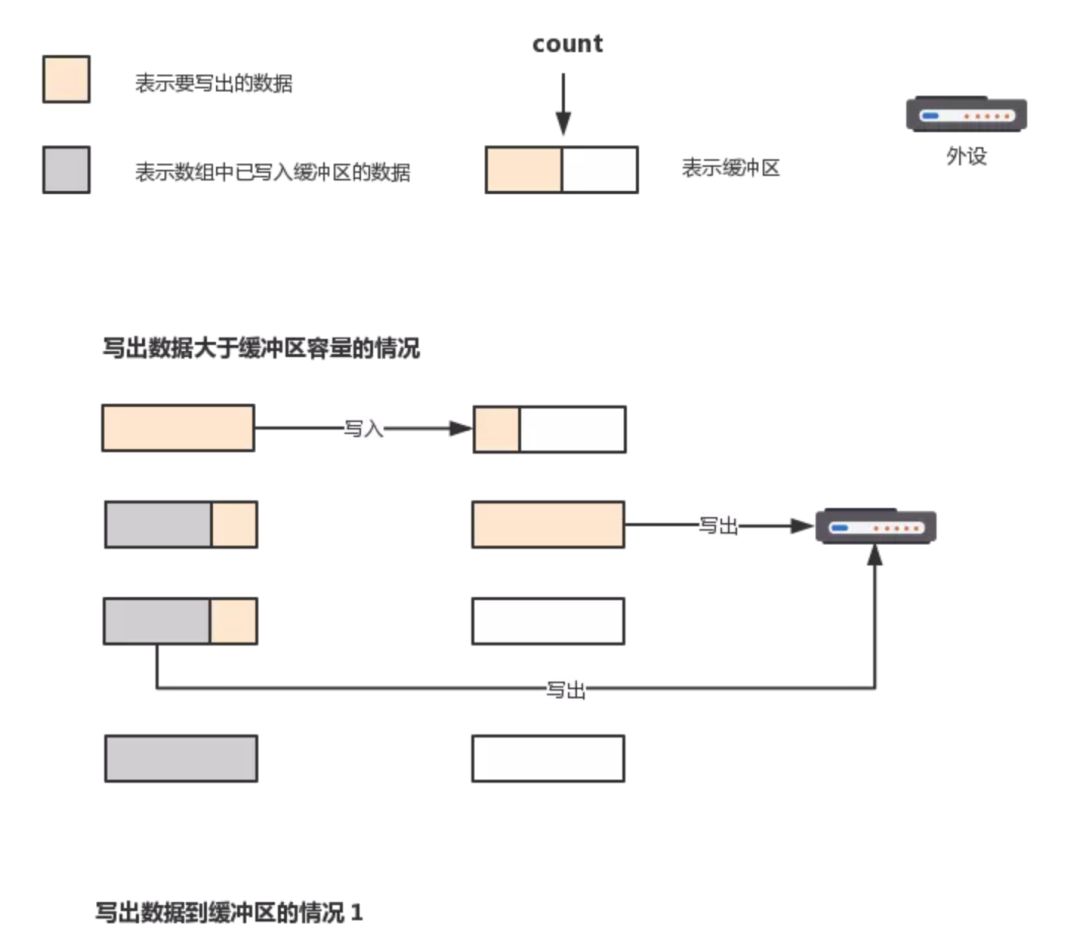
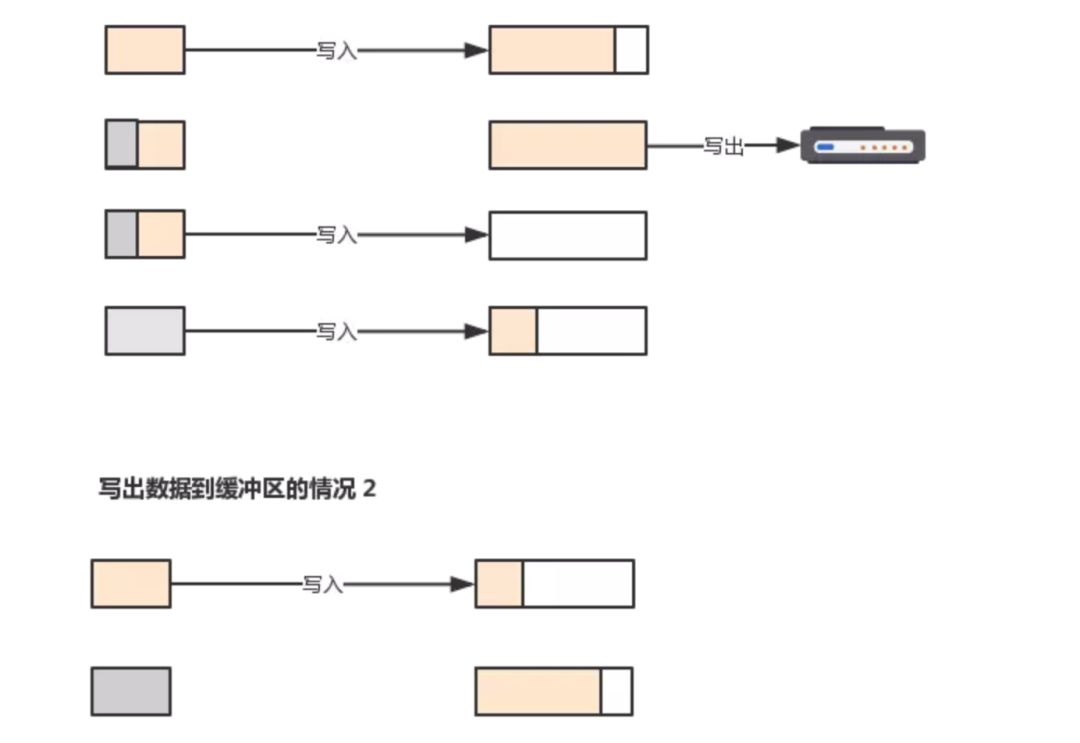
flushBuffer()就比较简单了,触发out输出流写出数据。
private void flushBuffer() throws IOException {
if (count > 0) {
out.write(buf, 0, count);
count = 0;
}
}
/ IO缓冲小结 /
IO缓冲区的存在,减少了系统调用。也就是说,如果缓冲区能满足读入/写出需求,则不需要进行系统调用,维护系统读写数据的习惯。
从上面学习的内容来看,不管是读入还是写出,缓冲区的存在必然涉及copy的过程,而如果涉及双流操作,比如从一个输入流读入,再写入到一个输出流,那么这种情况下,在缓冲存在的情况下,数据走向是:
-> 从输入流读出到缓冲区
-> 从输入流缓冲区copy到 b[]
-> 将 b[] copy 到输出流缓冲区
-> 输出流缓冲区读出数据到输出流
上面情况存在冗余copy操作,Okio应运而生。
/ Okio实现 /
在Okio里,解决了双流操作时,中间数据 b[] 存在冗余拷贝的问题。虽然这不能概括Okio的优点,但却是足够亮眼以及核心的优点。
Okio可以通过:
implementation('com.squareup.okio:okio:2.4.0')
引入,如果已引入Okttp3或者Retrofit,则无需再引入。
Okio使用Segment来作为数据存储手段。Segment 实际上也是对 byte[] 进行封装,再通过各种属性来记录各种状态。在交换时,如果可以,将Segment整体作为数据传授媒介,这样就没有具体数据的copy过程,而是交换了对应的Segment引用。Segment的数据结构如下:
final class Segment {
// 默认容量
static final int SIZE = 8192;
// 最小分享数据量
static final int SHARE_MINIMUM = 1024;
// 存储具体数据的数组
final byte[] data;
// 有效数据索引起始位置
int pos;
// 有效数据索引结束位置
int limit;
// 指示Segment是否为共享状态
boolean shared;
// 指示当前Segment是否为数据拥有者,与shared互斥
// 默认构造函数的Segment owner为true,当把数据分享
// 出去时,被分享的Segment的owner标记为false
boolean owner;
// 指向下一个Segment
Segment next;
// 指向前一个Segment
Segment prev;
}
除了用来存储具体数据的byte[]数据外,以 pos ~ limit 来标记有效的数据范围。Segment被涉及成可以被分割,在将Segment分割成两个Segment时,就会进行数据分享,即使用相同的byte[] 数组,只不过 pos ~ limit 标记不同罢了。在分享否,就需要区分个Segment是owner,哪个Segment是shared,这样,就需要对应的标志进行标记。也不难看出,Segment可以采用双向链表结构进行连接。这里不妨先看看Segment的分割函数split()。
/ Segment分割 /
public Segment split(int byteCount) {
// byteCount表示要分割出去的数据大小
// 如果byteCount大于Segment拥有的有效数据大小,抛出异常
if (byteCount <= 0 || byteCount > limit - pos) throw new IllegalArgumentException();
Segment prefix;
if (byteCount >= SHARE_MINIMUM) {
// 大于分割阀值 1024,进行数据共享
// 这个情况 prefix.pos = this.pos
prefix = new Segment(this);
} else {
// 小于分割阀值,从缓存池里换取Segment,将所需数据copy到
// 新的Segment中,这里就没有使用到共享
// 这个情况 prefix.pos = 0;
prefix = SegmentPool.take();
System.arraycopy(data, pos, prefix.data, 0, byteCount);
}
// 更新当前Segment.pos与新的Segment.limit
prefix.limit = prefix.pos + byteCount;
pos += byteCount;
// 将Segment加入到当前Segment节点的后面
prev.push(prefix);
return prefix;
}
上面的代码描述情况可以用下图表示
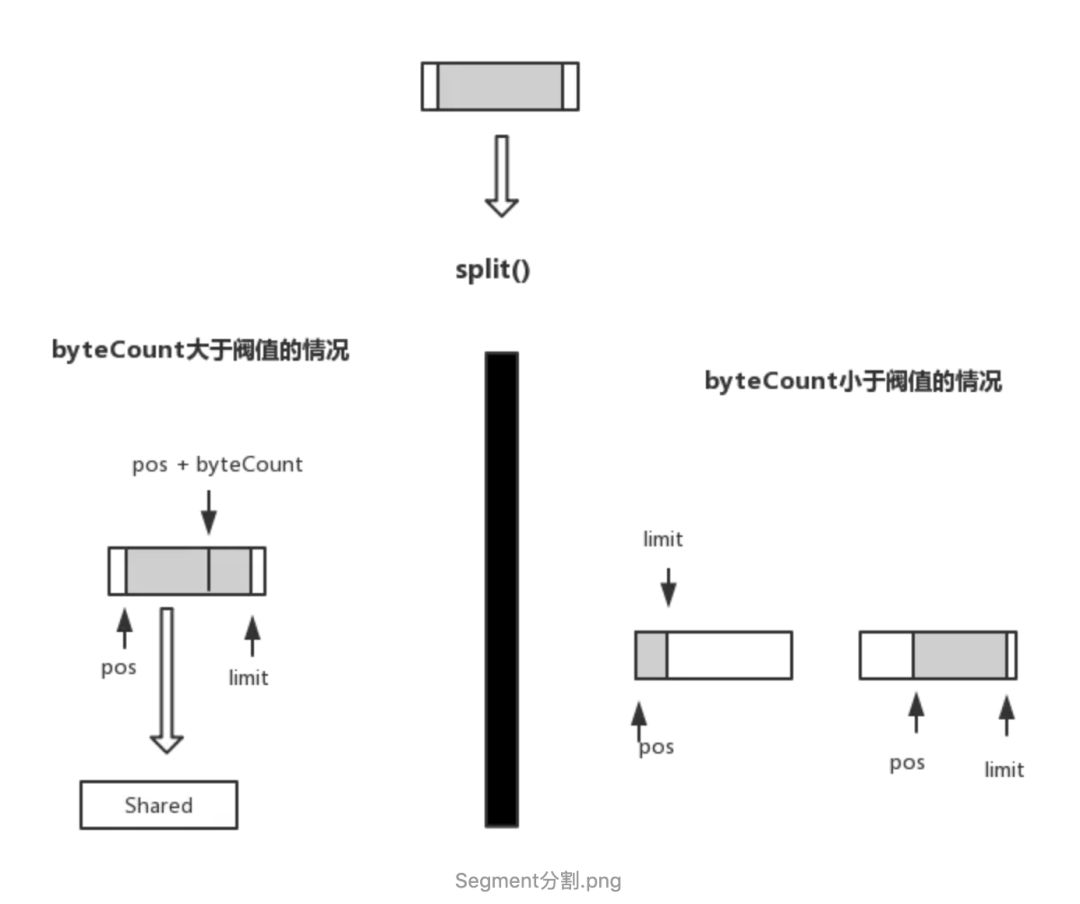
分割操作视byteCount大小,有不同选择。byteCount大于阀值时,新建Segment,并与当前的Segment共享byte[]数据,其中,当前Segment的的索引范围为[pos + byteCount] ~ [limit],新的Segmetn索引范围为[pos] ~ [pos + byteCount] ; byteCount小于阀值时,则通过copy操作,将所需数据搬运到新的Segment。
/ Segment缓存池 /
slipt()操作中可以看到缓存池SegmentPool的身影。与大多数缓存池一样,SegmentPool避免的内存的重新分配。SegmentPool存储的大小为 64 * 1024, Semgent数据存储大小为 8192,因此最多存下8个Segment。
SegmentPool复用IO操作中分配到的内存,也是得益于Segment的设计,当涉及到多流操作时,效果明显。
取操作为 take(),回收操作为 recycle() ,存储方式为单向链表,这里不多说。
/ Okio中的角色 /
说了那么多,在看看看Okio中涉及的到角色
Source和Sink
对应IO中的输入流和输出流,Source的实现类实现需read(Buffer sink, long byteCount) throws IOException; Sink的实现类实现write(Buffer source, long byteCount)。不难猜测,在Okio中以Buffer作为操作媒介,可以发挥它的最大优势。
BufferedSource 和 BufferedSink
对应IO中输入流缓冲和输出流缓冲,提供对外的API进行读写操作。
Okio
入口类,工厂类,提供source方法可以得到一个Source输入流,提供sink方法得到一个Sink输出流。两种方法可接受的入参都可为 File、Socket、InputStream / OutputStream。对每个对应的方法进行查看,Okio并没有改变各种Java 输入输出流的对应装饰对象的构造,在构造上,对于涉及到的上面说到的入参,构造起来比较方便。也能看出,Okio并没有打算改变底层的IO方式,旨在弥补原声IO框架上的不足。
Segment
这一部分开篇已现对Segment进行了介绍。除了介绍都的内容外,Segment可以以单链、双链的方式存储。提供了pop()将自己从链中删除,返回下一节点;push()将一个Segment加在自己后面,这两个对于链表的操作不做深入。既然提供了split()方法进行分割,自然也提供了compact()方法Segment进行合并,前提是用来做合并的Segment的剩余容量装得下,也不做深入。
SegmentPoll
复用Segment,前面说过,不赘述。RealBufferedSource,RealBufferdSink为BufferedSource 和 BufferedSink的实现类。
Buffer
Okio使用了Segment作为数据存储的方式,自然要提供对应的缓冲方式来操作Segment,Segment在Buffer中以双向链表形式存在。Buffer则负责此项事务。Buffer也实现了BufferedSource和BufferedSink,这是因在使用Okio提供的输入/输出缓冲时,都需要进行缓冲处理,均由Buffer来处理,这样使API对应。


 苏公安网备 32011402010933号