















这是 Java 爬虫系列博文的第三篇,在上一篇 Java 爬虫遇到需要登录的网站,该怎么办? 中,我们简单的讲解了爬虫时遇到登录问题的解决办法,在这篇文章中我们一起来聊一聊爬虫时遇到数据异步加载的问题,这也是爬虫中常见的问题。
现在很多都是前后端分离项目,这会使得数据异步加载问题更加突出,所以你在爬虫时遇到这类问题不必惊讶,不必慌张。对于这类问题的解决办法总体来说有以下两种:
1、内置一个浏览器内核
内置浏览器就是在抓取的程序中,启动一个浏览器内核,使我们获取到 js 渲染后的页面,这样我们就跟采集静态页面一样了。这种工具常用的有以下三种:
- Selenium
- HtmlUnit
- PhantomJs
这些工具都能帮助我们解决数据异步加载的问题,但是他们都存在缺陷,那就是效率不高而且不稳定。
2、反向解析法
什么是反向解析法呢?我们 js 渲染页面的数据是通过 Ajax 的方式从后端获取的,我们只需要找到对应的 Ajax 请求连接就 OK,这样我们就获取到了我们需要的数据,反向解析法的好处就是这种方式获取的数据都是 json 格式的数据,解析起来也比较方便,另一个好处就是相对页面来说,接口的变化概率更小。同样它有两个不足之处,一个是在 Ajax 时你需要有耐心有技巧,因为你需要在一大推请求中找到你想要的,另一个不足的地方就是对 JavaScript 渲染的页面束手无策。
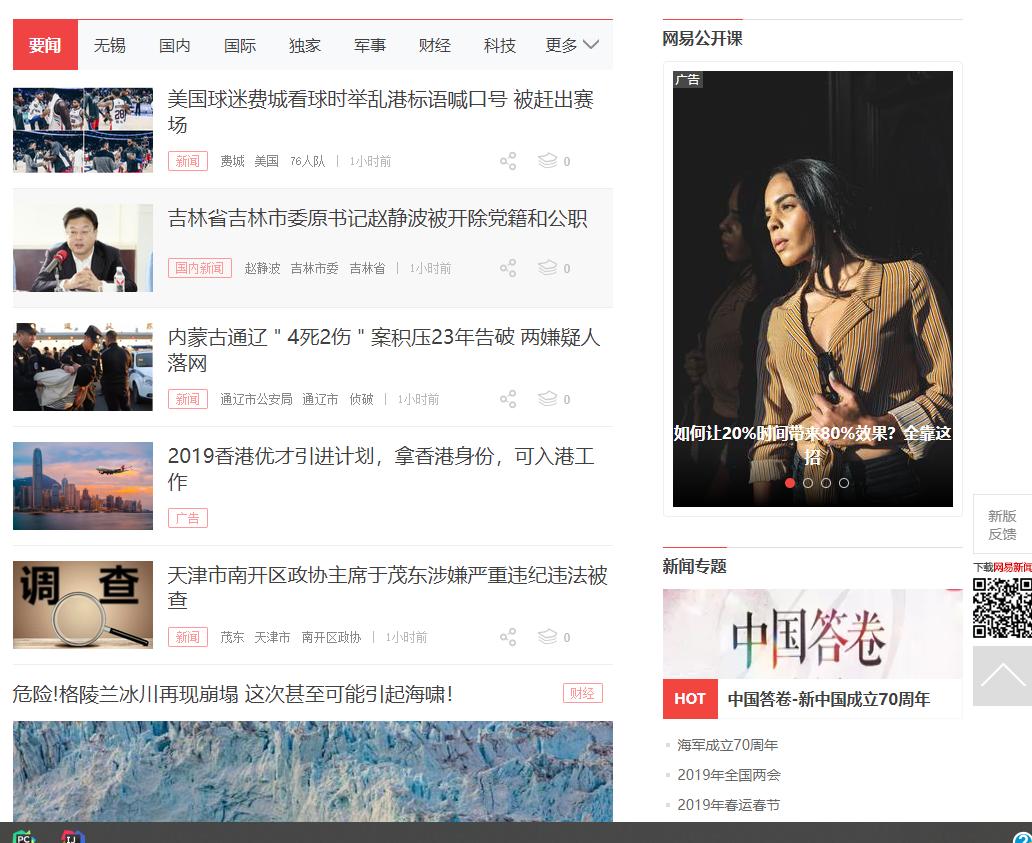
上面就是异步数据加载的两种解决办法,为了加深大家的理解和在项目中如何使用,我以采集网易要闻为例,网易新闻地址:https://news.163.com/ 。利用上诉的两种方式来获取网易要闻的新闻列表。网易要闻如下:
内置浏览器 Selenium 方式
Selenium 是一个模拟浏览器,进行自动化测试的工具,它提供一组 API 可以与真实的浏览器内核交互。在自动化测试上使用的比较多,爬虫时解决异步加载也经常使用它,我们要在项目中使用 Selenium ,需要做两件事:
- 1、引入 Selenium 的依赖包,在 pom.xml 中添加
- 1
- 2
- 3
- 4
- 5
- 6
- 2、下载对应的 driver,例如我下载的 chromedriver,下载地址为:
https://npm.taobao.org/mirrors/chromedriver/,下载后,需要将 driver 的位置写到 Java 的环境变量里,例如我直接放在项目下,所以我的代码为:
System.getProperties().setProperty('webdriver.chrome.driver', 'chromedriver.exe');- 1
完成上面两步之后,我们就可以来编写使用 Selenium 采集网易要闻啦。具体代码如下:
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
- 12
- 13
- 14
- 15
- 16
- 17
- 18
- 19
- 20
- 21
- 22
- 23
- 24
- 25
- 26
- 27
- 28
运行该方法,得到结果如下:
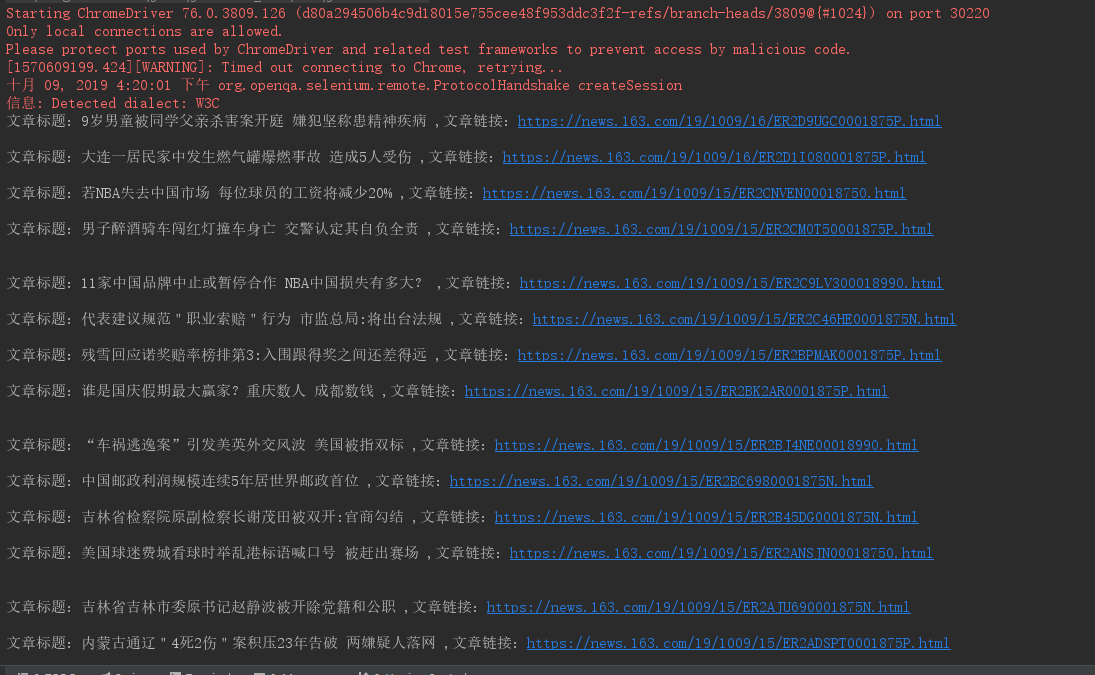
我们使用 Selenium 已经正确的提取到了网易要闻的列表新闻。
反向解析法
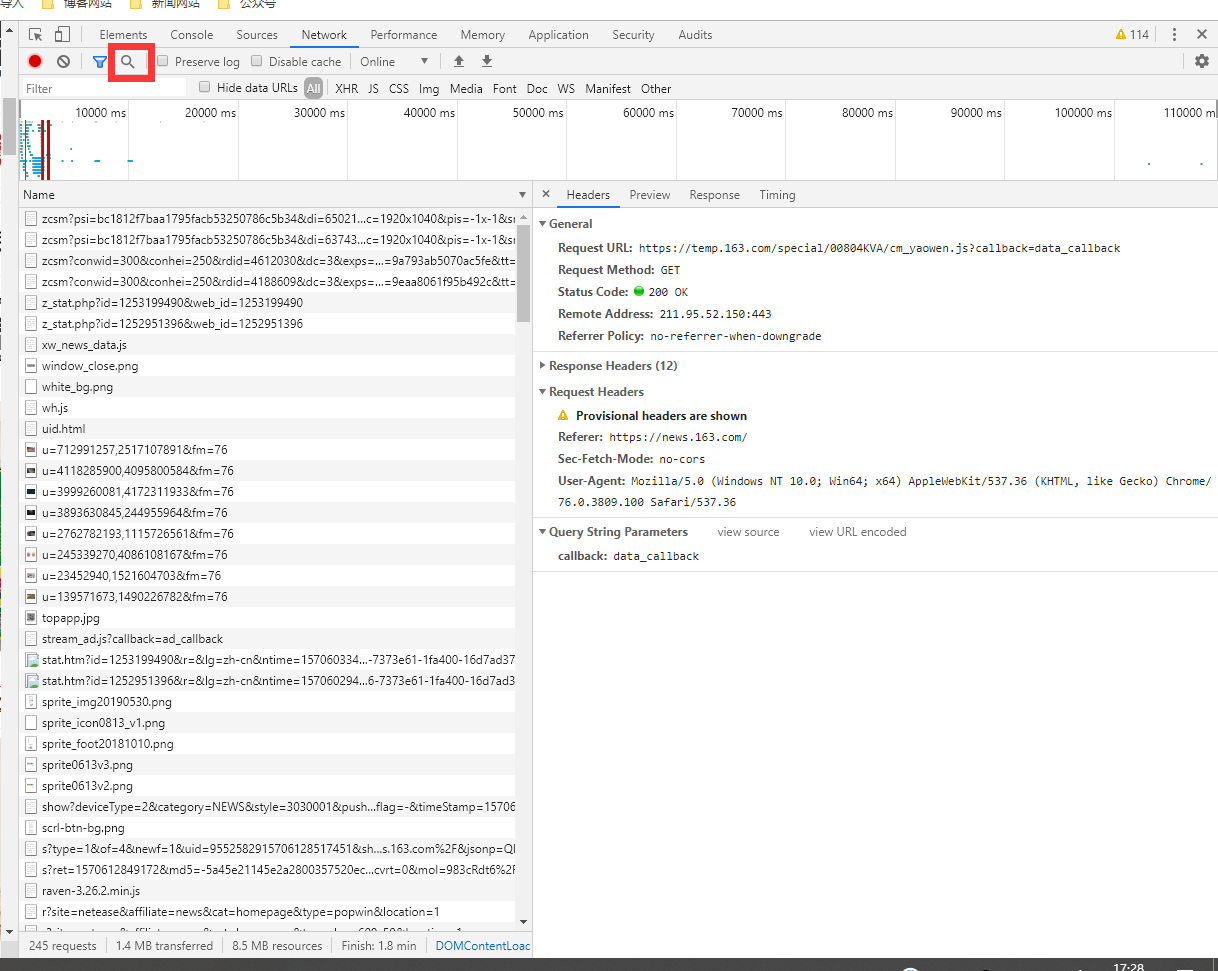
反向解析法就是获取到 Ajax 异步获取数据的链接,直接获取到新闻数据。如果没有技巧的话,查找 Ajax 的过程将非常痛苦,因为一个页面加载的链接太多了,看看网易要闻的 network:


 苏公安网备 32011402010933号