















有几百条的请求,该如何查找到是哪条请求获取的要闻数据呢?你不嫌麻烦的话,可以一个一个的去点,肯定能够查找到的,另一种快捷的办法是利用 network 的搜索功能,如果你不知道搜索按钮,我在上图已经圈出来啦,我们在要闻中随便复制一个新闻标题,然后检索一下,就可以获取到结果,如下图所示:
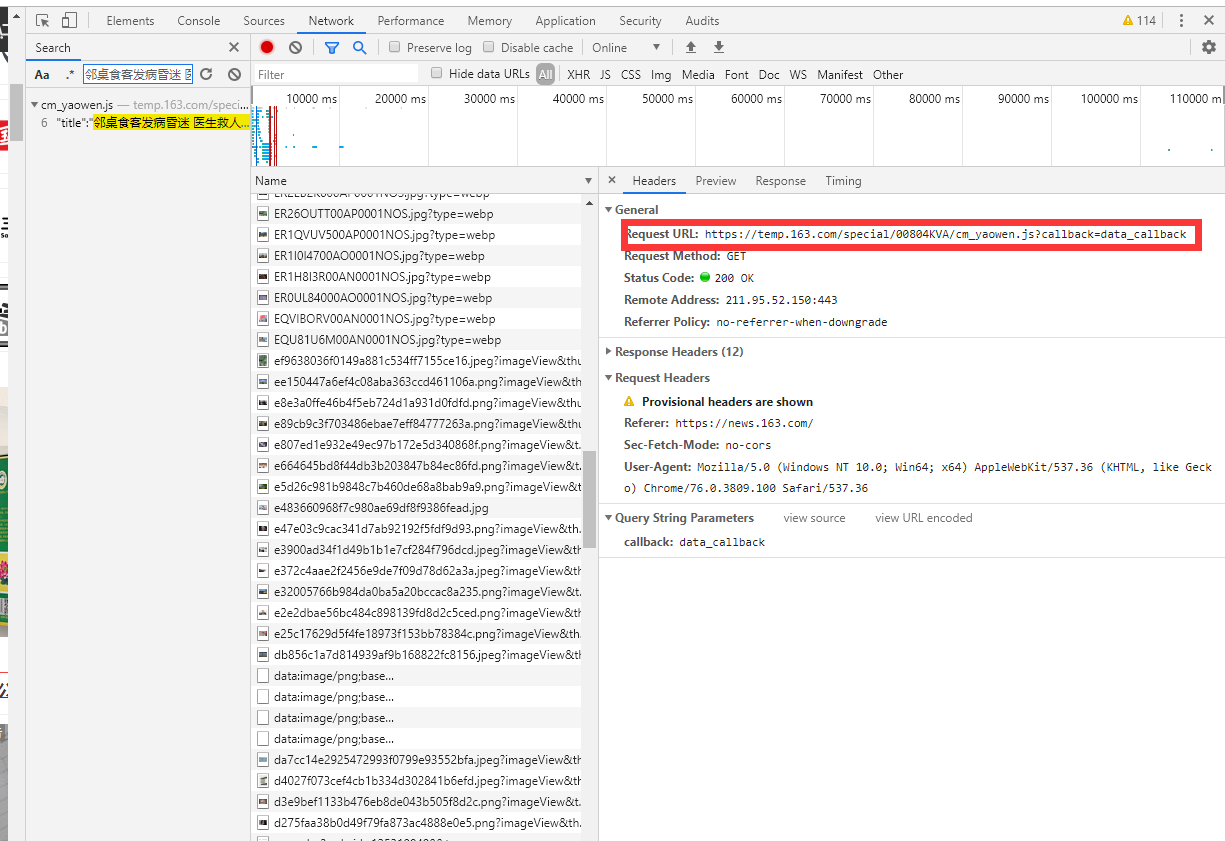
这样我们就快速的获取到了要闻数据的请求链接,链接为:https://temp.163.com/special/00804KVA/cm_yaowen.js?callback=data_callback,访问该链接,查看该链接返回的数据,如下图所示:
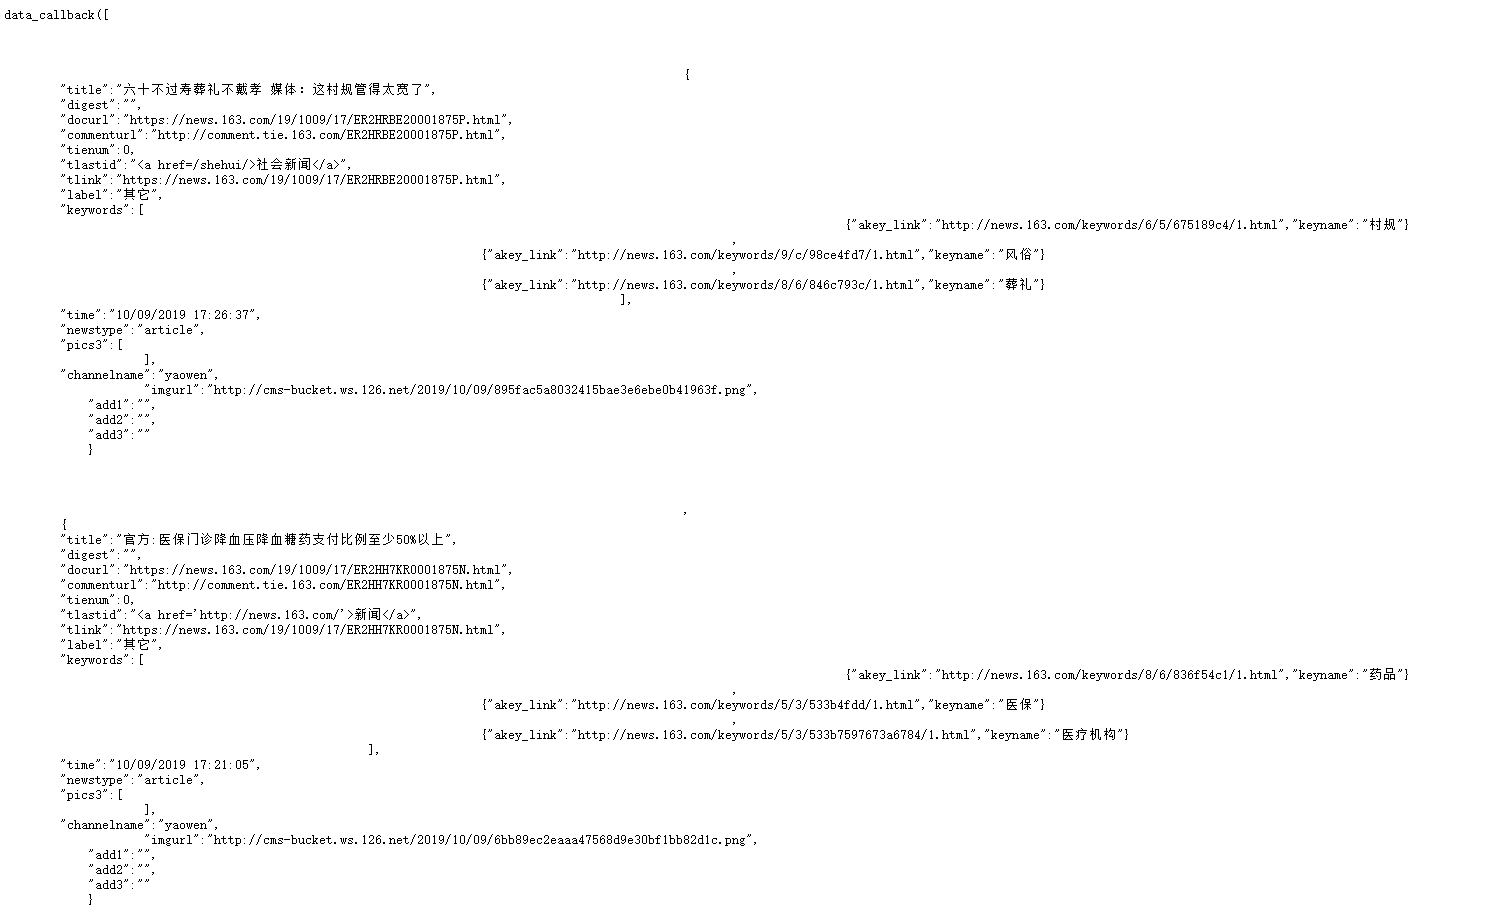
从数据我们可以看出,我们需要的数据都在这里啦,所以我们只需要解析这段数据接可以啦,要从这段数据中解析出新闻标题和新闻链接,有两种方式,一种是正则表达式,另一种是将该数据转成 json 或者 list。这里我选择第二种方式,利用 fastjson 将返回的数据转换成 JSONArray 。所以我们是要引入 fastjson ,在 pom.xml 中引入 fastjson 依赖:
- 1
- 2
- 3
- 4
- 5
除了引入 fastjson 依赖外,我们在转换前还需要对数据进行简单的处理,因为现在的数据并不符合 list 的格式,我们需要去掉 data_callback( 和最后面的 )。具体反向解析获取网易要闻的代码如下:
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
- 12
- 13
- 14
- 15
- 16
- 17
- 18
- 19
- 20
- 21
- 22
- 23
- 24
- 25
- 26
- 27
- 28
编写 main 方法,执行上面的方法,需要注意的地方是:这时候传入的链接为https://temp.163.com/special/00804KVA/cm_yaowen.js?callback=data_callback 而不是 https://news.163.com/。得到如下结果: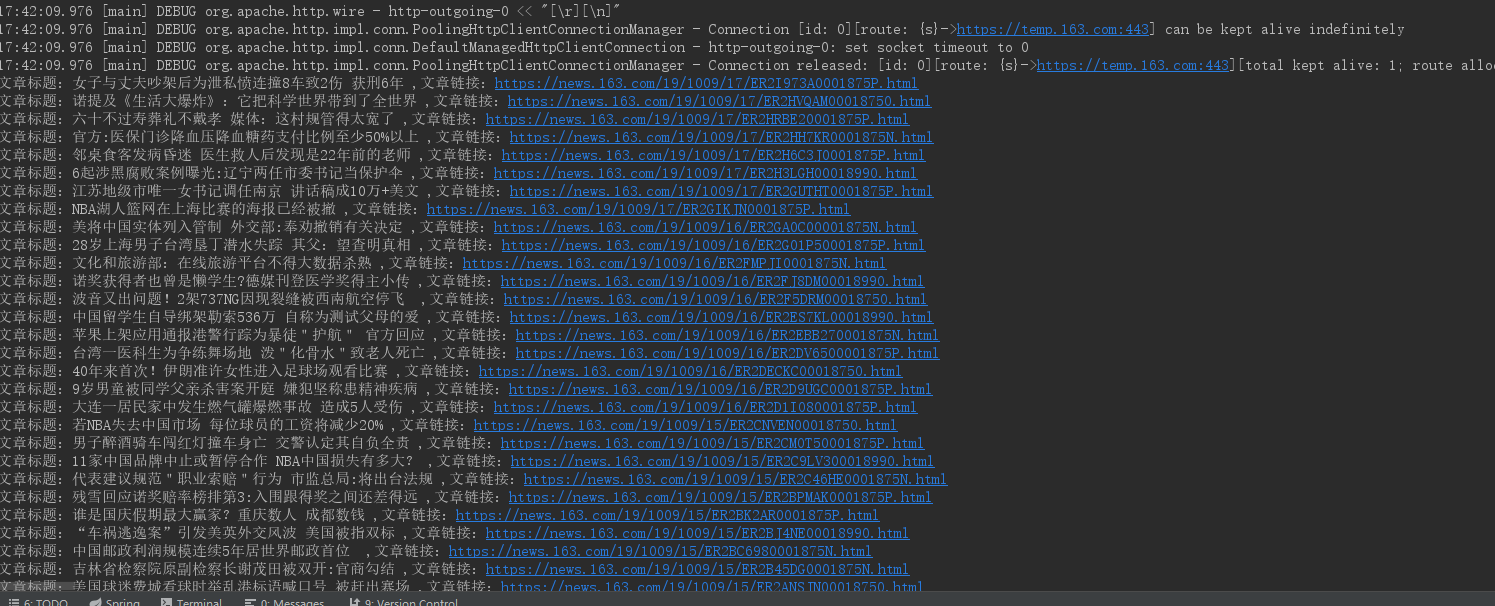
两种方法都成功的获取到了网易要闻异步加载的新闻列表,对于这两种方法的选取,我个人的倾向是使用反向解析法,因为它的性能和稳定是都要比内置浏览器内核靠谱,但是对于一些使用 JavaScript 片段渲染的页面,内置浏览器又更加靠谱。所以根据具体情况选择吧。
希望这篇文章对你有所帮助,下一篇是关于 爬虫IP 被封的问题。如果你对爬虫感兴趣,不妨关注一波,相互学习,相互进步
源代码:源代码
文章不足之处,望大家多多指点,共同学习,共同进步


 苏公安网备 32011402010933号