















你知道的越多,你不知道的越多
点赞再看,养成习惯
GitHub上已经开源https://github.com/Java…,有面试点思维导图,欢迎Star和完善
前言
Redis在互联网技术存储方面使用如此广泛,几乎所有的后端技术面试官都要在Redis的使用和原理方面对小伙伴们进行360°的刁难。
作为一个在互联网公司面一次拿一次Offer的面霸,打败了无数竞争对手,每次都只能看到无数落寞的身影失望的离开,略感愧疚(请允许我使用一下夸张的修辞手法)。
于是在一个寂寞难耐的夜晚,我痛定思痛,决定开始写《吊打面试官》系列,希望能帮助各位读者以后面试势如破竹,对面试官进行360°的反击,吊打问你的面试官,让一同面试的同僚瞠目结舌,疯狂收割大厂Offer!
絮叨
上一期因为是在双十一一直在熬夜的大环境下完成的,所以我自己觉得质量明显没之前的好,我这不一睡好就加班加点准备补偿大家,来点干货。(熬夜太容易感冒了,这次点个赞别白嫖了!)
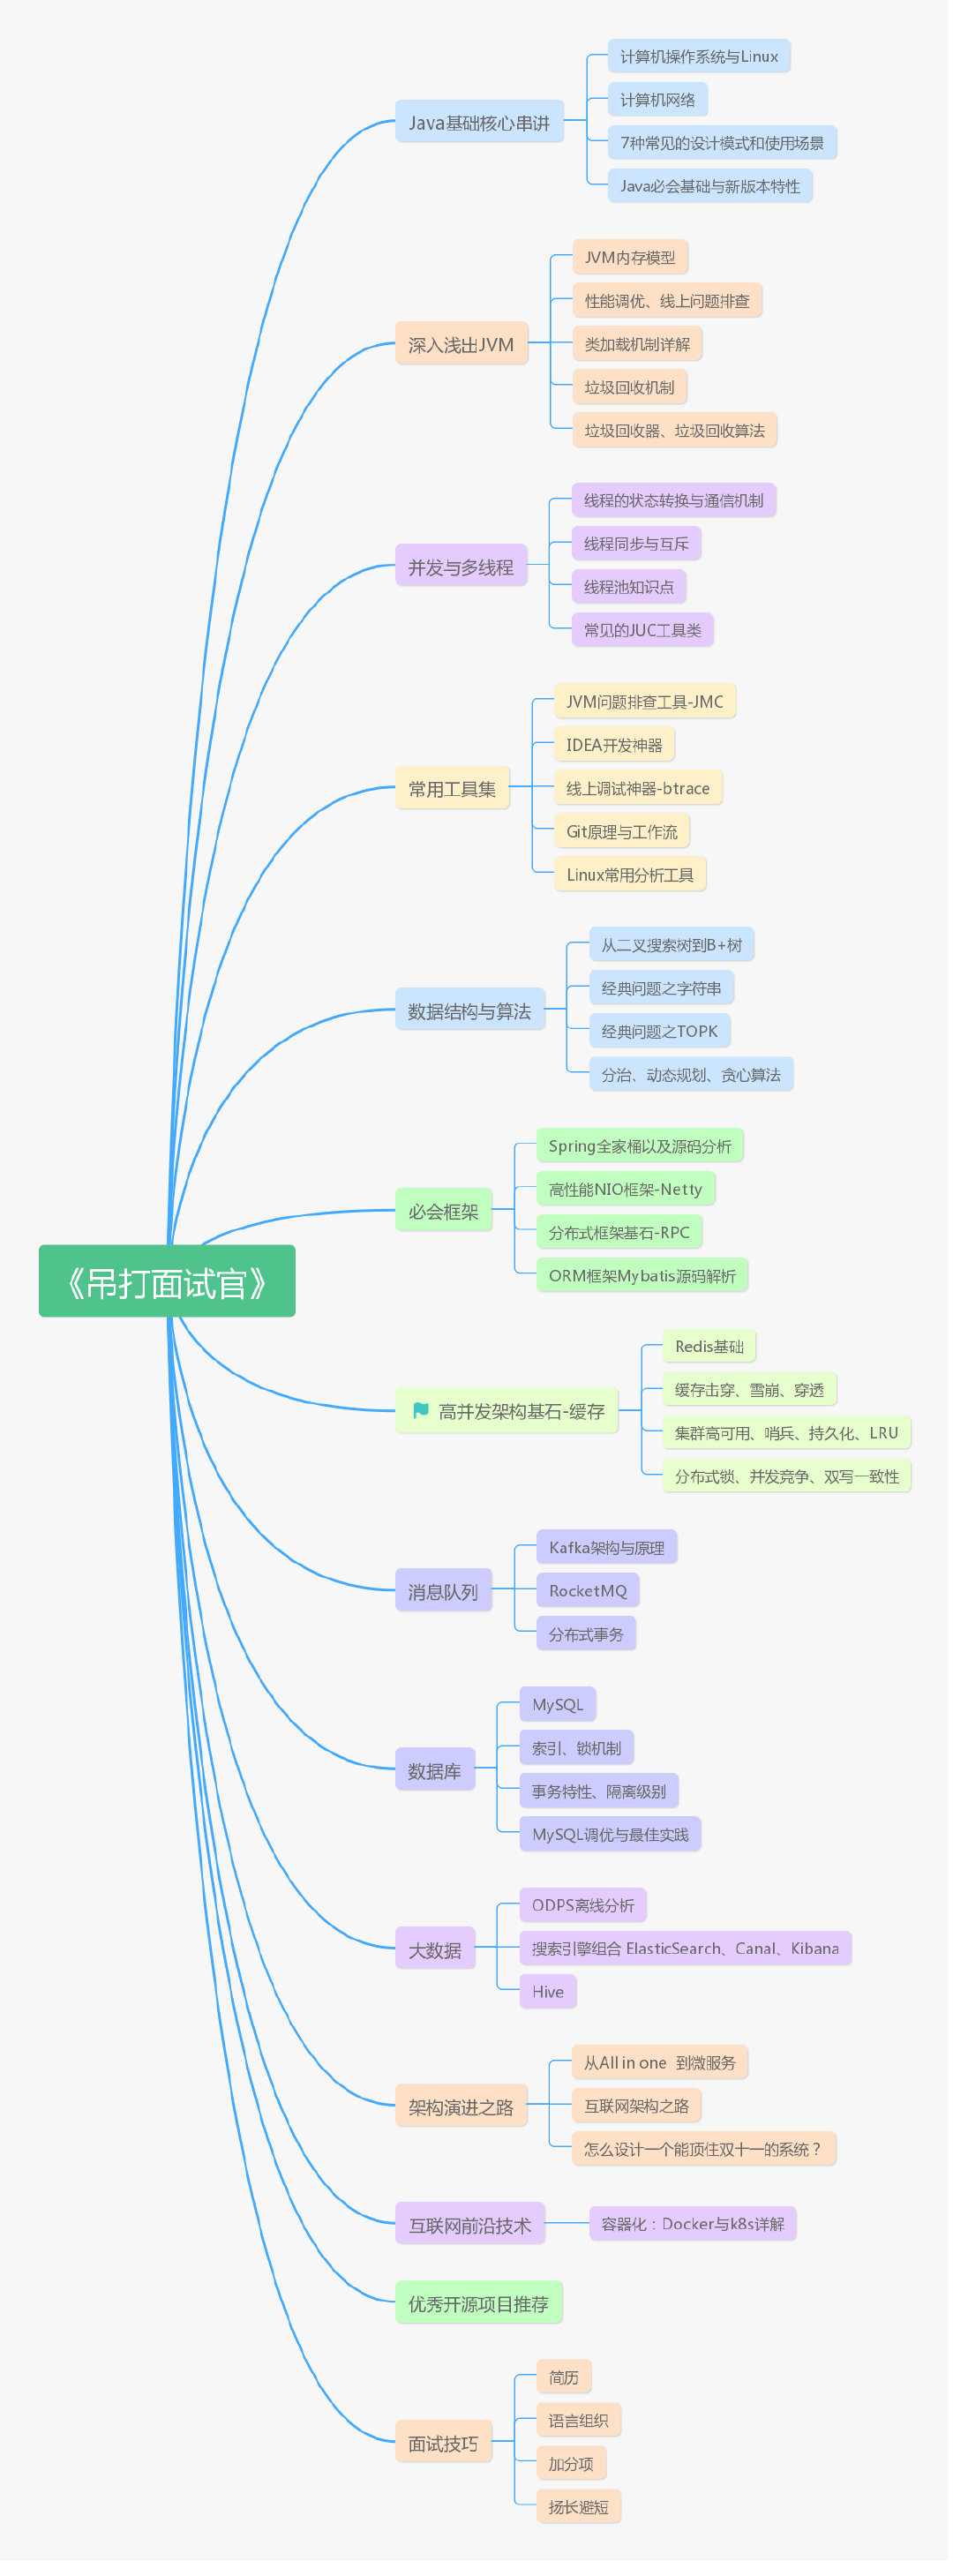
顺带提一嘴,我把我准备写啥画了一个思维导图,以后总不能每篇都放个贼大的图吧,就开源到了我的GitHub,大家有兴趣可以去完善和Star。
这篇我就先放出来大家看看,感觉还是差点意思,等大家完善了。
回望过去
上一期吊打系列我们提到了Redis相关的一些知识,还没看的小伙伴可以回顾一下
《吊打面试官》系列-Redis基础
《吊打面试官》系列-缓存雪崩、击穿、穿透
《吊打面试官》系列-Redis哨兵、持久化、主从、手撕LRU
《吊打面试官》系列-Redis终章-凛冬将至、FPX-新王登基
这期我就从缓存到一些常见的问题讲一下,有一些我是之前提到过的,不过可能大部分仔是第一次看,我就重复发一下。
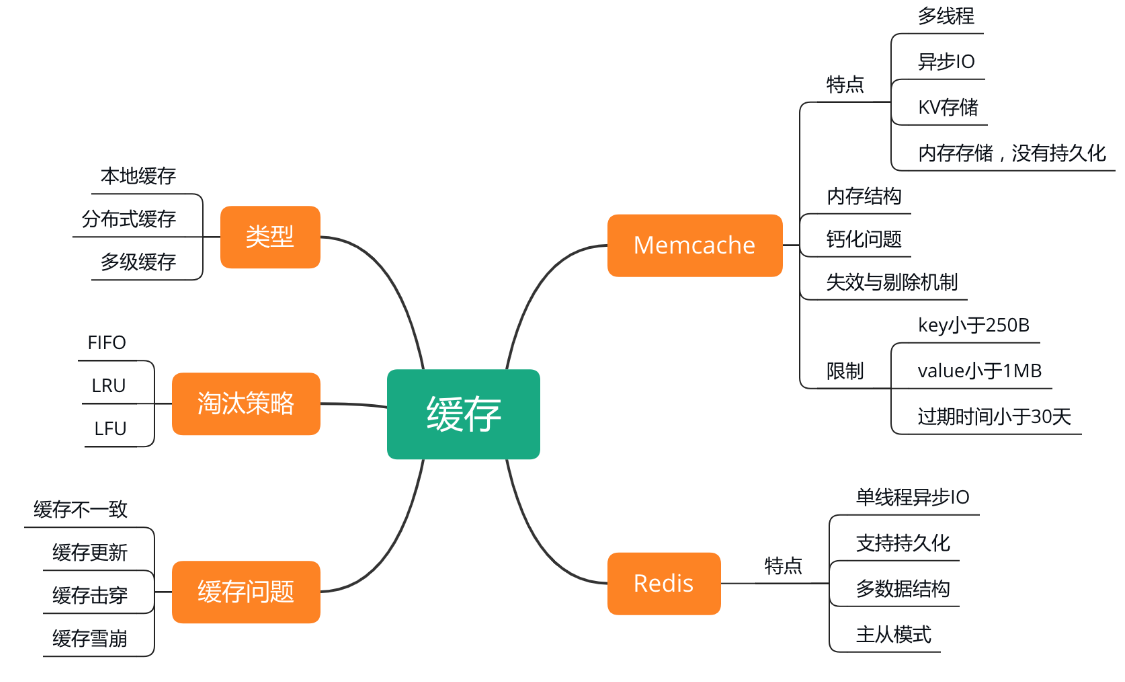
缓存知识点
缓存有哪些类型?
缓存是高并发场景下提高热点数据访问性能的一个有效手段,在开发项目时会经常使用到。
缓存的类型分为:本地缓存、分布式缓存和多级缓存。
本地缓存:
本地缓存就是在进程的内存中进行缓存,比如我们的 JVM 堆中,可以用 LRUMap 来实现,也可以使用 Ehcache 这样的工具来实现。
本地缓存是内存访问,没有远程交互开销,性能最好,但是受限于单机容量,一般缓存较小且无法扩展。
分布式缓存:
分布式缓存可以很好得解决这个问题。
分布式缓存一般都具有良好的水平扩展能力,对较大数据量的场景也能应付自如。缺点就是需要进行远程请求,性能不如本地缓存。
多级缓存:
为了平衡这种情况,实际业务中一般采用多级缓存,本地缓存只保存访问频率最高的部分热点数据,其他的热点数据放在分布式缓存中。
在目前的一线大厂中,这也是最常用的缓存方案,单考单一的缓存方案往往难以撑住很多高并发的场景。
淘汰策略
不管是本地缓存还是分布式缓存,为了保证较高性能,都是使用内存来保存数据,由于成本和内存限制,当存储的数据超过缓存容量时,需要对缓存的数据进行剔除。
一般的剔除策略有 FIFO 淘汰最早数据、LRU 剔除最近最少使用、和 LFU 剔除最近使用频率最低的数据几种策略。
noeviction:返回错误当内存限制达到并且客户端尝试执行会让更多内存被使用的命令(大部分的写入指令,但DEL和几个例外)
allkeys-lru: 尝试回收最少使用的键(LRU),使得新添加的数据有空间存放。
volatile-lru: 尝试回收最少使用的键(LRU),但仅限于在过期集合的键,使得新添加的数据有空间存放。
allkeys-random: 回收随机的键使得新添加的数据有空间存放。
volatile-random: 回收随机的键使得新添加的数据有空间存放,但仅限于在过期集合的键。
volatile-ttl: 回收在过期集合的键,并且优先回收存活时间(TTL)较短的键,使得新添加的数据有空间存放。
如果没有键满足回收的前提条件的话,策略volatile-lru, volatile-random以及volatile-ttl就和noeviction 差不多了。
其实在大家熟悉的LinkedHashMap中也实现了Lru算法的,实现如下:
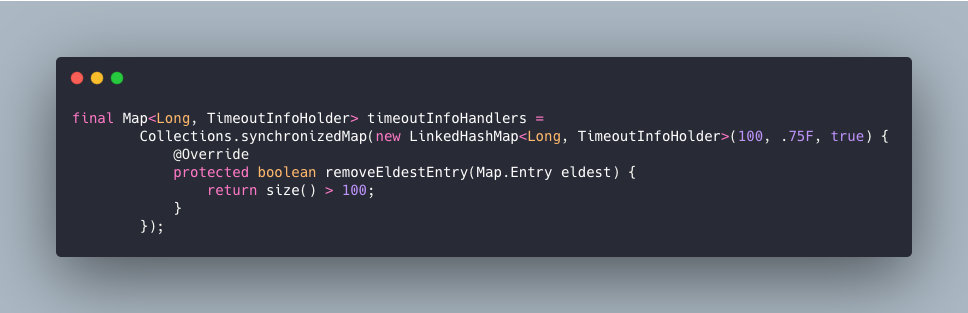
当容量超过100时,开始执行LRU策略:将最近最少未使用的 TimeoutInfoHolder 对象 evict 掉。
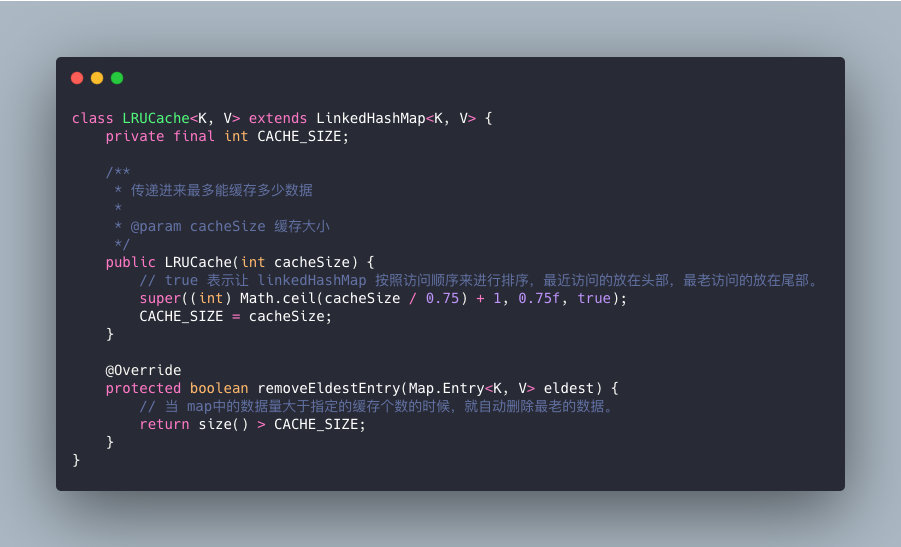
真实面试中会让你写LUR算法,你可别搞原始的那个,那真TM多,写不完的,你要么怼上面这个,要么怼下面这个,找一个数据结构实现下Java版本的LRU还是比较容易的,知道啥原理就好了。
Memcache
注意后面会把 Memcache 简称为 MC。
先来看看 MC 的特点:
MC 处理请求时使用多线程异步 IO 的方式,可以合理利用 CPU 多核的优势,性能非常优秀;
MC 功能简单,使用内存存储数据;
MC 的内存结构以及钙化问题我就不细说了,大家可以查看官网了解下;
MC 对缓存的数据可以设置失效期,过期后的数据会被清除;
失效的策略采用延迟失效,就是当再次使用数据时检查是否失效;
当容量存满时,会对缓存中的数据进行剔除,剔除时除了会对过期 key 进行清理,还会按 LRU 策略对数据进行剔除。
另外,使用 MC 有一些限制,这些限制在现在的互联网场景下很致命,成为大家选择Redis、MongoDB的重要原因:
key 不能超过 250 个字节;
value 不能超过 1M 字节;
key 的最大失效时间是 30 天;
只支持 K-V 结构,不提供持久化和主从同步功能。
Redis
先简单说一下 Redis 的特点,方便和 MC 比较。
与 MC 不同的是,Redis 采用单线程模式处理请求。这样做的原因有 2 个:一个是因为采用了非阻塞的异步事件处理机制;另一个是缓存数据都是内存操作 IO 时间不会太长,单线程可以避免线程上下文切换产生的代价。
Redis 支持持久化,所以 Redis 不仅仅可以用作缓存,也可以用作 NoSQL 数据库。
相比 MC,Redis 还有一个非常大的优势,就是除了 K-V 之外,还支持多种数据格式,例如 list、set、sorted set、hash 等。
Redis 提供主从同步机制,以及 Cluster 集群部署能力,能够提供高可用服务。
详解 Redis
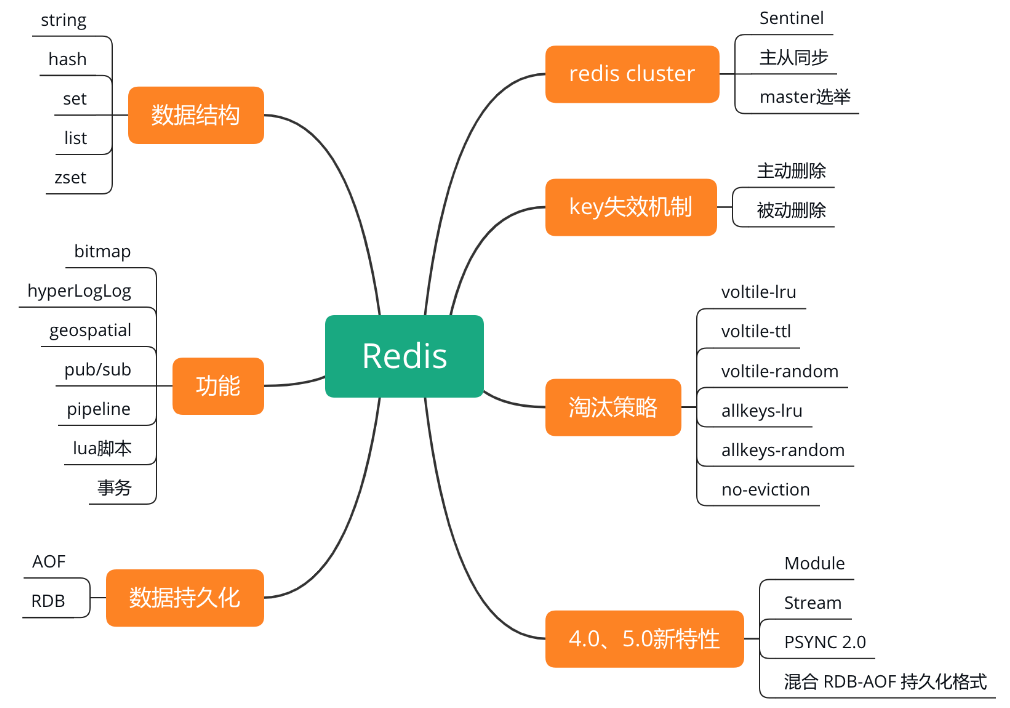
Redis 的知识点结构如下图所示。
功能
来看 Redis 提供的功能有哪些吧!
我们先看基础类型:
String:
String 类型是 Redis 中最常使用的类型,内部的实现是通过 SDS(Simple Dynamic String )来存储的。SDS 类似于 Java中的 ArrayList,可以通过预分配冗余空间的方式来减少内存的频繁分配。
这是最简单的类型,就是普通的 set 和 get,做简单的 KV 缓存。
但是真实的开发环境中,很多仔可能会把很多比较复杂的结构也统一转成String去存储使用,比如有的仔他就喜欢把对象或者List转换为JSONString进行存储,拿出来再反序列话啥的。
我在这里就不讨论这样做的对错了,但是我还是希望大家能在最合适的场景使用最合适的数据结构,对象找不到最合适的但是类型可以选最合适的嘛,之后别人接手你的代码一看这么规范,诶这小伙子有点东西呀,看到你啥都是用的String,垃圾!
好了这些都是题外话了,道理还是希望大家记在心里,习惯成自然嘛,小习惯成就你。
String的实际应用场景比较广泛的有:
缓存功能:String字符串是最常用的数据类型,不仅仅是Redis,各个语言都是最基本类型,因此,利用Redis作为缓存,配合其它数据库作为存储层,利用Redis支持高并发的特点,可以大大加快系统的读写速度、以及降低后端数据库的压力。
计数器:许多系统都会使用Redis作为系统的实时计数器,可以快速实现计数和查询的功能。而且最终的数据结果可以按照特定的时间落地到数据库或者其它存储介质当中进行永久保存。
共享用户Session:用户重新刷新一次界面,可能需要访问一下数据进行重新登录,或者访问页面缓存Cookie,但是可以利用Redis将用户的Session集中管理,在这种模式只需要保证Redis的高可用,每次用户Session的更新和获取都可以快速完成。大大提高效率。
Hash:
这个是类似 Map 的一种结构,这个一般就是可以将结构化的数据,比如一个对象(前提是这个对象没嵌套其他的对象)给缓存在 Redis 里,然后每次读写缓存的时候,可以就操作 Hash 里的某个字段。
但是这个的场景其实还是多少单一了一些,因为现在很多对象都是比较复杂的,比如你的商品对象可能里面就包含了很多属性,其中也有对象。我自己使用的场景用得不是那么多。
List:
List 是有序列表,这个还是可以玩儿出很多花样的。
比如可以通过 List 存储一些列表型的数据结构,类似粉丝列表、文章的评论列表之类的东西。
比如可以通过 lrange 命令,读取某个闭区间内的元素,可以基于 List 实现分页查询,这个是很棒的一个功能,基于 Redis 实现简单的高性能分页,可以做类似微博那种下拉不断分页的东西,性能高,就一页一页走。
比如可以搞个简单的消息队列,从 List 头怼进去,从 List 屁股那里弄出来。
List本身就是我们在开发过程中比较常用的数据结构了,热点数据更不用说了。
消息队列:Redis的链表结构,可以轻松实现阻塞队列,可以使用左进右出的命令组成来完成队列的设计。比如:数据的生产者可以通过Lpush命令从左边插入数据,多个数据消费者,可以使用BRpop命令阻塞的“抢”列表尾部的数据。
文章列表或者数据分页展示的应用。
比如,我们常用的博客网站的文章列表,当用户量越来越多时,而且每一个用户都有自己的文章列表,而且当文章多时,都需要分页展示,这时可以考虑使用Redis的列表,列表不但有序同时还支持按照范围内获取元素,可以完美解决分页查询功能。大大提高查询效率。
Set:
Set 是无序集合,会自动去重的那种。
直接基于 Set 将系统里需要去重的数据扔进去,自动就给去重了,如果你需要对一些数据进行快速的全局去重,你当然也可以基于 JVM 内存里的 HashSet 进行去重,但是如果你的某个系统部署在多台机器上呢?得基于Redis进行全局的 Set 去重。
可以基于 Set 玩儿交集、并集、差集的操作,比如交集吧,我们可以把两个人的好友列表整一个交集,看看俩人的共同好友是谁?对吧。
反正这些场景比较多,因为对比很快,操作也简单,两个查询一个Set搞定。
Sorted Set:
Sorted set 是排序的 Set,去重但可以排序,写进去的时候给一个分数,自动根据分数排序。
有序集合的使用场景与集合类似,但是set集合不是自动有序的,而Sorted set可以利用分数进行成员间的排序,而且是插入时就排序好。所以当你需要一个有序且不重复的集合列表时,就可以选择Sorted set数据结构作为选择方案。
排行榜:有序集合经典使用场景。例如视频网站需要对用户上传的视频做排行榜,榜单维护可能是多方面:按照时间、按照播放量、按照获得的赞数等。
用Sorted Sets来做带权重的队列,比如普通消息的score为1,重要消息的score为2,然后工作线程可以选择按score的倒序来获取工作任务。让重要的任务优先执行。
微博热搜榜,就是有个后面的热度值,前面就是名称
高级用法:
Bitmap :
位图是支持按 bit 位来存储信息,可以用来实现 布隆过滤器(BloomFilter);
HyperLogLog:
供不精确的去重计数功能,比较适合用来做大规模数据的去重统计,例如统计 UV;
Geospatial:
可以用来保存地理位置,并作位置距离计算或者根据半径计算位置等。有没有想过用Redis来实现附近的人?或者计算最优地图路径?
这三个其实也可以算作一种数据结构,不知道还有多少朋友记得,我在梦开始的地方,Redis基础中提到过,你如果只知道五种基础类型那只能拿60分,如果你能讲出高级用法,那就觉得你有点东西。
pub/sub:
功能是订阅发布功能,可以用作简单的消息队列。
Pipeline:
可以批量执行一组指令,一次性返回全部结果,可以减少频繁的请求应答。
Lua:
Redis 支持提交 Lua 脚本来执行一系列的功能。
我在前电商老东家的时候,秒杀场景经常使用这个东西,讲道理有点香,利用他的原子性。
话说你们想看秒杀的设计么?我记得我面试好像每次都问啊,想看的直接点赞后评论秒杀吧。
事务:
最后一个功能是事务,但 Redis 提供的不是严格的事务,Redis 只保证串行执行命令,并且能保证全部执行,但是执行命令失败时并不会回滚,而是会继续执行下去。
持久化
Redis 提供了 RDB 和 AOF 两种持久化方式,RDB 是把内存中的数据集以快照形式写入磁盘,实际操作是通过 fork 子进程执行,采用二进制压缩存储;AOF 是以文本日志的形式记录 Redis 处理的每一个写入或删除操作。
RDB 把整个 Redis 的数据保存在单一文件中,比较适合用来做灾备,但缺点是快照保存完成之前如果宕机,这段时间的数据将会丢失,另外保存快照时可能导致服务短时间不可用。
AOF 对日志文件的写入操作使用的追加模式,有灵活的同步策略,支持每秒同步、每次修改同步和不同步,缺点就是相同规模的数据集,AOF 要大于 RDB,AOF 在运行效率上往往会慢于 RDB。
细节的点大家去高可用这章看,特别是两者的优缺点,以及怎么抉择。
敖丙 | 文 【原创】【转载请联系本人】


 苏公安网备 32011402010933号