















《吊打面试官》系列-Redis哨兵、持久化、主从、手撕LRU
高可用
来看 Redis 的高可用。Redis 支持主从同步,提供 Cluster 集群部署模式,通过 Sentine l哨兵来监控 Redis 主服务器的状态。当主挂掉时,在从节点中根据一定策略选出新主,并调整其他从 slaveof 到新主。
选主的策略简单来说有三个:
slave 的 priority 设置的越低,优先级越高;
同等情况下,slave 复制的数据越多优先级越高;
相同的条件下 runid 越小越容易被选中。
在 Redis 集群中,sentinel 也会进行多实例部署,sentinel 之间通过 Raft 协议来保证自身的高可用。
Redis Cluster 使用分片机制,在内部分为 16384 个 slot 插槽,分布在所有 master 节点上,每个 master 节点负责一部分 slot。数据操作时按 key 做 CRC16 来计算在哪个 slot,由哪个 master 进行处理。数据的冗余是通过 slave 节点来保障。
哨兵
哨兵必须用三个实例去保证自己的健壮性的,哨兵+主从并不能保证数据不丢失,但是可以保证集群的高可用。
为啥必须要三个实例呢?我们先看看两个哨兵会咋样。
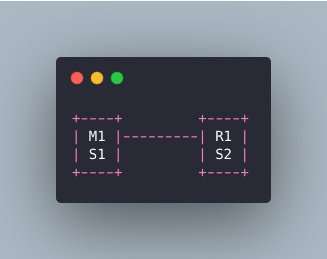
master宕机了 s1和s2两个哨兵只要有一个认为你宕机了就切换了,并且会选举出一个哨兵去执行故障,但是这个时候也需要大多数哨兵都是运行的。
那这样有啥问题呢?M1宕机了,S1没挂那其实是OK的,但是整个机器都挂了呢?哨兵就只剩下S2个裸屌了,没有哨兵去允许故障转移了,虽然另外一个机器上还有R1,但是故障转移就是不执行。
经典的哨兵集群是这样的:
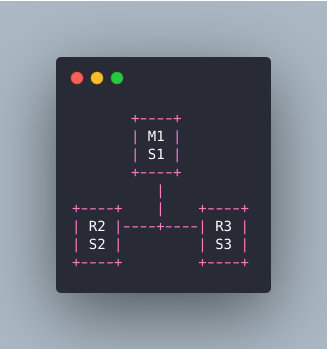
M1所在的机器挂了,哨兵还有两个,两个人一看他不是挂了嘛,那我们就选举一个出来执行故障转移不就好了。
暖男我,小的总结下哨兵组件的主要功能:
集群监控:负责监控 Redis master 和 slave 进程是否正常工作。
消息通知:如果某个 Redis 实例有故障,那么哨兵负责发送消息作为报警通知给管理员。
故障转移:如果 master node 挂掉了,会自动转移到 slave node 上。
配置中心:如果故障转移发生了,通知 client 客户端新的 master 地址。
主从
提到这个,就跟我前面提到的数据持久化的RDB和AOF有着比密切的关系了。
我先说下为啥要用主从这样的架构模式,前面提到了单机QPS是有上限的,而且Redis的特性就是必须支撑读高并发的,那你一台机器又读又写,这谁顶得住啊,不当人啊!但是你让这个master机器去写,数据同步给别的slave机器,他们都拿去读,分发掉大量的请求那是不是好很多,而且扩容的时候还可以轻松实现水平扩容。
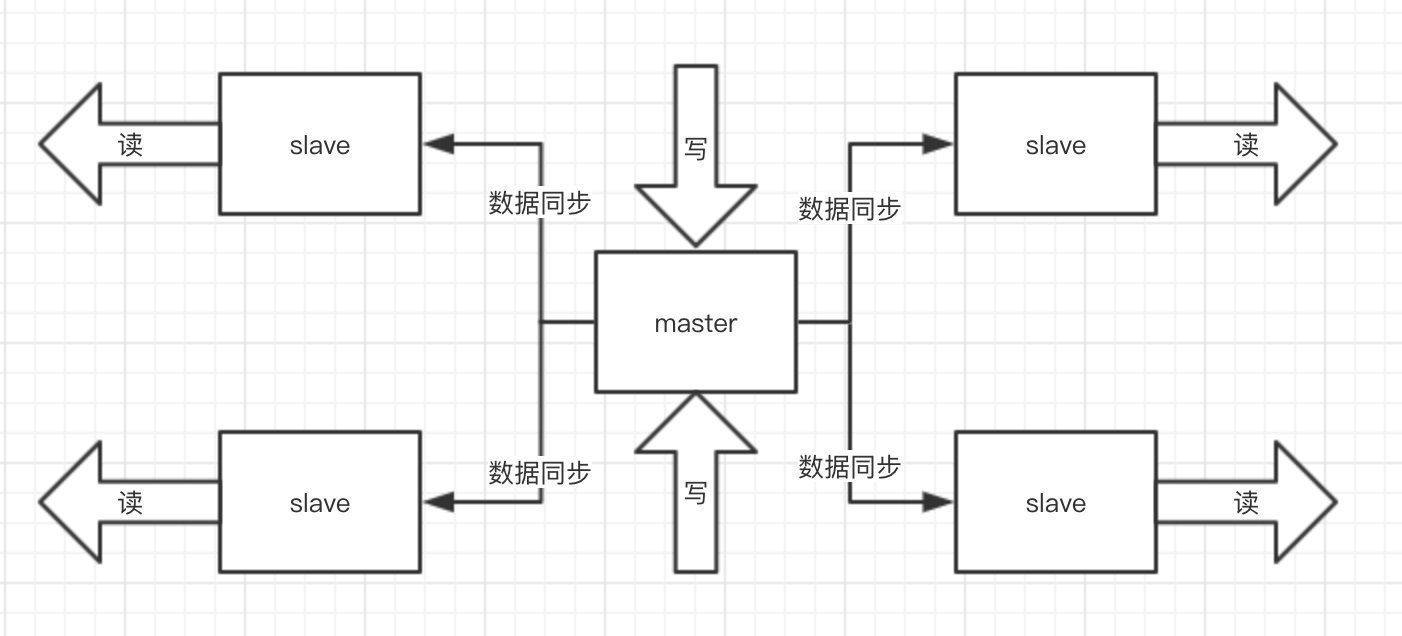
你启动一台slave 的时候,他会发送一个psync命令给master ,如果是这个slave第一次连接到master,他会触发一个全量复制。master就会启动一个线程,生成RDB快照,还会把新的写请求都缓存在内存中,RDB文件生成后,master会将这个RDB发送给slave的,slave拿到之后做的第一件事情就是写进本地的磁盘,然后加载进内存,然后master会把内存里面缓存的那些新命名都发给slave。
我发出来之后来自CSDN的网友:Jian_Shen_Zer 问了个问题:
主从同步的时候,新的slaver进来的时候用RDB,那之后的数据呢?有新的数据进入master怎么同步到slaver啊
敖丙答:笨,AOF嘛,增量的就像MySQL的Binlog一样,把日志增量同步给从服务就好了
key 失效机制
Redis 的 key 可以设置过期时间,过期后 Redis 采用主动和被动结合的失效机制,一个是和 MC 一样在访问时触发被动删除,另一种是定期的主动删除。
定期+惰性+内存淘汰
缓存常见问题
缓存更新方式
这是决定在使用缓存时就该考虑的问题。
缓存的数据在数据源发生变更时需要对缓存进行更新,数据源可能是 DB,也可能是远程服务。更新的方式可以是主动更新。数据源是 DB 时,可以在更新完 DB 后就直接更新缓存。
当数据源不是 DB 而是其他远程服务,可能无法及时主动感知数据变更,这种情况下一般会选择对缓存数据设置失效期,也就是数据不一致的最大容忍时间。
这种场景下,可以选择失效更新,key 不存在或失效时先请求数据源获取最新数据,然后再次缓存,并更新失效期。
但这样做有个问题,如果依赖的远程服务在更新时出现异常,则会导致数据不可用。改进的办法是异步更新,就是当失效时先不清除数据,继续使用旧的数据,然后由异步线程去执行更新任务。这样就避免了失效瞬间的空窗期。另外还有一种纯异步更新方式,定时对数据进行分批更新。实际使用时可以根据业务场景选择更新方式。
数据不一致
第二个问题是数据不一致的问题,可以说只要使用缓存,就要考虑如何面对这个问题。缓存不一致产生的原因一般是主动更新失败,例如更新 DB 后,更新 Redis 因为网络原因请求超时;或者是异步更新失败导致。
解决的办法是,如果服务对耗时不是特别敏感可以增加重试;如果服务对耗时敏感可以通过异步补偿任务来处理失败的更新,或者短期的数据不一致不会影响业务,那么只要下次更新时可以成功,能保证最终一致性就可以。
缓存穿透
缓存穿透。产生这个问题的原因可能是外部的恶意攻击,例如,对用户信息进行了缓存,但恶意攻击者使用不存在的用户id频繁请求接口,导致查询缓存不命中,然后穿透 DB 查询依然不命中。这时会有大量请求穿透缓存访问到 DB。
解决的办法如下。
对不存在的用户,在缓存中保存一个空对象进行标记,防止相同 ID 再次访问 DB。不过有时这个方法并不能很好解决问题,可能导致缓存中存储大量无用数据。
使用 BloomFilter 过滤器,BloomFilter 的特点是存在性检测,如果 BloomFilter 中不存在,那么数据一定不存在;如果 BloomFilter 中存在,实际数据也有可能会不存在。非常适合解决这类的问题。
缓存击穿
缓存击穿,就是某个热点数据失效时,大量针对这个数据的请求会穿透到数据源。
解决这个问题有如下办法。
可以使用互斥锁更新,保证同一个进程中针对同一个数据不会并发请求到 DB,减小 DB 压力。
使用随机退避方式,失效时随机 sleep 一个很短的时间,再次查询,如果失败再执行更新。
针对多个热点 key 同时失效的问题,可以在缓存时使用固定时间加上一个小的随机数,避免大量热点 key 同一时刻失效。
缓存雪崩
缓存雪崩,产生的原因是缓存挂掉,这时所有的请求都会穿透到 DB。
解决方法:
使用快速失败的熔断策略,减少 DB 瞬间压力;
使用主从模式和集群模式来尽量保证缓存服务的高可用。
实际场景中,这两种方法会结合使用。
老朋友都知道为啥我没有大篇幅介绍这个几个点了吧,我在之前的文章实在是写得太详细了,忍不住点赞那种,我这里就不做重复拷贝了。
《吊打面试官》系列-Redis基础
《吊打面试官》系列-缓存雪崩、击穿、穿透
《吊打面试官》系列-Redis哨兵、持久化、主从、手撕LRU
《吊打面试官》系列-Redis终章-凛冬将至、FPX-新王登基
考点与加分项
拿笔记一下!
考点
面试的时候问你缓存,主要是考察缓存特性的理解,对 MC、Redis 的特点和使用方式的掌握。
要知道缓存的使用场景,不同类型缓存的使用方式,例如:
- 对 DB 热点数据进行缓存减少 DB 压力;对依赖的服务进行缓存,提高并发性能;
- 单纯 K-V 缓存的场景可以使用 MC,而需要缓存 list、set 等特殊数据格式,可以使用 Redis;
- 需要缓存一个用户最近播放视频的列表可以使用 Redis 的 list 来保存、需要计算排行榜数据时,可以使用 Redis 的 zset 结构来保存。
要了解 MC 和 Redis 的常用命令,例如原子增减、对不同数据结构进行操作的命令等。
了解 MC 和 Redis 在内存中的存储结构,这对评估使用容量会很有帮助。
了解 MC 和 Redis 的数据失效方式和剔除策略,比如主动触发的定期剔除和被动触发延期剔除
要理解 Redis 的持久化、主从同步与 Cluster 部署的原理,比如 RDB 和 AOF 的实现方式与区别。
要知道缓存穿透、击穿、雪崩分别的异同点以及解决方案。
不管你有没有电商经验我觉得你都应该知道秒杀的具体实现,以及细节点。
……..
欢迎去GitHub补充
加分项
如果想要在面试中获得更好的表现,还应了解下面这些加分项。
是要结合实际应用场景来介绍缓存的使用。例如调用后端服务接口获取信息时,可以使用本地+远程的多级缓存;对于动态排行榜类的场景可以考虑通过 Redis 的 Sorted set 来实现等等。
最好你有过分布式缓存设计和使用经验,例如项目中在什么场景使用过 Redis,使用了什么数据结构,解决哪类的问题;使用 MC 时根据预估值大小调整 McSlab 分配参数等等。
最好可以了解缓存使用中可能产生的问题。比如 Redis 是单线程处理请求,应尽量避免耗时较高的单个请求任务,防止相互影响;Redis 服务应避免和其他 CPU 密集型的进程部署在同一机器;或者禁用 Swap 内存交换,防止 Redis 的缓存数据交换到硬盘上,影响性能。再比如前面提到的 MC 钙化问题等等。
要了解 Redis 的典型应用场景,例如,使用 Redis 来实现分布式锁;使用 Bitmap 来实现 BloomFilter,使用 HyperLogLog 来进行 UV 统计等等。
知道 Redis4.0、5.0 中的新特性,例如支持多播的可持久化消息队列 Stream;通过 Module 系统来进行定制功能扩展等等。
……..
还是那句话欢迎去GitHub补充。
总结
这次是对我Redis系列的总结,这应该是Redis相关的最后一篇文章了,其实四篇看下来的小伙伴很多都从一知半解到了一脸懵逼,哈哈开个玩笑。
我觉得我的方式应该还好,大部分小伙伴还是比较能理解的,这篇之后我就不会写Redis相关的文章了(秒杀看大家想看的热度吧),有啥问题可以微信找我,下个系列写啥?
大家不用急,下个系列前我会发个有意思的文章,是我在公司代码创意大赛拿奖的文章,我觉得还是有点东西,我忍不住分享一下,顺便就在那期发起投票吧哈哈。
我看到很多小伙伴都有评论说想看别的,大概搜集了一下,还没留言的这期赶紧哟:
掘金
愚辛 :想看计算机基础,网络和操作系统那些(FPX牛脾)
cherish君:讲讲dubbo经常遇到的面试题目,太多人喜欢问dubbo?
Java架构养成记:真的很香啊,下一期讲Dubbbo(重点SPI)然后讲MQ好吗
CSDN
小殿下:看完了所有的redis篇 希望可以出ssm
博客园
程然:Dubbo Dubbo
开源中国
linshi2019:这期明显是赶工之作啊
敖丙:这条我回一下,鞭策我,我很喜欢,不过说实话还是希望大家理解下,我双十一熬夜三天了,现在给你们写的时候也是值班回家2点左右了,我一天吃饭工作时间肯定是固定的,想写点东西就只有挤出睡觉时间了,这种产出肯定没周末全情投入写的来的质量高。
其实第一期看过来的小伙伴应该也知道,我在排版,还有很多文案,配图其实我一直都有在改进的,光是名词高亮我都要弄很久,因为怕大家看单一的黑白色调枯燥。
我是真的用心在搞,还是希望大家支持下理解下。
知乎、简书、思否、慕课手记没人看不知道为啥,懂行的老铁可以跟我说一下。
我只想说你们想看的肯定都在我开头和GITHub那个图里吧,问题不大,后面都会写的。
鸣谢
最后感谢下,新浪微博的技术专家张雷。
他于2013年加入新浪微博,作为核心技术人员参与了微博服务化、混合云等多个重点项目,是微博开源的RPC框架Motan的技术负责人,同时也负责微博的Service Mesh方案的研发与推广,专注于高可用架构及服务中间件开发方向。
他负责的Motan框架每天承载着万亿级别的请求调用,是微博平台服务化的基石,每次的突发热点事件、每次的春晚流量高峰,都离不开Motan框架的支撑与保障。此外,他也多次应邀在ArchSummit、WOT、GIAC技术峰会做技术分享。
感谢他对文章部分文案提供的支持和思路。
END
好了各位,以上就是这篇文章的全部内容了,能看到这里的人呀,都是人才。
我后面会每周都更新几篇《吊打面试官》系列和互联网常用技术栈相关的文章。如果你有什么想知道的,也可以留言给我,我一有时间就会写出来,我们共同进步。
非常感谢人才们能看到这里,如果这个文章写得还不错,觉得「敖丙」我有点东西的话 求点赞? 求关注❤️ 求分享? 求留言? 对暖男我来说 非常有用!!!
各位的支持和认可,就是我创作的最大动力,我们下篇文章见!
敖丙 | 文 【原创】【转载请联系本人】


 苏公安网备 32011402010933号