从6.0.0(20) 版本开始,新增高性能GPU排序特性。
XEngine Kit高性能着色器(High Performance Shaders,HPS)特性提供GPU排序能力。相比于其它排序能力,该能力依托于华为Maleoon GPU的软硬结合优化,效率更高。
约束与限制
可通过以下方式查询相关扩展特性是否支持:
对于Vulkan,使用HMS_XEG_EnumerateDeviceExtensionProperties扩展属性查询接口进行查询,如查询结果包含XEG_HPS_RADIX_SORT_EXTENSION_NAME,则表示支持该特性,若查询结果未包含,则表示不支持该特性。
接口说明
以下接口为使用高性能GPU排序所需要使用的接口,关于这些接口的详细说明见接口文档。
| 接口名 | 描述 |
|---|---|
| VKAPI_ATTR VkResult VKAPI_CALL HMS_XEG_CreateHPS (VkDevice device, const XEG_HPSCreateInfo *pCreateInfo, XEG_HPS *pHps) | 创建XEG_HPS实例。 |
| VKAPI_ATTR void VKAPI_CALL HMS_XEG_DestroyHPS (XEG_HPS hps) | 销毁XEG_HPS实例。 |
| VKAPI_ATTR VkResult VKAPI_CALL HMS_XEG_CmdRadixSortHPS (VkCommandBuffer commandBuffer, XEG_HPS hps, const XEG_HPSRadixSortDescription *pDescription) | 录制HPS基数排序命令,使用此接口前需要通过HMS_XEG_EnumerateDeviceExtensionProperties接口查询是否支持XEG_HPS_RADIX_SORT_EXTENSION_NAME扩展。 |
业务流程
-
下面是以Vulkan应用程序渲染为例,说明使用高性能GPU排序的主要业务流程
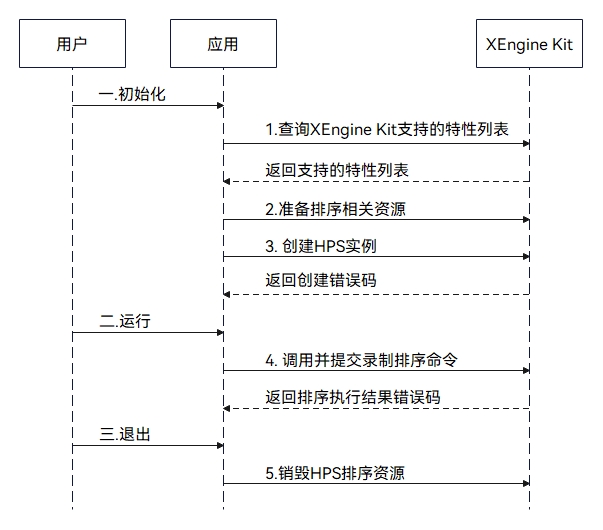
- 应用调用HMS_XEG_EnumerateDeviceExtensionProperties接口获取XEngine Kit支持的扩展属性列表。检查返回列表中是否包含XEG_HPS_RADIX_SORT_EXTENSION_NAME。若不包含,则当前设备不支持此特性,流程终止。
- 应用准备HPS相关资源(keyBuffer、valueBuffer等)。
- 应用调用HMS_XEG_CreateHPS接口创建HPS实例。
- 应用调用HMS_XEG_CmdRadixSortHPS录制排序命令,并提交到GPU队列执行。
- 当不再需要排序时,应用调用HMS_XEG_DestroyHPS接口销毁HPS实例,释放该实例占用的GPU资源。销毁后HPS句柄失效,不可再使用。
[h2]配置项目
编译HAP包时,Native层so需要依赖NDK中的XEngine相关库和头文件。
-
头文件引用
#include "sort_implement.h"
#include <algorithm>
#include <xengine/xeg_vulkan_extension.h>
#include <xengine/xeg_extension_defs.h>
-
CMakeLists.txt添加库依赖
CMakeLists.txt中添加对XEngine动态链接库依赖的代码如下。
find_library(
    # 设置路径变量的名称。
    xengine-lib
    # 指定希望CMake定位的NDK库的名称。
    xengine
)

target_link_libraries(nativerender PUBLIC
    # ...
    ${xengine-lib})
[h2]集成高性能GPU排序(Vulkan)
XEngine 高性能GPU排序可以独立使用。相关代码在Native层实现。
在调用XEngine Kit特性接口前,需要先通过Syscap查询确认您的目标设备支持SystemCapability.Graphic.XEngine系统能力。
-
调用HMS_XEG_EnumerateDeviceExtensionProperties接口,获取XEngine支持的扩展信息,只有在支持XEG_HPS_RADIX_SORT_EXTENSION_NAME扩展时才可以使用高性能GPU排序接口。
// 查询XEngine支持的Vulkan扩展列表 std::vector<std::string> supportedExtensions; uint32_t pPropertyCount; // physicalDevice为Vulkan物理设备,用户需进行初始化 HMS_XEG_EnumerateDeviceExtensionProperties(physicalDevice, &pPropertyCount, nullptr); if (pPropertyCount > 0) { std::vector<XEG_ExtensionProperties> pProperties(pPropertyCount); if (HMS_XEG_EnumerateDeviceExtensionProperties(physicalDevice, &pPropertyCount, &pProperties.front()) == VK_SUCCESS) { for (auto ext : pProperties) { supportedExtensions.push_back(ext.extensionName); } } } // 查询是否支持XEngine高性能GPU排序接口 if (std::find(supportedExtensions.begin(), supportedExtensions.end(), XEG_HPS_RADIX_SORT_EXTENSION_NAME) == supportedExtensions.end()) { // 错误处理 // ... isSupportHPSSort = false; } else { isSupportHPSSort = true; } -
准备HPS相关资源。
VkDevice device;
// ...
VkQueue queue;
struct { // 要被排序的key vks::Buffer keyBuffer; // 与key对应的value vks::Buffer valueBuffer; // 待排序的元素数量 vks::Buffer gsCountIndirectBuffer; } sortBuffers; -
声明实例句柄。
XEG_HPS xegHPS { VK_NULL_HANDLE }; -
调用HMS_XEG_CreateHPS接口,实例化句柄。
// 构造输入描述符 XEG_HPSRadixSort sortEXT{ XEG_STRUCTURE_TYPE_HPS_RADIX_SORT, nullptr }; XEG_HPSCreateInfo info {}; info.sType = XEG_STRUCTURE_TYPE_HPS_CREATE_INFO; info.pNext = &sortEXT; // 实例化句柄 HMS_XEG_CreateHPS(device, &info, &xegHPS); -
构造排序描述符,调用HMS_XEG_CmdRadixSortHPS接口录制排序命令。
VkCommandBufferBeginInfo cmdBufInfo = vks::initializers::commandBufferBeginInfo(); // 录制排序命令 VK_CHECK_RESULT(vkBeginCommandBuffer(drawCmdBuffers[currentBuffer], &cmdBufInfo)); HMS_XEG_CmdRadixSortHPS(drawCmdBuffers[currentBuffer], xegHPS, &sortDescription); VK_CHECK_RESULT(vkEndCommandBuffer(drawCmdBuffers[currentBuffer])); -
提交排序命令。
// 提交command buffer VkResult res; { VkSubmitInfo submitInfo{}; submitInfo.sType = VK_STRUCTURE_TYPE_SUBMIT_INFO; submitInfo.waitSemaphoreCount = 0; submitInfo.signalSemaphoreCount = 0; submitInfo.pSignalSemaphores = nullptr; submitInfo.commandBufferCount = 1; submitInfo.pCommandBuffers = &drawCmdBuffers[currentBuffer]; submitInfo.pWaitSemaphores = nullptr; res = vkQueueSubmit(queue, 1, &submitInfo, nullptr); } if (res != VK_SUCCESS) { // 错误处理 // ... } // 等待执行完毕 vkDeviceWaitIdle(device); -
销毁HPS实例。
if (xegHPS) {
    HMS_XEG_DestroyHPS(xegHPS);
}