模型的加载、编译和推理主要是在native层实现,应用层主要作为数据传递和展示作用。
模型推理之前需要对输入数据进行预处理以匹配模型的输入,同样对于模型的输出也需要做处理获取自己期望的结果。另外SDK中提供了设置模型编译和运行时的配置接口,开发者可根据实际需求选择使用接口。
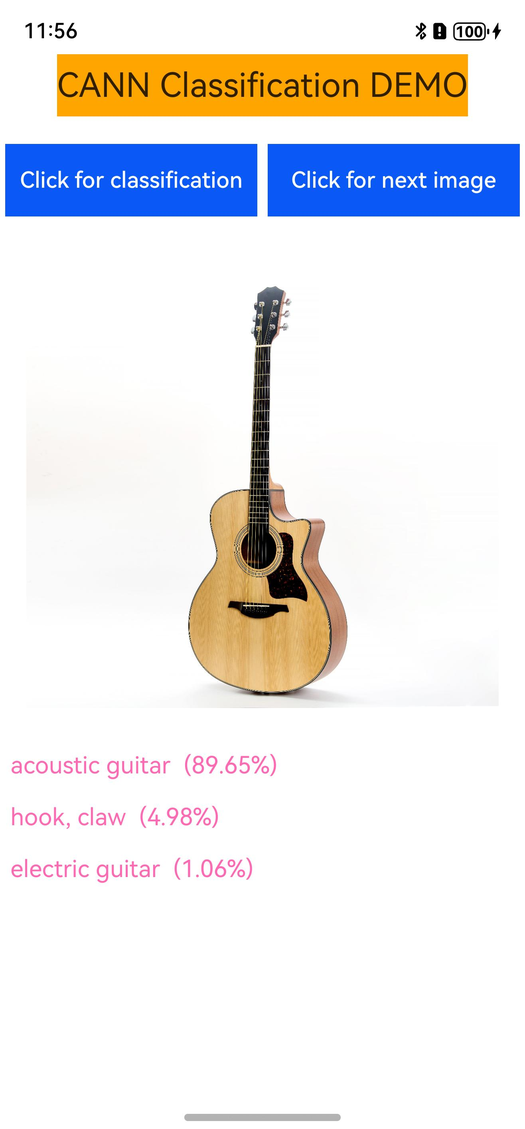
本节阐述同步模式下单模型的使用,从流程上分别阐述每个步骤在应用层和native层的实现和调用。接口请参见API参考,示例请参见SampleCode,本示例支持加载离线模型对图片中的物体进行分类,App运行效果图如下所示。
预置模型
为了让App运行时能够读取到模型文件和处理推理结果,需要先把离线模型和模型对应的结果标签文件预置到工程的“entry/src/main/resources/rawfile”目录中。
本示例所使用的离线模型的转换和生成请参考Caffe模型转换。
加载离线模型
在App应用创建时加载模型和读取结果标签文件。
调用NAPI层的LoadModel函数,读取模型的buffer。
(可选)根据需要调用HMS_HiAIOptions_SetOmOptions接口,打开维测功能(如Profiling)。
把模型buffer传递给HIAIModelManager类的HIAIModelManager::LoadModelFromBuffer接口,该接口调用OH_NNCompilation_ConstructWithOfflineModelBuffer创建模型的编译实例。
设置模型的deviceID。
size_t deviceID = 0; const size_t *allDevicesID = nullptr; uint32_t deviceCount = 0; // 获取所有已连接设备的ID OH_NN_ReturnCode ret = OH_NNDevice_GetAllDevicesID(&allDevicesID, &deviceCount); if (ret != OH_NN_SUCCESS || allDevicesID == nullptr) { OH_LOG_ERROR(LOG_APP, "OH_NNDevice_GetAllDevicesID failed"); return OH_NN_FAILED; } // 获取设备名为HIAI_F的设备ID for (uint32_t i = 0; i < deviceCount; i++) { const char *name = nullptr; // 获取指定设备的名称 ret = OH_NNDevice_GetName(allDevicesID[i], &name); if (ret != OH_NN_SUCCESS || name == nullptr) { OH_LOG_ERROR(LOG_APP, "OH_NNDevice_GetName failed"); return OH_NN_FAILED; } if (std::string(name) == "HIAI_F") { deviceID = allDevicesID[i]; break; } } // modelData和modelSize为模型的内存地址和大小, compilation的创建可参考CANN Kit Codelab OH_NNCompilation *compilation = OH_NNCompilation_ConstructWithOfflineModelBuffer(modelData, modelSize); // 设置编译器的设备id为HIAI_F ret = OH_NNCompilation_SetDevice(compilation, deviceID); if (ret != OH_NN_SUCCESS) { OH_LOG_ERROR(LOG_APP, "OH_NNCompilation_SetDevice failed"); return OH_NN_FAILED; }调用OH_NNCompilation_Build,执行模型编译。
调用OH_NNExecutor_Construct,创建模型执行器。
调用OH_NNCompilation_Destroy,释放模型编译实例。
上述流程可参见SampleCode中entry/src/main/cpp/Classification.cpp文件中的LoadModel函数和entry/src/main/cpp/HIAIModelManager.cpp中的HIAIModelManager::LoadModelFromBuffer函数。
输入输出数据准备
处理模型的输入,例如示例中模型的输入为1*3*227*227格式Float类型的数据,需要把输入的图片转成该格式后传递到NAPI层。
创建模型的输入和输出Tensor,并把应用层传递的数据填充到输入的Tensor中。
// 创建输入数据
size_t inputCount = 0;
std::vector<NN_Tensor*> inputTensors;
OH_NN_ReturnCode ret = OH_NNExecutor_GetInputCount(executor, &inputCount); // 创建executor可参考CANN Kit Codelab
if (ret != OH_NN_SUCCESS || inputCount != inputData.size()) { // inputData为开发者构造的输入数据
    OH_LOG_ERROR(LOG_APP, "OH_NNExecutor_GetInputCount failed, size mismatch");
    return OH_NN_FAILED;
}
for (size_t i = 0; i < inputCount; ++i) {
    NN_TensorDesc *tensorDesc = OH_NNExecutor_CreateInputTensorDesc(executor, i); // 创建executor可参考CANN Kit Codelab
    NN_Tensor *tensor = OH_NNTensor_Create(deviceID, tensorDesc); // deviceID的获取方式可参考加载离线模型的步骤3或者CANN Kit Codelab
    if (tensor != nullptr) {
        inputTensors.push_back(tensor);
    }
    OH_NNTensorDesc_Destroy(&tensorDesc);
}
if (inputTensors.size() != inputCount) {
    OH_LOG_ERROR(LOG_APP, "input size mismatch");
    DestroyTensors(inputTensors); // DestroyTensors为释放tensor内存操作函数,具体实现可参考CANN Kit Codelab
    return OH_NN_FAILED;
}

// 初始化输入数据
for (size_t i = 0; i < inputTensors.size(); ++i) {
    void *data = OH_NNTensor_GetDataBuffer(inputTensors[i]);
    size_t dataSize = 0;
    OH_NNTensor_GetSize(inputTensors[i], &dataSize);
    if (data == nullptr || dataSize != inputData[i].size()) { // inputData为模型的输入数据,使用方式可参考CANN Kit Codelab
        OH_LOG_ERROR(LOG_APP, "invalid data or dataSize");
        return OH_NN_FAILED;
    }
    memcpy(data, inputData[i].data(), inputData[i].size()); // inputData为模型的输入数据,使用方式可参考CANN Kit Codelab
}

// 创建输出数据,与输入数据的创建方式类似
size_t outputCount = 0;
std::vector<NN_Tensor*> outputTensors;
ret = OH_NNExecutor_GetOutputCount(executor, &outputCount); // 创建executor可参考CANN Kit Codelab
if (ret != OH_NN_SUCCESS) {
    OH_LOG_ERROR(LOG_APP, "OH_NNExecutor_GetOutputCount failed");
    DestroyTensors(inputTensors); // DestroyTensors为释放tensor内存操作函数,具体实现可参考CANN Kit Codelab
    return OH_NN_FAILED;
}
for (size_t i = 0; i < outputCount; i++) {
    NN_TensorDesc *tensorDesc = OH_NNExecutor_CreateOutputTensorDesc(executor, i); // 创建executor可参考CANN Kit Codelab
    NN_Tensor *tensor = OH_NNTensor_Create(deviceID, tensorDesc); // deviceID的获取方式可参考加载离线模型的步骤3或者CANN Kit Codelab
    if (tensor != nullptr) {
        outputTensors.push_back(tensor);
    }
    OH_NNTensorDesc_Destroy(&tensorDesc);
}
if (outputTensors.size() != outputCount) {
    DestroyTensors(inputTensors); // DestroyTensors为释放tensor内存操作函数,具体实现可参考CANN Kit Codelab
    DestroyTensors(outputTensors); // DestroyTensors为释放tensor内存操作函数,具体实现可参考CANN Kit Codelab
    OH_LOG_ERROR(LOG_APP, "output size mismatch");
    return OH_NN_FAILED;
}
上述流程可参见SampleCode中"entry/src/main/cpp/Classification.cpp"文件中的InitIOTensors函数和"entry/src/main/cpp/HIAIModelManager.cpp"中的HIAIModelManager::InitIOTensors函数。
同步推理离线模型

如果不更换模型,则首次编译加载完成后可多次推理,即一次编译加载,多次推理。
调用OH_NNExecutor_RunSync,完成模型的同步推理。
可参见SampleCode中"entry/src/main/cpp/Classification.cpp"文件中的RunModel函数和"entry/src/main/cpp/HIAIModelManager.cpp"中的HIAIModelManager::RunModel函数。
模型输出后处理
调用OH_NNTensor_GetDataBuffer,获取输出的Tensor,在输出Tensor中会得到模型的输出数据。
对输出数据进行相应的处理可得到期望的结果。
例如本示例demo中模型的输出是1000个label的概率,期望得到这1000个结果中概率最大的三个标签。
销毁申请的Tensor资源和执行器实例。
上述流程可参见SampleCode中"entry/src/main/cpp/Classification.cpp"文件中的GetResult、UnloadModel函数和"entry/src/main/cpp/HIAIModelManager.cpp"中的HIAIModelManager::GetResult、HIAIModelManager::UnloadModel函数。
